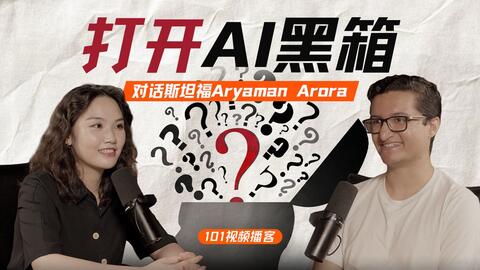
看影片(在新分頁開啟原站)連到 Bilibili・硅谷101
其他版本:YouTube 版(在新分頁開啟)
摘要
探討大模型內部推理過程與可解釋性,透過實驗展示模型如何處理隱含判斷。觀眾能了解思維鏈與 AI 人格等概念,並認識如何觀察與干預模型決策。
This video discusses AI interpretability and alignment, exploring how large models make internal judgments and reasoning processes.
這筆內容還沒有取得字幕或內文,這段摘要只根據標題與說明欄產生,可能不夠準確;實際內容請以原站為準。
適合誰看
對 AI 可解釋性、機器學習原理或模型行為感興趣的研究者與開發者。
摘要依據
- 依據
- 標題與說明欄(還沒有取得字幕或內文)
為什麼排在這裡
- 人氣
- 0.78
- 新鮮
- 0.85
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Interpretability: Understanding how AI models think影片 ・ Anthropic ・ 59 分鐘 ・
- Understanding the inner thoughts of AI影片 ・ Google DeepMind ・ 53 分鐘 ・
- AI:AM Highlights: Exploring the J-Space, AI Superforecasters, SambaNova's Chips, & LTX Video GenPodcast ・ The Cognitive Revolution ・ 2 小時 7 分 ・
- The Dark Matter of AI [Mechanistic Interpretability]影片 ・ Welch Labs ・ 24 分鐘 ・
- AI的安全对齐,可能是个幻觉影片 ・ 程序员老王 ・
- 【生成式AI導論 2024】第11講:大型語言模型在「想」什麼呢? — 淺談大型語言模型的可解釋性影片 ・ Hung-yi Lee ・ 45 分鐘 ・
這個來源最近的內容
摘要由 AI 根據標題與說明欄產生(還沒有取得原文),可能有誤;完整內容請看原站。看影片(在新分頁開啟原站)