讀原文(在新分頁開啟原站)連到 Doug Turnbull
摘要
深入探討向量搜尋資料庫在資料更新時的技術挑戰,分析 HNSW 演算法如何處理刪除與新增,並比較不同系統(如 Lucene、Vespa、Weaviate)的實作策略與權衡。讀者能了解向量資料庫在生產環境中面對寫入負載時的實際表現,並掌握如何進行有效的影測與評估。
This article analyzes the technical challenges of updating vector databases, comparing HNSW implementations across major systems and emphasizing the need for realistic workload testing.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- HNSW 演算法通常透過刪除舊向量再插入新向量來處理更新。
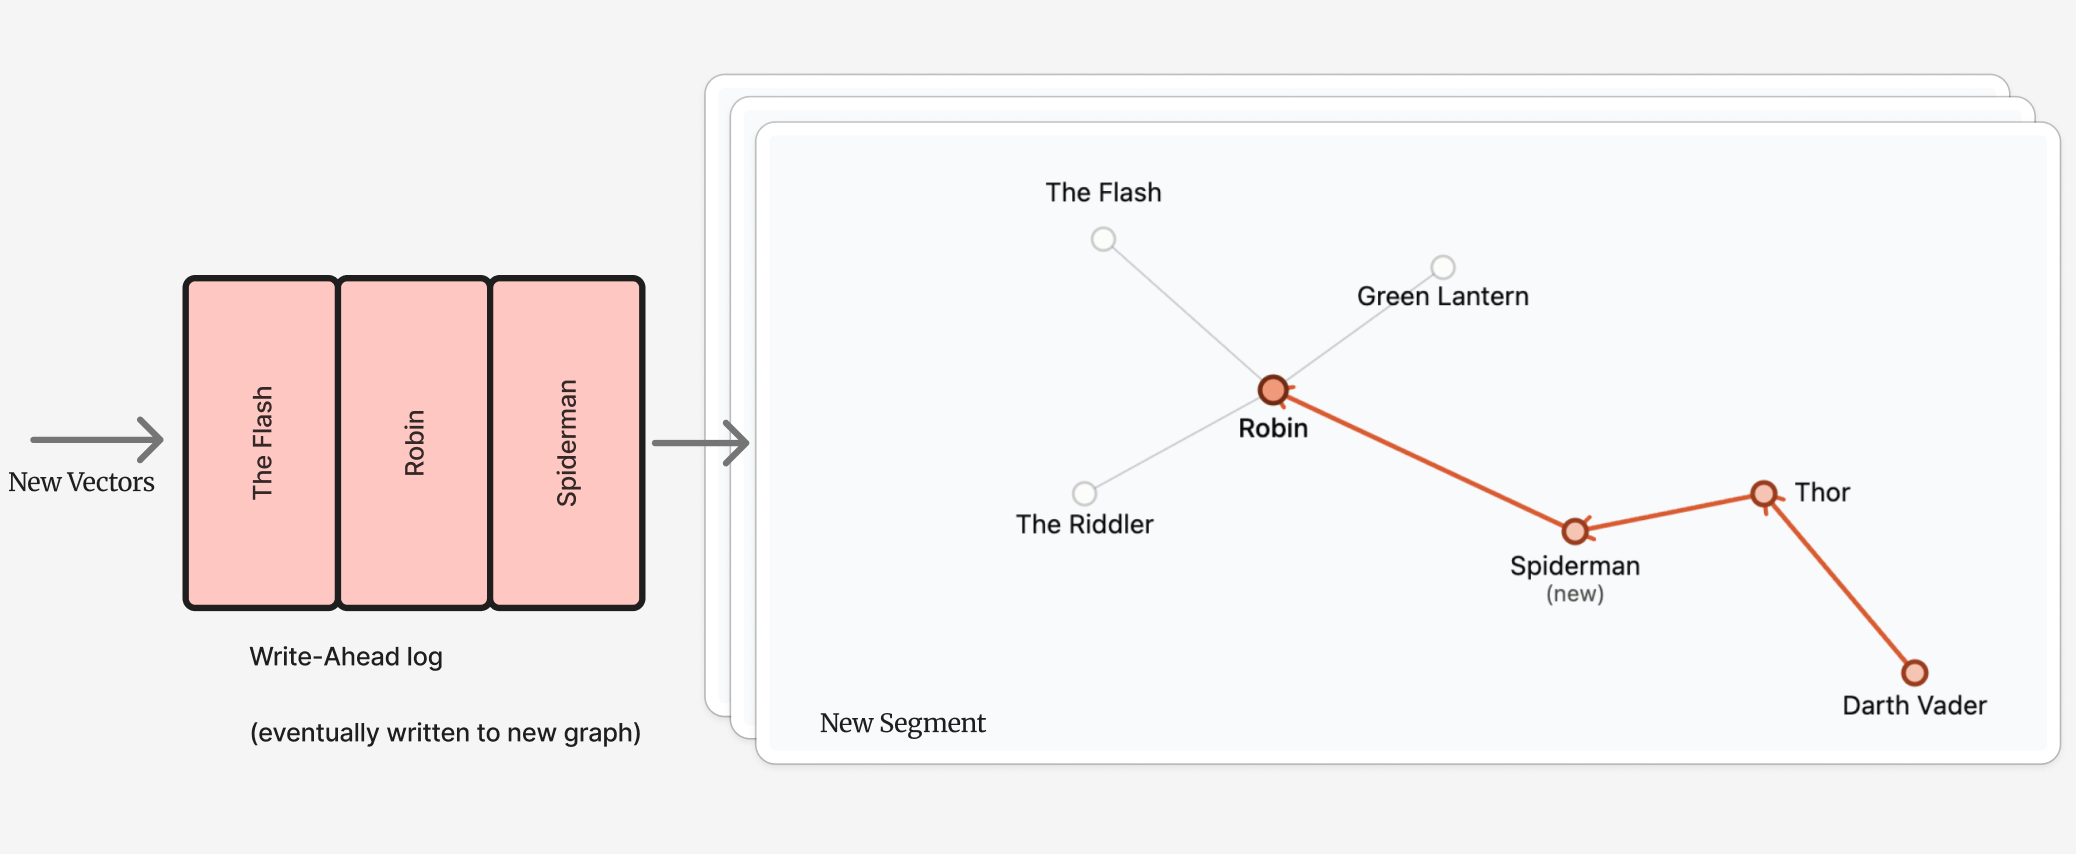
- 多數資料庫會建立多個圖段並行搜尋,而非即時更新單一圖。
- 評估向量資料庫必須模擬實際寫入流量,而非僅依賴靜態測試。
提到的工具與公司
- HNSW
- Lucene
- Vespa
- Weaviate
- QDrant
- Milvus
- Elasticsearch
適合誰看
正在評估或建置向量搜尋資料庫的開發人員與架構師。
摘要依據
- 講者
- Doug Turnbull
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.82
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Scaling HNSWs文章 ・ antirez(部落格)
- Vectors Week: become a savier vector db customer文章 ・ Doug Turnbull
- Querying 3 billion vectors文章 ・ Vicki Boykis
- Write, Change, Recall, Forget: MongoDB's Pete Johnson on How Retrieval Drives Agent PerformancePodcast ・ The Cognitive Revolution ・ 1 小時 37 分
- Implementing Hybrid Semantic + Lexical Search文章 ・ Kent C. Dodds Blog
- Do You Need A Vector Database in 2026? (ft Arjun Patel)Podcast ・ Tool Use - AI Conversations ・ 59 分鐘
這個來源最近的內容
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)