1文章進階EN
Don't classify. Hallucinate!
介紹一種用大模型生成虛假分類再透過向量搜尋對照真實詞彙的技術,解決限制輸出選項昂貴的問題。讀者可學習如何用低成本小模型配合嵌入向量完成分類任務。
依人氣
介紹一種用大模型生成虛假分類再透過向量搜尋對照真實詞彙的技術,解決限制輸出選項昂貴的問題。讀者可學習如何用低成本小模型配合嵌入向量完成分類任務。
邀請讀者與 Adam Hevenor 一起從第一原理學習向量資料庫的使用與選購方法。內容涵蓋如何系統化選擇資料庫、避免混合搜尋的常見錯誤,以及透過量化與聚類等技術自製向量資料庫。看完能掌握向量搜尋的核心概念與實際應用技巧。
探討搜尋與檢索職位在 2026 年的發展趨勢,強調軟體工程基礎的重要性,並說明 LLM、Agent 與 Embedding 已成為市場常規需求。讀者將了解如何評估這些技術的優缺點,以及建立有效評估系統與持續參與社群的關鍵策略。
Doug Turnbull 分享經驗,指出對於小規模文件集合,使用 Numpy 直接暴力計算點積比建立向量資料庫更簡單高效。讀者可學習在特定條件下如何透過原生程式庫最佳化搜尋效能,避免過度複雜的架構。
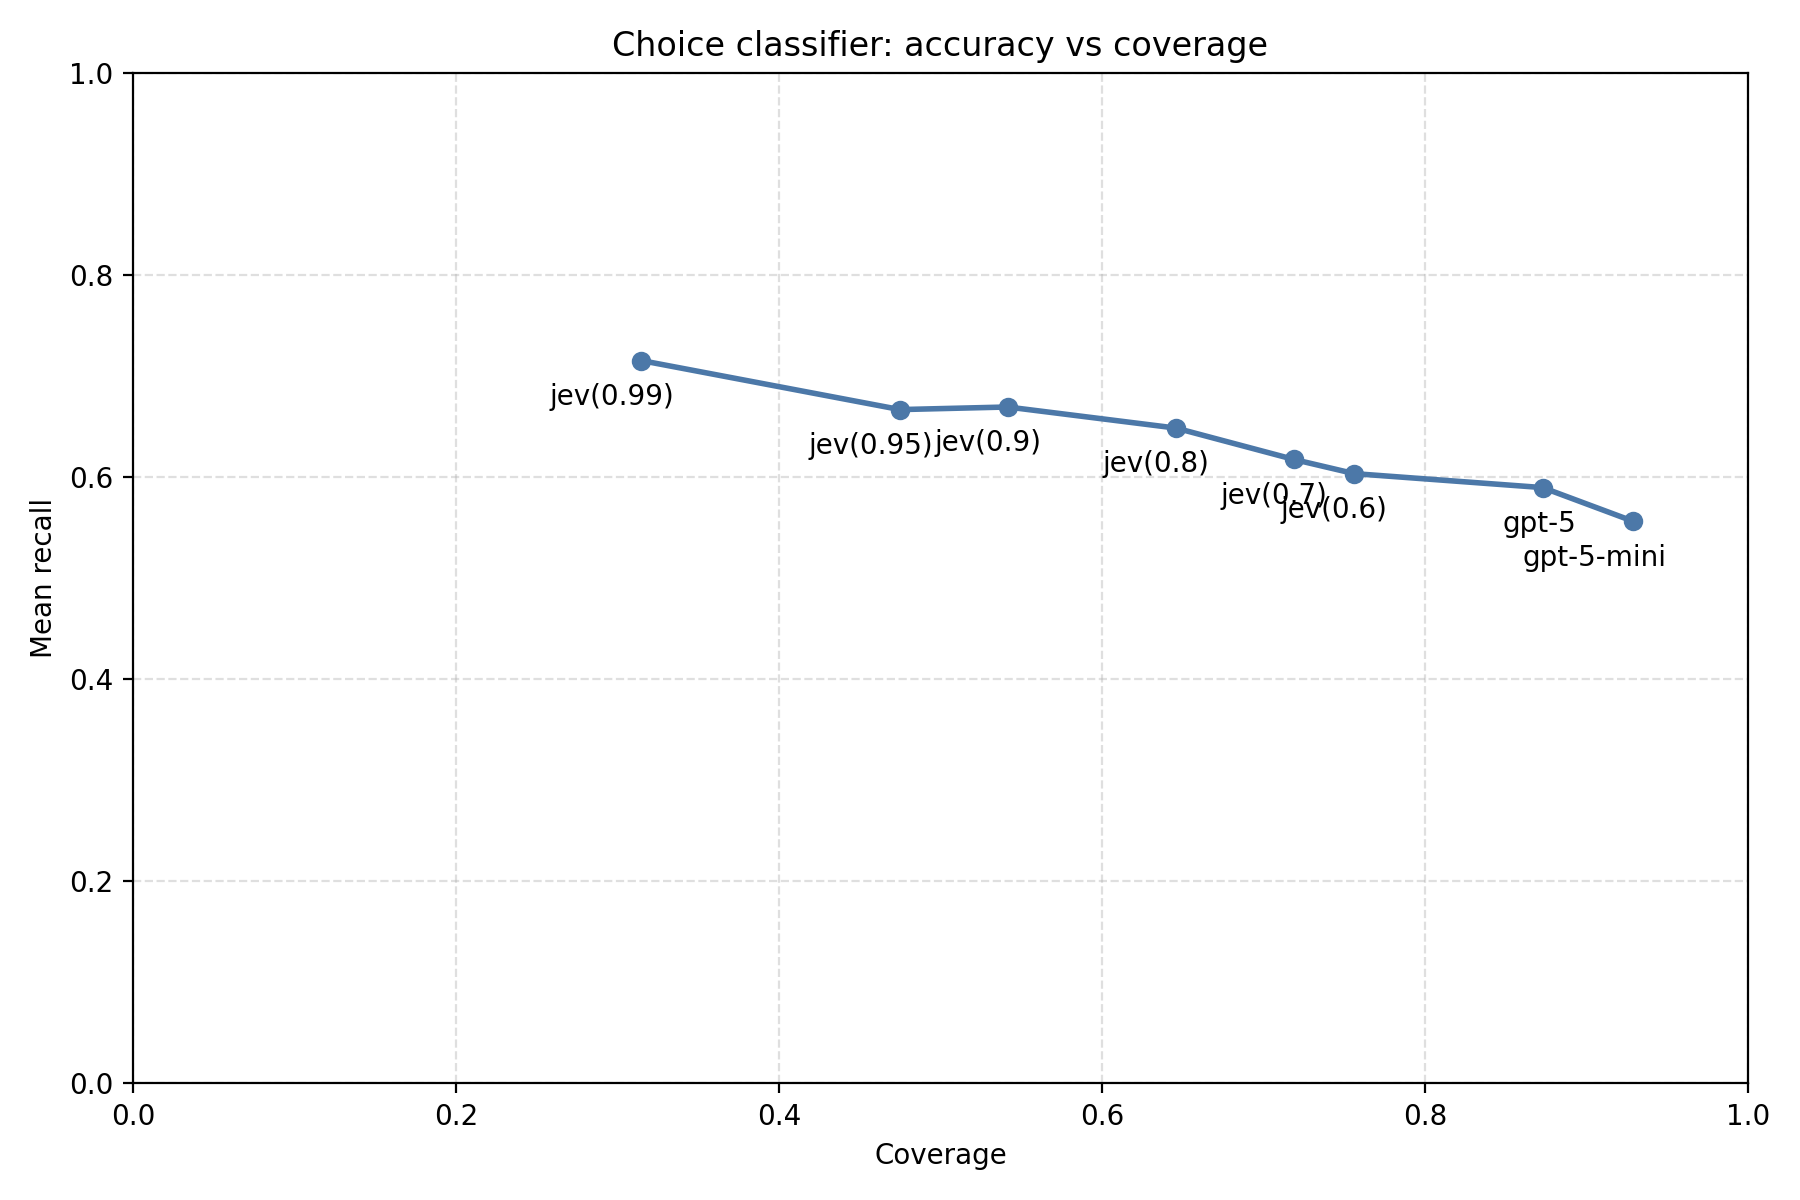
作者測試 JEV 在查詢分類任務上的表現,並與 GPT-5 等 LLM 進行比較。文章強調在搜尋中應優先追求準確度而非召回率,並介紹了 JEV 如何透過設定置信度閾值來處理模糊查詢,同時討論了階層式查詢分類的策略。
指出新成立的 AI 團隊常因忽視評估與檢索架構而失敗,強調應像科學家般透過評估驗證假設,並理解檢索不僅是分塊,更需關注元資料與查詢理解。讀者可學習如何建立有效的評估機制與檢索策略,避免在 AI 專案初期投入錯誤方向。
依發布時間
作者測試 JEV 在查詢分類任務上的表現,並與 GPT-5 等 LLM 進行比較。文章強調在搜尋中應優先追求準確度而非召回率,並介紹了 JEV 如何透過設定置信度閾值來處理模糊查詢,同時討論了階層式查詢分類的策略。
探討搜尋與檢索職位在 2026 年的發展趨勢,強調軟體工程基礎的重要性,並說明 LLM、Agent 與 Embedding 已成為市場常規需求。讀者將了解如何評估這些技術的優缺點,以及建立有效評估系統與持續參與社群的關鍵策略。
指出新成立的 AI 團隊常因忽視評估與檢索架構而失敗,強調應像科學家般透過評估驗證假設,並理解檢索不僅是分塊,更需關注元資料與查詢理解。讀者可學習如何建立有效的評估機制與檢索策略,避免在 AI 專案初期投入錯誤方向。
介紹一種用大模型生成虛假分類再透過向量搜尋對照真實詞彙的技術,解決限制輸出選項昂貴的問題。讀者可學習如何用低成本小模型配合嵌入向量完成分類任務。
邀請讀者與 Adam Hevenor 一起從第一原理學習向量資料庫的使用與選購方法。內容涵蓋如何系統化選擇資料庫、避免混合搜尋的常見錯誤,以及透過量化與聚類等技術自製向量資料庫。看完能掌握向量搜尋的核心概念與實際應用技巧。
Doug Turnbull 分享經驗,指出對於小規模文件集合,使用 Numpy 直接暴力計算點積比建立向量資料庫更簡單高效。讀者可學習在特定條件下如何透過原生程式庫最佳化搜尋效能,避免過度複雜的架構。