讀原文(在新分頁開啟原站)連到 Dwarkesh Patel
摘要
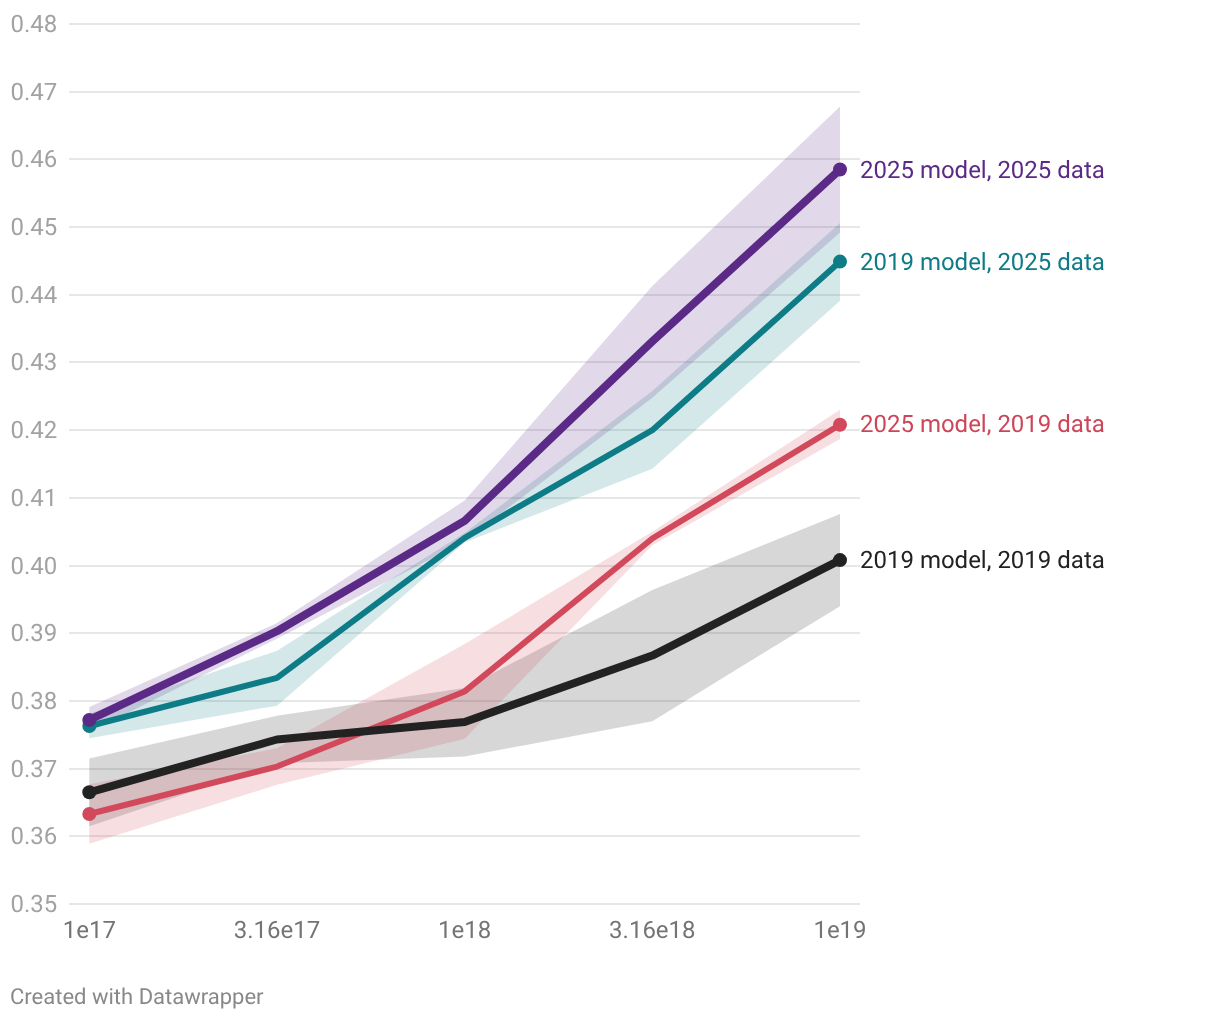
本研究分析了 2019 至 2025 年間 AI 訓練進步中資料與模型改進的貢獻。結果顯示,資料改進帶來的計算效率增益比模型改進高出 3.24 倍,且兩者增益 largely 獨立,資料工程(如資料篩選與構建)在提升模型能力上佔據主導地位。
This study analyzes the contributions of data and model improvements to AI training progress from 2019 to 2025. Results show that data improvements brought 3.24x more compute efficiency gains than model improvements, and their gains largely remained independent, with data engineering playing a major…
重點
- 2019 至 2025 年,資料改進帶來的計算效率增益比模型改進高出 3.24 倍。
- 資料改進與模型改進的增益 largely 獨立,兩者對最終能力的貢獻 largely 獨立。
- 88% 的 OLMES 分數變化可由資料與模型改進的加性效應解釋。
提到的工具與公司
- OLMES
- GPT-2
- OLMo-2
- UltraFineWeb
- OpenWebText
- FlashAttention
- MoE
適合誰看
AI 研究者、程式開發者、資料工程師或對 AI 訓練效率感興趣的讀者。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.92
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- 【生成式AI導論 2024】第3講:訓練不了人工智慧?你可以訓練你自己 (上) — 神奇咒語與提供更多資訊影片 ・ Hung-yi Lee ・ 35 分鐘(在新分頁開啟原站)
- Baking a Model文章 ・ Kent Beck(部落格)
- Training | AI Coding Dictionary文章 ・ AI Hero(Matt Pocock)
- 视频生成·下:模型和训练【论文精读·55】影片 ・ 跟李沐学AI ・ 1 小時 3 分(在新分頁開啟原站)
- SAM 3: Under the hood of the data engine | AI at Meta影片 ・ AI at Meta ・ 2 分鐘(在新分頁開啟原站)
- The data black hole at the center of AI文章 ・ Dwarkesh Patel ・ 12 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)