Let's build GPT: from scratch, in code, spelled out.(在新分頁開啟原站)
Andrej Karpathy 在影片中詳細拆解了如何從零開始手動編寫 GPT 模型。他解釋了如何將注意力機制與自回歸語言建模結合,並展示了利用 GitHub Copilot 輔助開發的過程。
796 萬次觀看
※ 摘要僅根據標題與說明
Building LLMs from Scratch ・ 43 筆內容
自己寫 tokenizer、模型與訓練迴圈,從零做出一個小型 GPT。
也叫做:從零打造、從零實作、从零实现、from scratch、nanoGPT、build GPT、tokenizer、預訓練、pretraining、pre-training
由淺入深:入門 → 進階 → 高階
Stanford CS336 Language Modeling from Scratch | Spring 2026 | Guest Lecture: Dan Fu(在新分頁開啟原站)
Stanford Online1 小時 12 分○ 無原文
Building an AI Text Detector From Scratch(在新分頁開啟原站)
Sebastian Raschka(部落格)○ 無原文
Sebastian Raschka1 小時 37 分○ 無原文
Llama 3.1论文精读 · 2. 预训练数据【论文精读·54】(在新分頁開啟原站)
跟李沐学AI24 分鐘○ 無原文
Eric Jang – Building AlphaGo from scratch
Dwarkesh Podcast2 小時 37 分● 有原文
Let's build GPT: from scratch, in code, spelled out.(在新分頁開啟原站)
Andrej Karpathy1 小時 56 分○ 無原文
Sebastian Raschka1 小時 27 分○ 無原文
Inside the Model Factory — Eiso Kant, Poolside AI(在新分頁開啟原站)
Latent Space1 小時 55 分○ 無原文
依相關、人氣、新鮮度綜合排序;站長推薦的加成
Andrej Karpathy 在影片中詳細拆解了如何從零開始手動編寫 GPT 模型。他解釋了如何將注意力機制與自回歸語言建模結合,並展示了利用 GitHub Copilot 輔助開發的過程。
※ 摘要僅根據標題與說明
介紹 Krishna Prasad Srinivasan 如何從零開始,使用 3B 狀態空間視覺模型,詳細展示訓練過程與架構。
※ 摘要僅根據標題與說明
Stanford 線上課程《Language Modeling from Scratch》的 Spring 2026 版,由 Dan Fu 主講,深入探討從零開始構建語言模型的基礎原理。
※ 摘要僅根據標題與說明
介紹如何從零開始,利用 Python 和 TensorFlow 自行開發一個 AI 文字檢測器,涵蓋了資料準備、模型訓練、本地部署及 RLVR 等完整流程。
※ 摘要僅根據標題與說明
介紹如何從零開始構建推理模型,涵蓋載入預訓練模型、文生文機制以及 KV 快取以提升效率。
※ 摘要僅根據標題與說明
Stanford CS336 第 17 課介紹如何從頭開始學習語言模型,專注於多模態下的指令跟隨。
※ 摘要僅根據標題與說明
影片由 Matt Pocock 主持,介紹如何從零開始建立全新專案,內容涵蓋開發流程與實作步驟。
※ 摘要僅根據標題與說明
探討從零開始構建推理模型的動機與程式碼設定,並介紹如何安裝 Python 與 PyTorch。
※ 摘要僅根據標題與說明
介紹如何建立不消耗使用量的 GPT-6 Astra 自動化流程。
※ 摘要僅根據標題與說明
介紹如何從零開始構建一個數學驗證器,用於評估大語言模型的推理能力,並可重複用於有可驗證獎勵的強化學習訓練。
※ 摘要僅根據標題與說明
本影片由 Andrej Karpathy 親自演示如何從零開始重構 GPT-2 (124M) 模型。內容涵蓋了從建立基礎網路結構、最佳化訓練速度,到依照原始論文設定超引數並執行訓練的完整過程。
※ 摘要僅根據標題與說明
探討從零開始在 Python 與 PyTorch 中實作 LLM 架構的經驗,透過深入檢視注意力機制、正規化層及配置檔案,讓讀者理解現代 LLM 的運作細節。
※ 摘要僅根據標題與說明
本訪談介紹 Eric Jang 如何從零開始構建 AlphaGo,並探討其對未來 AI 研究的啟示。訪談指出 AlphaGo 是理解智慧本質(如搜尋、經驗學習、自我對弈)的最佳範例,並展示了如何利用現代工具將複雜的決策問題簡化為可計算的正…
本影片由 Andrej Karpathy 親自演示如何從頭建立 GPT 系列所使用的 Tokenizer 模型。他深入探討了 Tokenizer 在大型語言模型中的核心地位,並指出許多模型異常行為皆源於此。
※ 摘要僅根據標題與說明
介紹如何從零開始構建一個自定義的語言模型,並深入探討指令精調(Instruction Finetuning)的具體步驟與方法。
※ 摘要僅根據標題與說明
介紹如何從零開始構建一個自定義的語言模型,並專注於分類任務的細調方法。
※ 摘要僅根據標題與說明
介紹如何從頭開始用未標記資料訓練大型語言模型,內容聚焦於基礎原理與實作步驟。
※ 摘要僅根據標題與說明
深入探討推理時擴充套件技術,涵蓋溫度調控、Top-p 過濾及多項式取樣以生成多樣化回答,並透過自一致性方法提升大語言模型回答的準確性。
※ 摘要僅根據標題與說明
教導讀者如何從零開始,使用純 Python 建構自主體 RAG 系統,無需依賴重型框架。內容涵蓋建立可呼叫的工具、連線 Pydantic AI 進行工具呼叫與自我修正,並涵蓋從核心程式設計到生產部署的全流程。
※ 摘要僅根據標題與說明
依發布時間
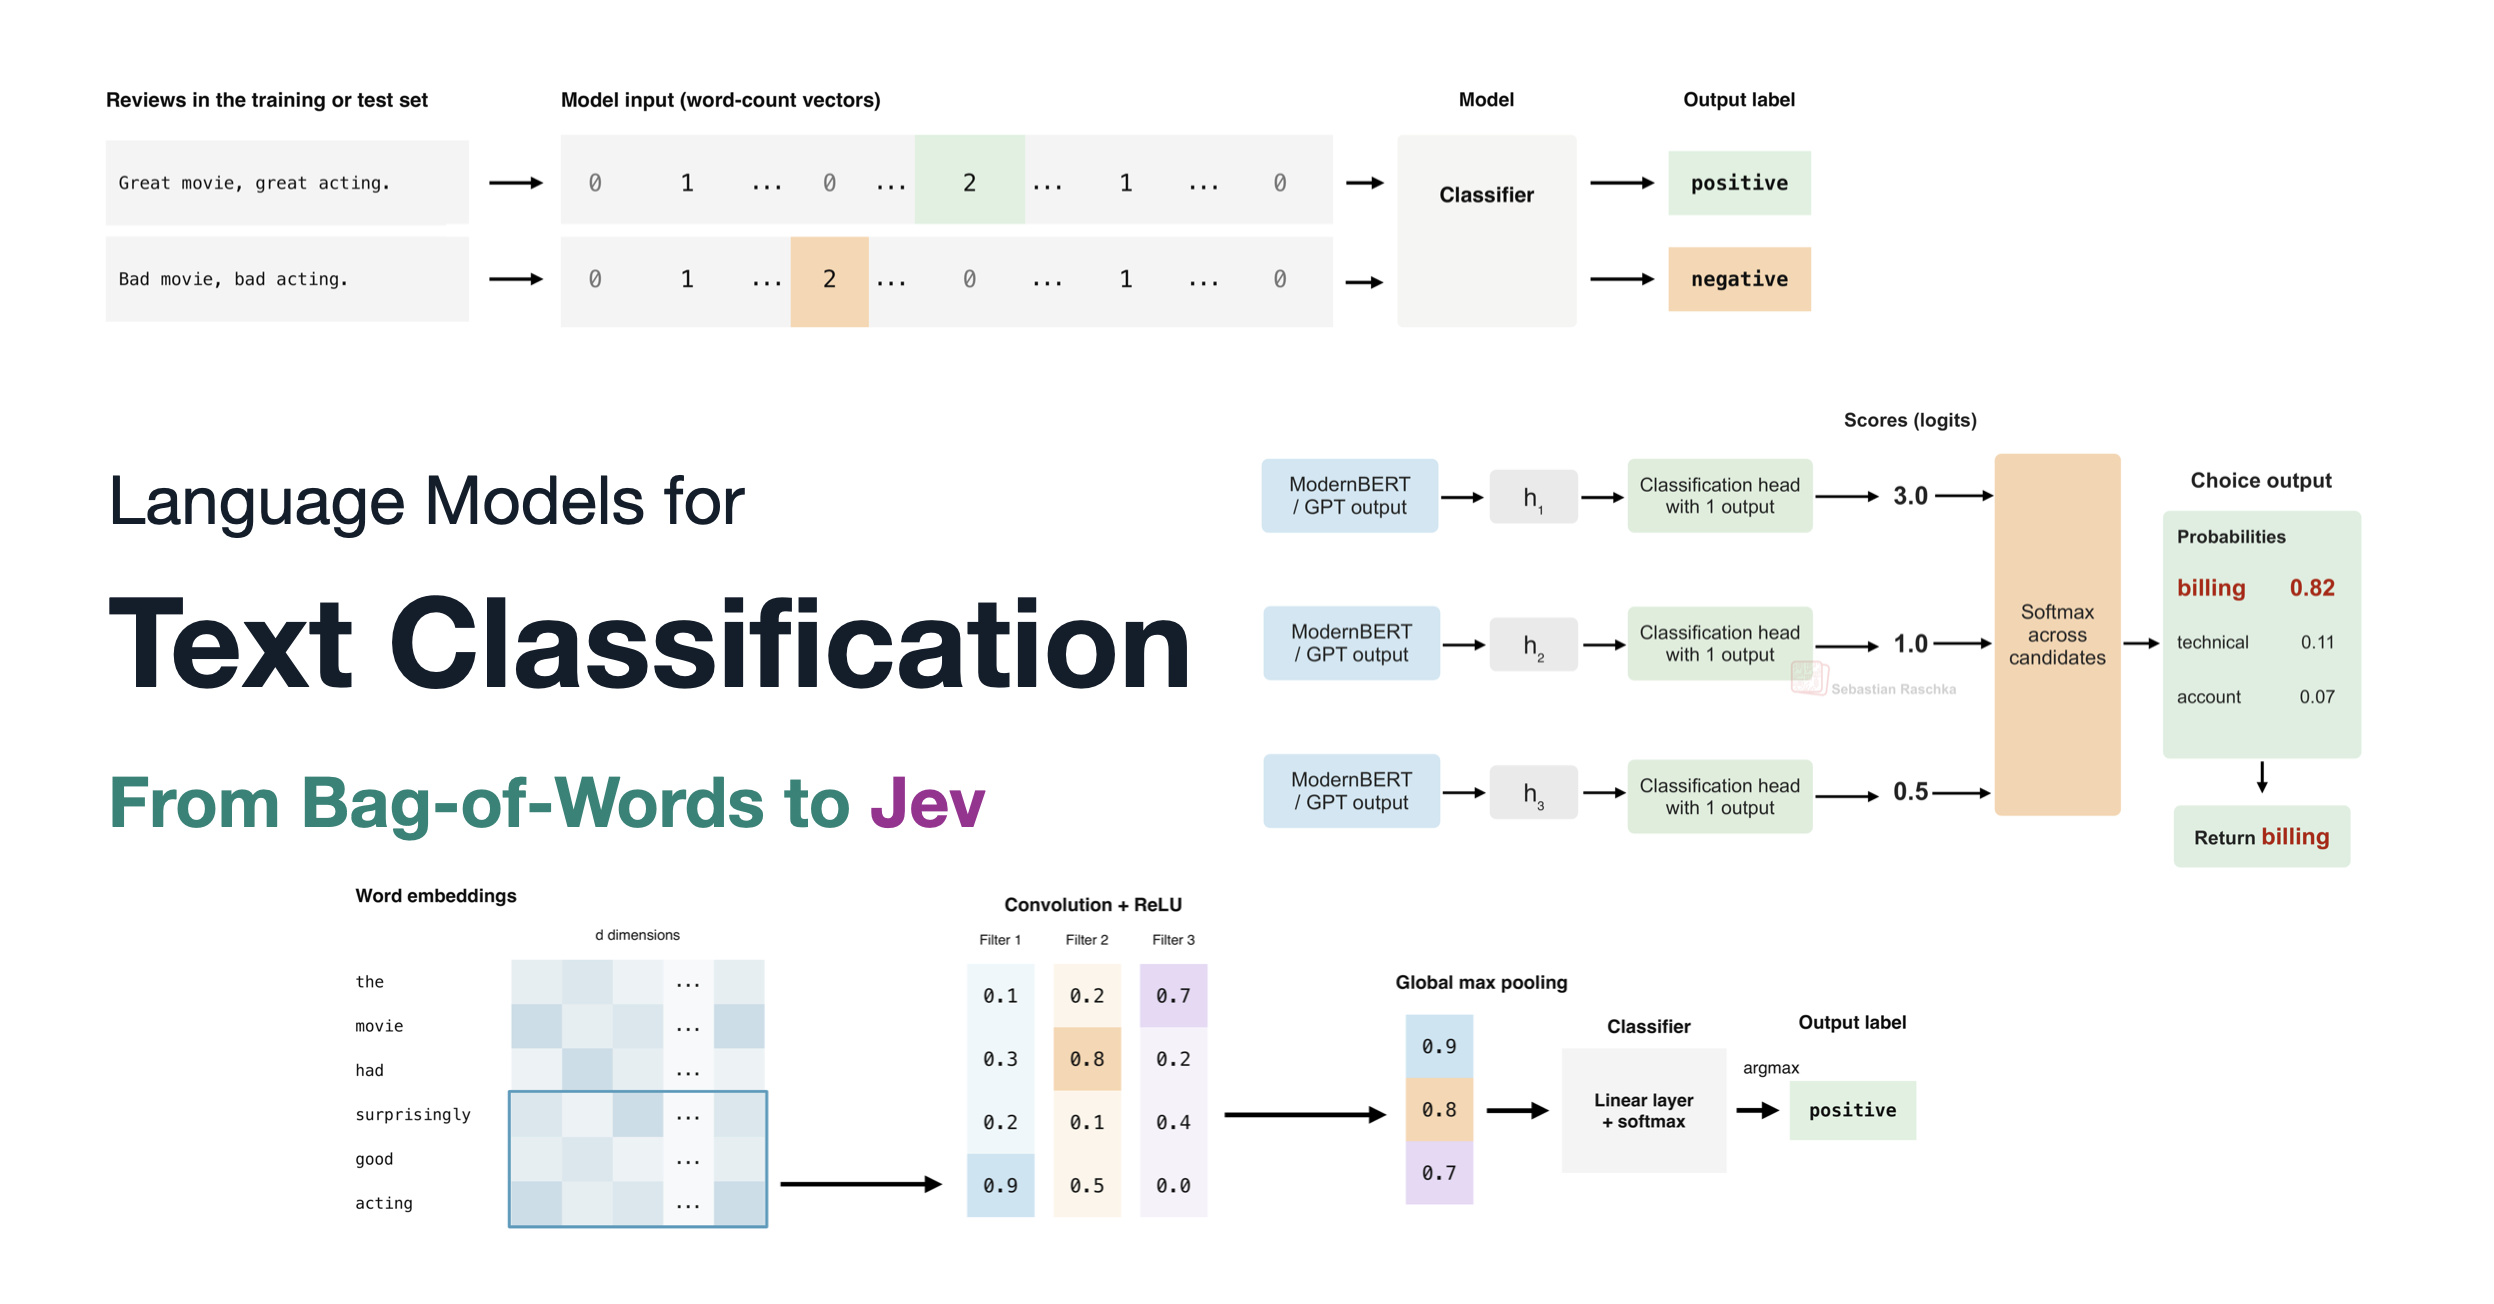
探討了「Jev」模型,一種專為文字分類設計的輕量級語言模型。作者指出,雖然傳統方法如 Bag-of-Words 和深度學習(RNN/CNN)已存在,但 Jev 在處理特定分類任務時比通用大語言模型(LLM)更快且更便宜。
介紹推理時延的擴充套件技術,涵蓋使用平均對數分數解決投票平局問題,並深入探討自修正機制。讀者將掌握如何計算 Token 機率、最佳化數值穩定性,並實作自修正迴圈來提升模型表現。
※ 摘要僅根據標題與說明
介紹 Krishna Prasad Srinivasan 如何從零開始,使用 3B 狀態空間視覺模型,詳細展示訓練過程與架構。
※ 摘要僅根據標題與說明
Token 是 AI 模型讀寫的基本單位,約為一個英文單字的 3/4。它決定了模型的上下文視窗大小、計算成本與延遲。文章解釋了 tokenizer 如何將文字轉為 token,並指出程式碼與自然語言在 token 數量上的差異,強調避免使…
介紹了 Hugging Face 的 tokenizers v1 版本,該版本在保持 API 和輸出不變的前提下,將編碼速度提升 3 至 30 倍。
深入探討推理時擴充套件技術,涵蓋溫度調控、Top-p 過濾及多項式取樣以生成多樣化回答,並透過自一致性方法提升大語言模型回答的準確性。
※ 摘要僅根據標題與說明
介紹如何建立不消耗使用量的 GPT-6 Astra 自動化流程。
※ 摘要僅根據標題與說明
介紹如何從零開始構建一個數學驗證器,用於評估大語言模型的推理能力,並可重複用於有可驗證獎勵的強化學習訓練。
※ 摘要僅根據標題與說明
介紹如何將 GPT-6 Astra 模型轉化為全天候股票交易系統,內容僅限於標題與說明欄的資訊,未提及具體步驟或細節。
※ 摘要僅根據標題與說明
介紹了如何利用 ChatGPT 開發自訂創意工具,內容簡短,僅說明其基本功能與應用方向。
※ 摘要僅根據標題與說明
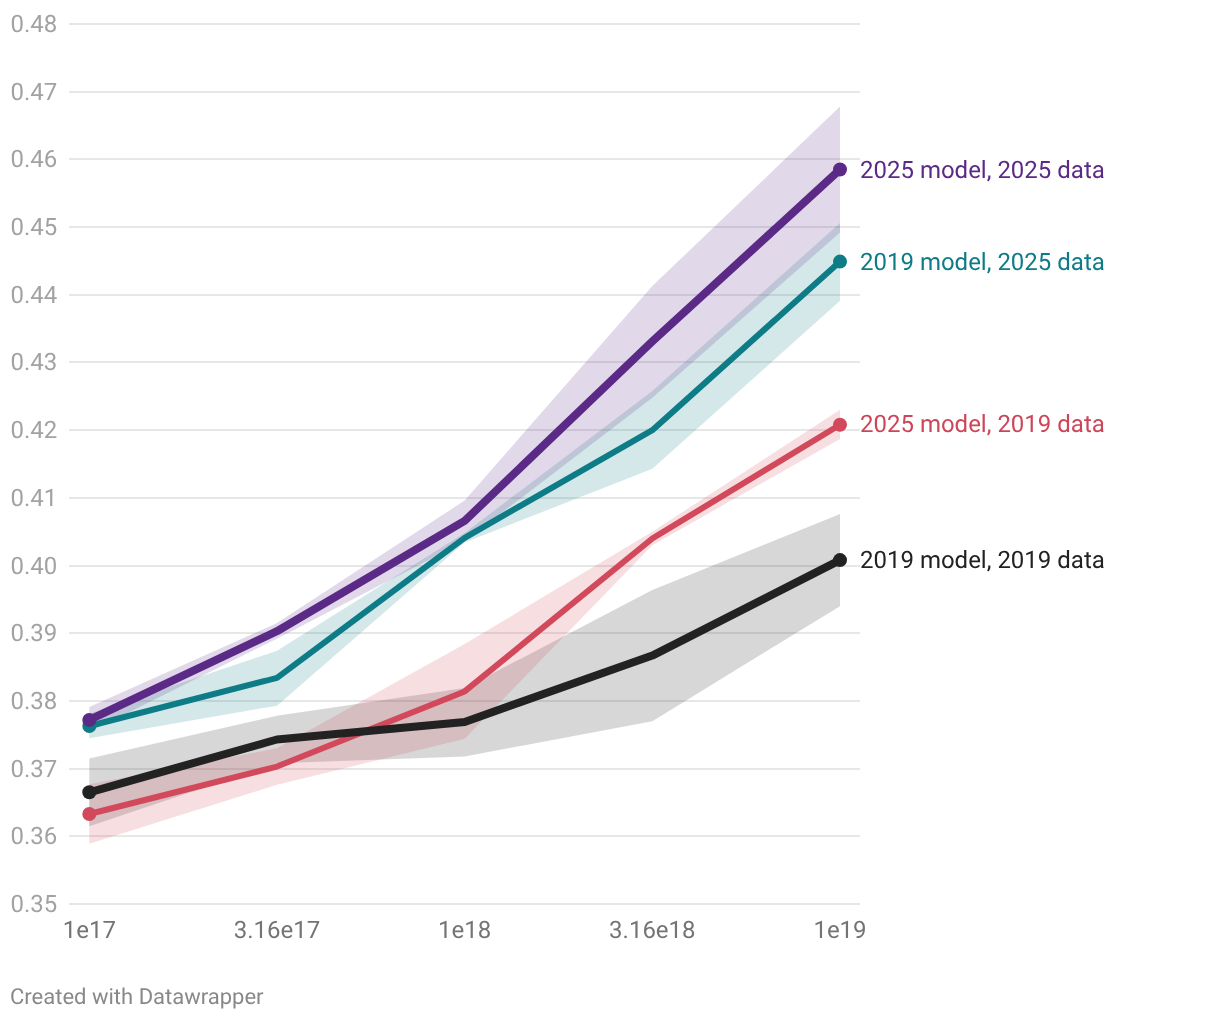
本研究分析了 2019 至 2025 年間 AI 訓練進步中資料與模型改進的貢獻。結果顯示,資料改進帶來的計算效率增益比模型改進高出 3.24 倍,且兩者增益 largely 獨立,資料工程(如資料篩選與構建)在提升模型能力上佔據主導地位。