看影片(在新分頁開啟原站)連到 Bilibili・Koala聊开源
摘要
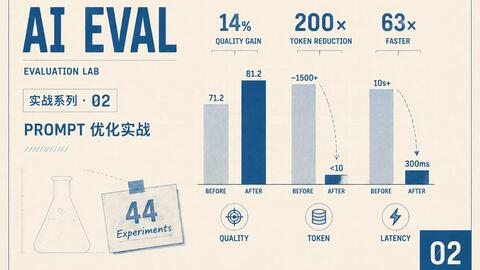
演示如何從真實 Agent 會話中構建評估資料集,透過自動化實驗比較不同 Prompt 方案。觀眾可學習如何在品質、成本與速度之間做出商業決策。
This video demonstrates how to build a prompt evaluation dataset from real agent sessions to optimize quality and cost.
這筆內容還沒有取得字幕或內文,這段摘要只根據標題與說明欄產生,可能不夠準確;實際內容請以原站為準。
適合誰看
適合正在最佳化 LLM 應用效能與成本的工程師。
摘要依據
- 依據
- 標題與說明欄(還沒有取得字幕或內文)
為什麼排在這裡
- 人氣
- 0.40
- 新鮮
- 0.80
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- The prompting playbook影片 ・ Claude ・ 34 分鐘 ・
- Agent 评估实战,从 sonnet 切换至 deepseek v4 flash|录屏精简版影片 ・ Koala聊开源 ・ 18 分鐘 ・
- Build evals from real production data影片 ・ Braintrust ・ 45 分鐘 ・
- Trust the agents you build on your data影片 ・ Braintrust ・ 52 分鐘 ・
- Evals for taste: Hill-climbing a slide-generation agent影片 ・ Claude ・ 39 分鐘 ・
- Evals Skills for Coding Agents文章 ・ Hamel Husain(部落格) ・
這個來源最近的內容
摘要由 AI 根據標題與說明欄產生(還沒有取得原文),可能有誤;完整內容請看原站。看影片(在新分頁開啟原站)