AI Evals: Everything You Need to Know
這篇文章是針對工程師與產品經理整理的 AI 評估(Evals)常見問題解答。內容涵蓋從基礎概念(如 Trace、評估範例)到實作工具(如人工標籤、LLM 判分)的完整流程,並針對 RAG、程式碼代理等領域提供具體評估策略。
Evals ・ 136 筆內容
怎麼知道你的 AI 系統做得好不好:測試集、指標、LLM 當評審。
也叫做:評測、评测、evals、eval、evaluation、評估、LLM-as-judge、LLM as a judge、benchmark、benchmarks、基準測試
由淺入深:入門 → 進階 → 高階
AI Evals: Everything You Need to Know
Hamel Husain(部落格)● 有原文
How UK AISI and EvalEval Are Making Benchmark Results Reproducible
Hugging Face Blog● 有原文
Product Evals in Three Simple Steps
Eugene Yan(部落格)● 有原文
Aayush Agrawal - Evals: The Engine for Agent Improvement(在新分頁開啟原站)
Berkeley RDI6 分鐘○ 無原文
Evals Skills for Coding Agents
Hamel Husain(部落格)● 有原文
Patterns for Building Cybersecurity Evals
Eugene Yan(部落格)● 有原文
Next Level AI Evals for 2026(在新分頁開啟原站)
Vanishing Gradients54 分鐘○ 無原文
Wayve's Dave Kirk: Why Agentic Code Review Needs Evals(在新分頁開啟原站)
AI Native Dev24 分鐘○ 無原文
Evaluating the Effectiveness of LLM-Evaluators (aka LLM-as-Judge)
Eugene Yan(部落格)● 有原文
依相關、人氣、新鮮度綜合排序;站長推薦的加成
這篇文章是針對工程師與產品經理整理的 AI 評估(Evals)常見問題解答。內容涵蓋從基礎概念(如 Trace、評估範例)到實作工具(如人工標籤、LLM 判分)的完整流程,並針對 RAG、程式碼代理等領域提供具體評估策略。
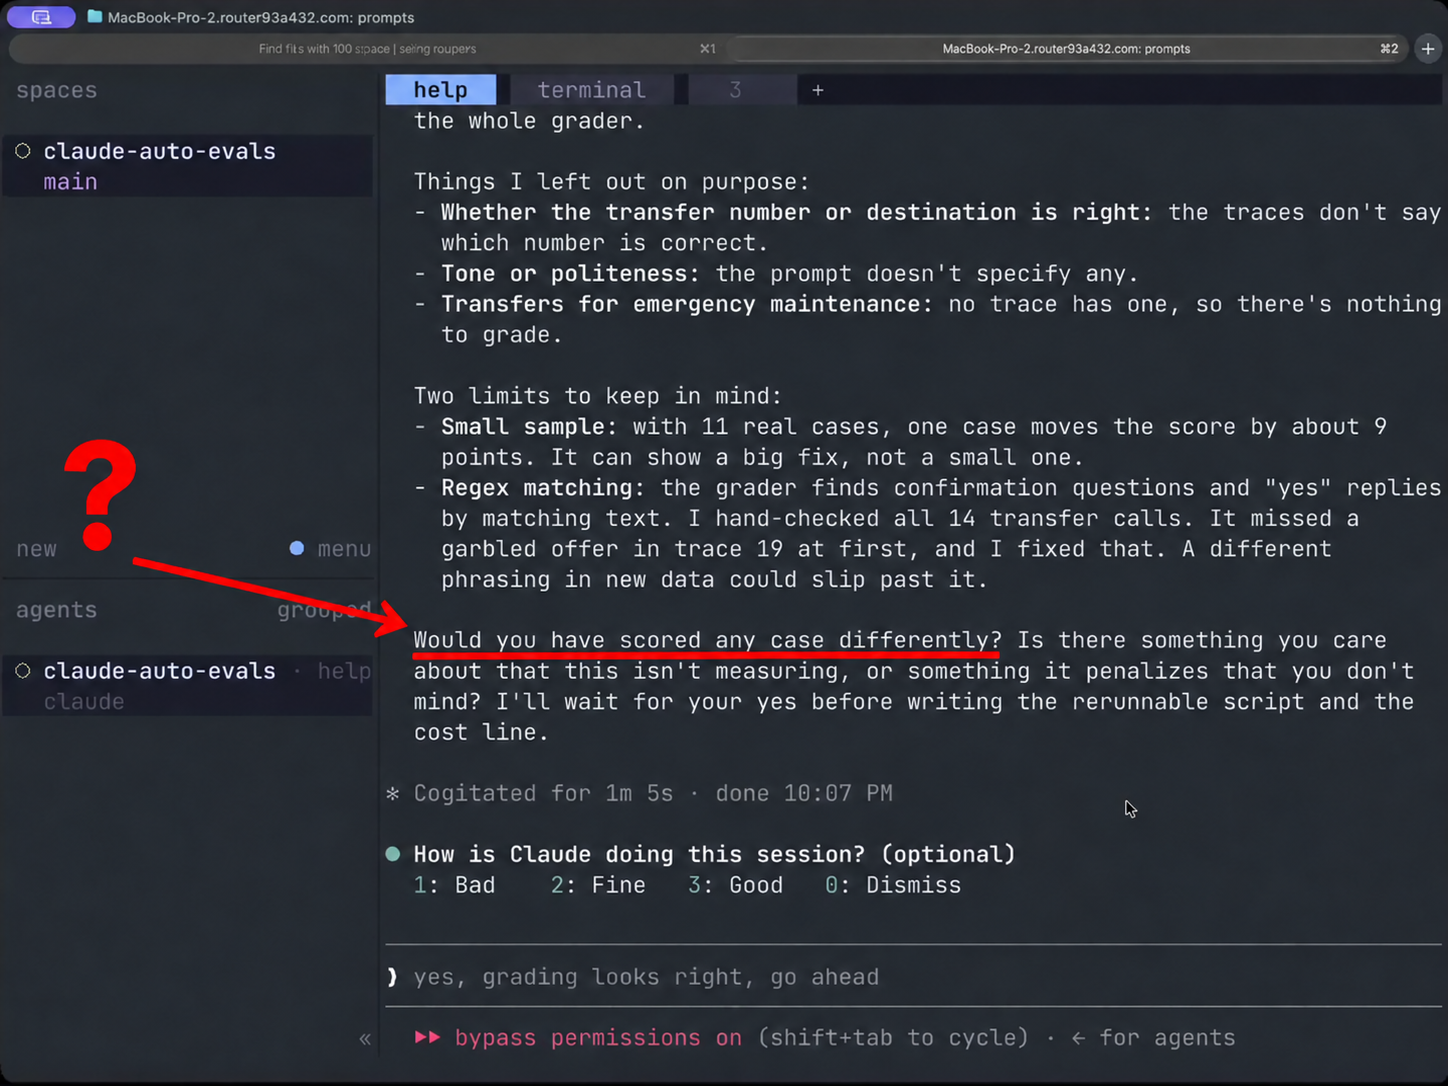
介紹了 Anthropic 為 Claude Code 開發的新自動評測工具,包含「hill-climb」命令協助使用者建立評測、檢查評分器並提升應用程式表現。作者指出工具常催促使用者先建立評測,且缺乏足夠上下文進行驗證,導致理解資料困難。
介紹了「Eval Skills」,一套專為 AI 產品評估設計的實用技能。這些技能能幫助使用者避免常見錯誤,例如過度依賴通用指標而忽略實際資料。
介紹了英國 AI 安全研究所(AISI)與 EvalEval 合作,透過「Every Eval Ever」共享架構與「Evaluation Cards」平台,將benchmark 評測結果的透明度和可重複性提升。
這篇文章詳細介紹了建立產品評估流程的三個簡單步驟:首先標註少量資料,接著對齊 LLM 評審器,最後執行實驗並驗證配置變更。作者強調使用二進位制標籤(透過/失敗)比複雜的評分系統更有效率,並建議透過合成缺陷或主動學習來構建平衡的測試集。
介紹了 Aayush Agrawal 提出的 Evals 系統,該系統旨在透過自動評估來提升 AI 代理的表現。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
探討如何克服評估 AI 模型的困難,並介紹解決方法。
※ 摘要僅根據標題與說明
介紹了建構安全評估(Cybersecurity Evals)的通用模式,包括沙箱化目標、影響任務難度的輸入、工具與評分器。
探討了「產品難以驗證」的常見反饋,指出這是一種產品異味。作者分享了三個案例:AI 資料代理、PE 課程建構器與工人傷害醫療報告工具,並展示了如何透過提供可驗證的 artifacts(如詳細分析筆記本、與vetted plan 的差異比較)…
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
介紹如何透過 Claude Code 在短短五個步驟建立更佳的 AI 評估流程。
※ 摘要僅根據標題與說明
Hamel Husain 分享他如何為忙碌的開發者提供實用的 AI 評估方法,幫助企業建立可量化的產品測試流程。
※ 摘要僅根據標題與說明
介紹 LangSmith Tuned Evaluators 功能,說明如何透過此工具精確評估 AI 模型在特定任務上的表現。
※ 摘要僅根據標題與說明
探討 AI 開發者如何面對被錯誤評估的資料,並提出即使資料品質不佳也要繼續使用的策略。
※ 摘要僅根據標題與說明
Datadog 刪除了長期維護的 AI 上下文件案,卻意外讓程式碼評測表現更優。這場訪談探討了他們如何從零開始打造 AI 編碼代理系統,並透過建立以評測為核心的評測驅動開發流程,成功將 Cursor 和 Claude Code 擴充套件至…
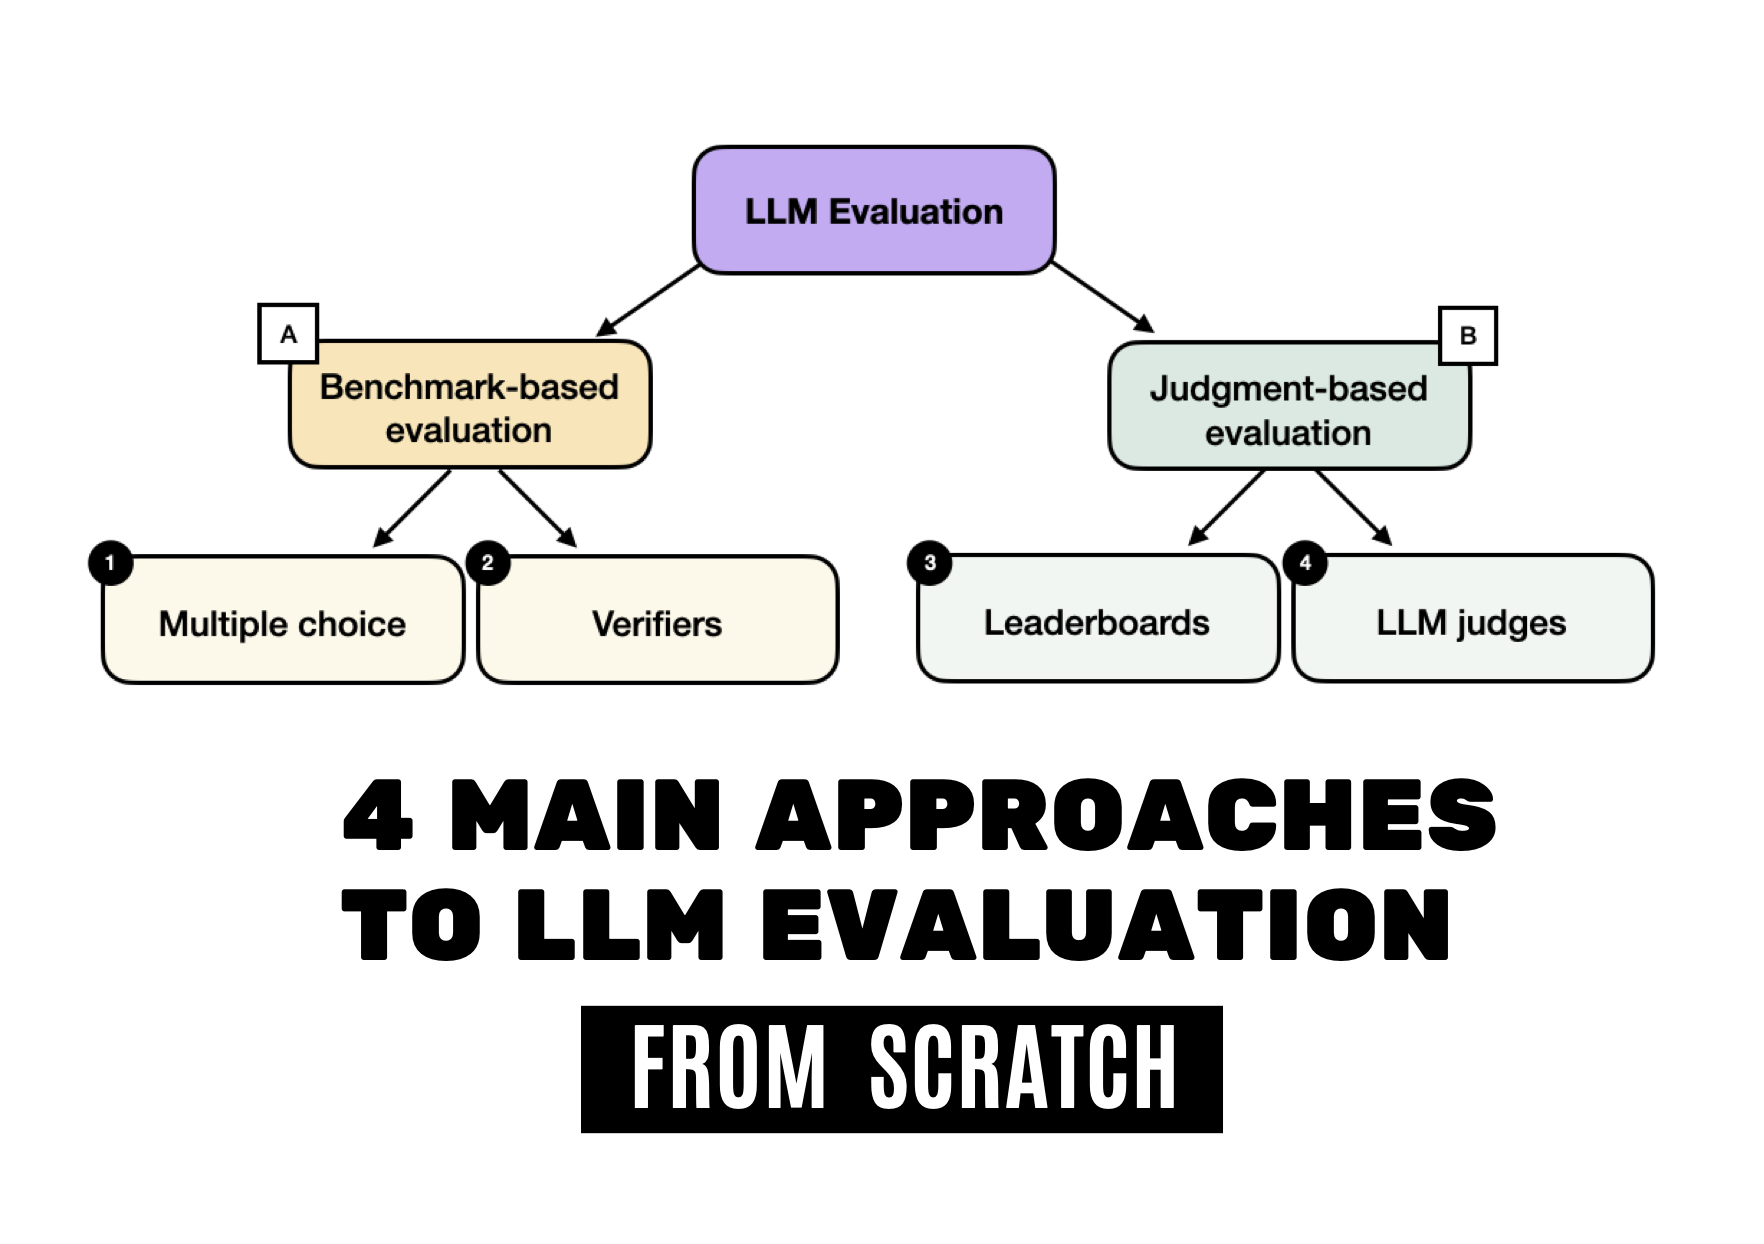
介紹了評估大語言模型(LLM)的四大主流方法:多選題庫、驗證器、排行榜和 LLM 裁判。透過程式碼實作,讀者能理解這些方法的運作原理與優缺點。
Dave Kirk 解釋為何需要評估來驗證程式碼自主性,並指出若缺乏評估,AI 程式碼審查將無法有效運作。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
ASU 的 Stella Wenxing Liu 與 Google 的 Eddie Landesberg 探討 2026 年 AI 評估如何從「感覺檢查」演變為嚴謹的跨學科科學,並預測因果推理將推動評估技術邁向新高度。
※ 摘要僅根據標題與說明
深入解析了如何為 AI 代理設計有效的評估體系。作者指出,由於代理具備自主性和靈活性,傳統靜態評估難以捕捉其複雜行為,因此需要結合程式碼檢查、模型評分與人工審視等多種方法。
探討 AI 產品開發者為何不應將評估工作完全交給工具,強調人工判斷的重要性。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
本講探討生成式 AI 時代下機器學習的評分系統問題,並分析大型語言模型的評估方法。
※ 摘要僅根據標題與說明
依發布時間
IBM 介紹 Jev 系統 1 型 AI 模型,它透過 calibrated 機率做出快速決策,不依賴文字生成。此模型可作為 LLM 的補完,用於路由、分類及建立 AI 防護機制,協助企業最佳化決策流程。
※ 摘要僅根據標題與說明
分享從銀行資料與機器學習起步的 20 年經驗,指出企業在 AI 產品測試與評估上缺乏實際方法,導致產品僅靠「感覺」運作。他介紹了自己開發的流行評估課程,並提供如何建立可持續的 AI 產品的具體實戰知識。
※ 摘要僅根據標題與說明
分享八個使用 Claude Code 提升 AI 評估品質的技能,強調在撰寫評估前必須先分析真實失敗案例。作者與團隊透過設計專屬介面與最佳化樣本選擇策略,幫助開發者更精準地發現並修復產品中的問題。
※ 摘要僅根據標題與說明
介紹了 Anthropic 為 Claude Code 開發的新自動評測工具,包含「hill-climb」命令協助使用者建立評測、檢查評分器並提升應用程式表現。作者指出工具常催促使用者先建立評測,且缺乏足夠上下文進行驗證,導致理解資料困難。
介紹了 Open TTS Leaderboard,旨在解決開放源 TTS 模型評測碎片化問題。該板塊使用視覺化指標(如 WER、RTFx、SIM)替代傳統的人工偏好評分,讓評測更快速且具可比性。
Wonder 團隊展示如何透過 LangSmith 的 Trace 與 LLM-as-Judge 評估 Agent 表現,並最佳化 Prompt 管理以實現自動修復。
※ 摘要僅根據標題與說明
Uber 在四個月內耗盡了六倍於其 AI 預算的資金,影片深入探討了為何「路徑最佳化」能決定工作負載的可行性,並分析了 Cisco 如何透過評估機制來決定何時需要人工介入。
※ 摘要僅根據標題與說明
探討 Jev 在 AI 工程中的十個進階應用層級,從簡單的 if 判斷演變至自主決策的 Pi 代理。內容介紹如何透過系統一模型與 Jev 協作,將複雜任務分發給專職程式碼代理,並展示從提示注入篩選到風險評估的實作流程。
※ 摘要僅根據標題與說明
探討了如何為 AI 公司建立內部評估機制,以確保其安全與合規。作者指出,雖然目前缺乏理想的獨立評估者,但 Anthropic 與 Accenture 已達成合作,並計劃引入 METR 等非營利機構來補充。
本訪談探討 WeCo AI 共創的 AIDE 85 系統,該系統透過八天內自動最佳化自身研究框架,發現了比人工手調更最佳化的程式碼。訪談者指出,雖然系統在效能上取得顯著提升,但並未完全解決「獎勵竊取」問題,且其程式碼仍具複雜性。
※ 摘要僅根據標題與說明
影片由 Hamel Husain 分享,他結合 20 年資料與機器學習背景,探討如何識別複雜 AI 代理中的失敗模式。內容涵蓋從基礎資料分析到現代 AI 產品評估的實戰方法,幫助讀者建立系統化的測試與改進框架。
※ 摘要僅根據標題與說明