讀原文(在新分頁開啟原站)連到 Eugene Yan(部落格)
摘要
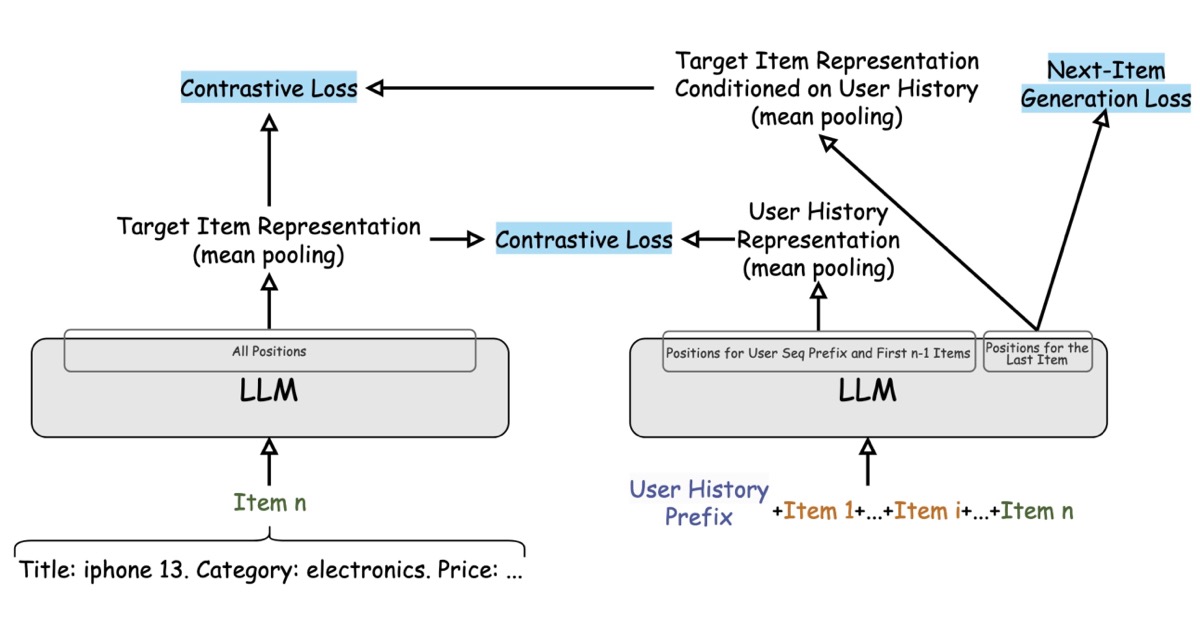
探討大語言模型(LLM)如何重塑推薦系統與搜尋。透過混合架構、資料生成、訓練正規化及統一框架,解決傳統 ID 基方法的冷啟動與長尾問題。文章詳述了從 VideoBERT 到 Semantic IDs 的演進,以及 M3CSR、FLIP、beeFormer 等例項如何結合多模態與行為建模。此外,還介紹了輔助蒸餾、LoRA 等技術如何提升模型效率與表現。
This article explores how Large Language Models (LLMs) are transforming recommendation systems and search. By leveraging hybrid architectures, data generation, training paradigms, and unified frameworks, it addresses limitations of traditional ID-based approaches. Case studies like M3CSR, FLIP, and…
重點
- 混合架構結合多模態內容與行為建模,解決冷啟動與長尾問題。
- Semantic IDs 與 N-gram/SPM 方法提升新物品推薦效率與泛化性。
- FLIP 與 beeFormer 透過跨模態對齊與 Transformer 訓練,最佳化搜尋與推薦。
提到的工具與公司
- VideoBERT
- Semantic IDs
- RQ-VAE
- SPM
- M3CSR
適合誰看
對推薦系統、搜尋引擎及大語言模型感興趣的程式設計師與工程師。
摘要依據
- 講者
- Eugene Yan
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.11
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- AI Engineer 2025 - Improving RecSys & Search with LLM techniques文章 ・ Eugene Yan(部落格)
- Training an LLM-RecSys Hybrid for Steerable Recs with Semantic IDs文章 ・ Eugene Yan(部落格)
- Why LLM Recommenders Will Be AI's Biggest Consumer App文章 ・ AIE Talks
- Augment or Not? A Comparative Study of Pure and Augmented Large Language Model Recommenders影片 ・ 陳縕儂 Vivian NTU MiuLab ・ 17 分鐘(在新分頁開啟原站)
- Vector Search with LLMs - Computerphile影片 ・ Computerphile ・ 20 分鐘(在新分頁開啟原站)
- Retrieval Augmented Generation (RAG), Search, and Vector Databases影片 ・ Luis Serrano Academy ・ 19 分鐘(在新分頁開啟原站)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)