1文章入門EN
Building AI Reading Club: Features & Behind the Scenes
介紹了作者開發的 AI 閱讀助手 Dewey 及其核心功能。該工具透過理解閱讀上下文、簡化查詢介面、生成摘要與測驗等方式,讓讀者能更流暢地閱讀書籍。
依人氣
介紹了作者開發的 AI 閱讀助手 Dewey 及其核心功能。該工具透過理解閱讀上下文、簡化查詢介面、生成摘要與測驗等方式,讓讀者能更流暢地閱讀書籍。
本文列舉了語言模型領域的 30 篇核心論文,涵蓋從基礎架構到最新技術的演進。讀者可透過這些論文了解 LLM 的訓練原理、最佳化策略及未來趨勢,建立自己的「論文俱樂部」,深入掌握機器學習的前沿知識。
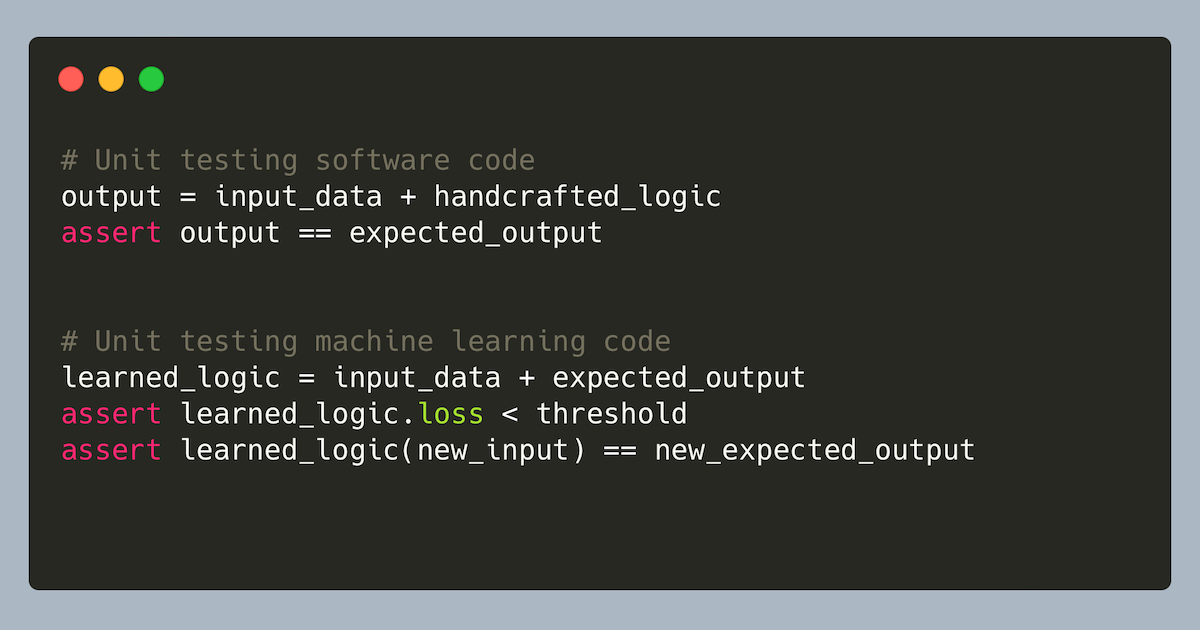
探討了將傳統軟體測試方法應用於機器學習程式時遇到的困難。作者指出,ML 程式碼的核心是學習邏輯而非直接包含邏輯,因此測試方式必須改變:通常需透過模型推理來驗證輸出,而非直接斷言結果。
分享如何打造一個 AI 教練來克服「猴子心態」,利用語音轉文字、文字轉語音及大語言模型,並搭配虛擬電話號碼,讓對話更自然且具同理心。
2025 年作者專注於健康與職業發展,並結合 LLM 與推薦系統技術。文章分享了四個原型應用、健康資料改善、滑雪與牙齒治療的挑戰,以及 O1 簽證獲批與升遷喜訊。
介紹了 AI 工程師如何透過 LLM 技術提升推薦系統與搜尋效能。作者分享了在 2025 年 AI 工程師世界 fair 上關於 RecSys 與 Search 的演講內容,涵蓋了使用語義 ID、資料增強及統一基礎模型來實現這兩者的融合。
這篇文章由資料科學家伊恩·揚分享,他解釋了撰寫過程的起源、目的與方法。作者從學習、分享觀點、表達異見及社群連結四方面出發,並針對個人、團隊與領導者等不同受眾,採用不同的寫作策略。
介紹了如何使用 Amazon Q CLI、Anthropic MCP 和 tmux 來建立每日新聞摘要的自動化工作流。作者透過將新聞分組並啟動多個子代理,讓每個子代理獨立處理特定來源,最後由主代理整合結果。
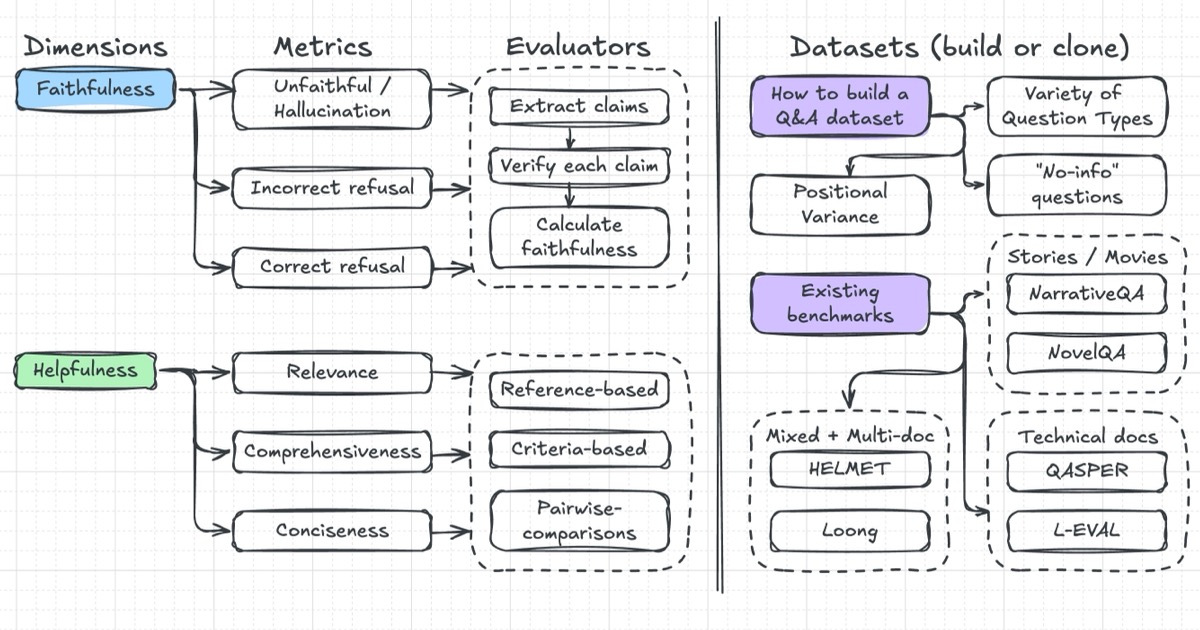
探討如何評估長上下文下的問答系統。作者指出,隨著文件變大,資訊過載、位置偏差、多跳推理及幻覺等問題會顯著增加。文章介紹了評估指標、如何建立評估資料集的方法,並回顧了多個文件型別(如小說、技術文獻)的測試基準,強調需同時考量忠實度與幫助性。
Chip Huyen 與作者分享了在 NVIDIA GTC 2025 上如何建構大型語言模型(LLM)驅動應用程式的最佳實踐與心得。文章涵蓋了從基礎架構到生產環境部署的完整流程,幫助讀者掌握將 AI 能力轉化為實際商業價值的方法。
依發布時間
介紹了建構安全評估(Cybersecurity Evals)的通用模式,包括沙箱化目標、影響任務難度的輸入、工具與評分器。
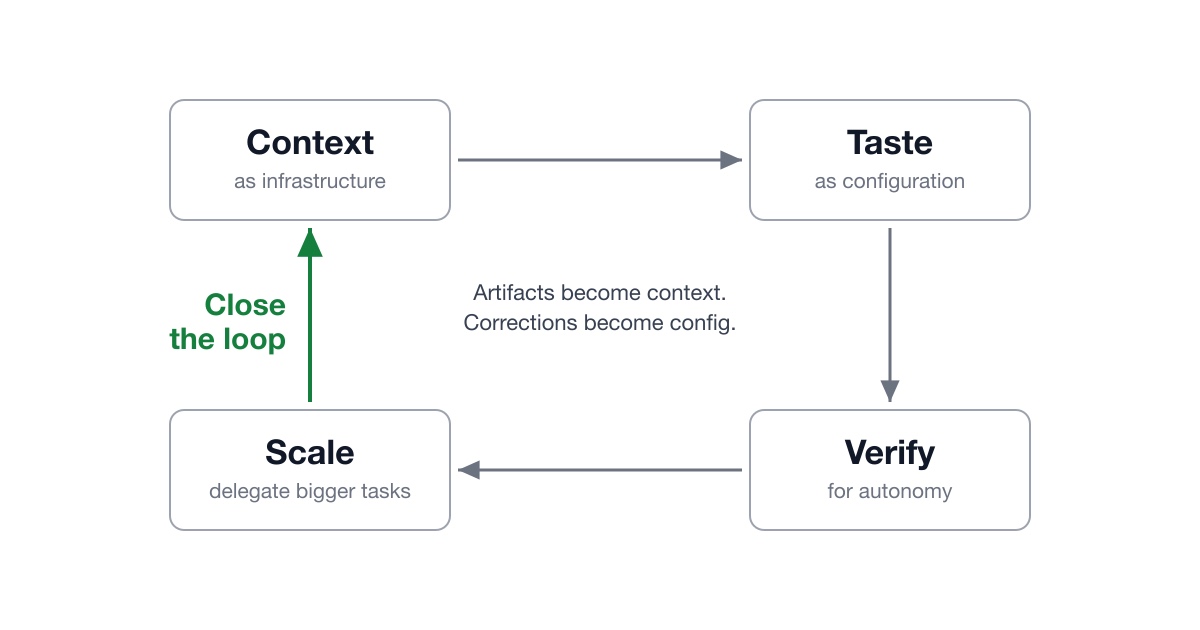
探討了如何有效與 AI 合作,並透過建立上下文、設定偏好、驗證機制和閉環來實現協同增效。作者提出將個人習慣轉化為可執行的技能,並透過自動化的驗證與回饋系統,讓 AI 能持續最佳化工作流,最終達成「複利」效果。
2025 年作者專注於健康與職業發展,並結合 LLM 與推薦系統技術。文章分享了四個原型應用、健康資料改善、滑雪與牙齒治療的挑戰,以及 O1 簽證獲批與升遷喜訊。
這篇文章詳細介紹了建立產品評估流程的三個簡單步驟:首先標註少量資料,接著對齊 LLM 評審器,最後執行實驗並驗證配置變更。作者強調使用二進位制標籤(透過/失敗)比複雜的評分系統更有效率,並建議透過合成缺陷或主動學習來構建平衡的測試集。
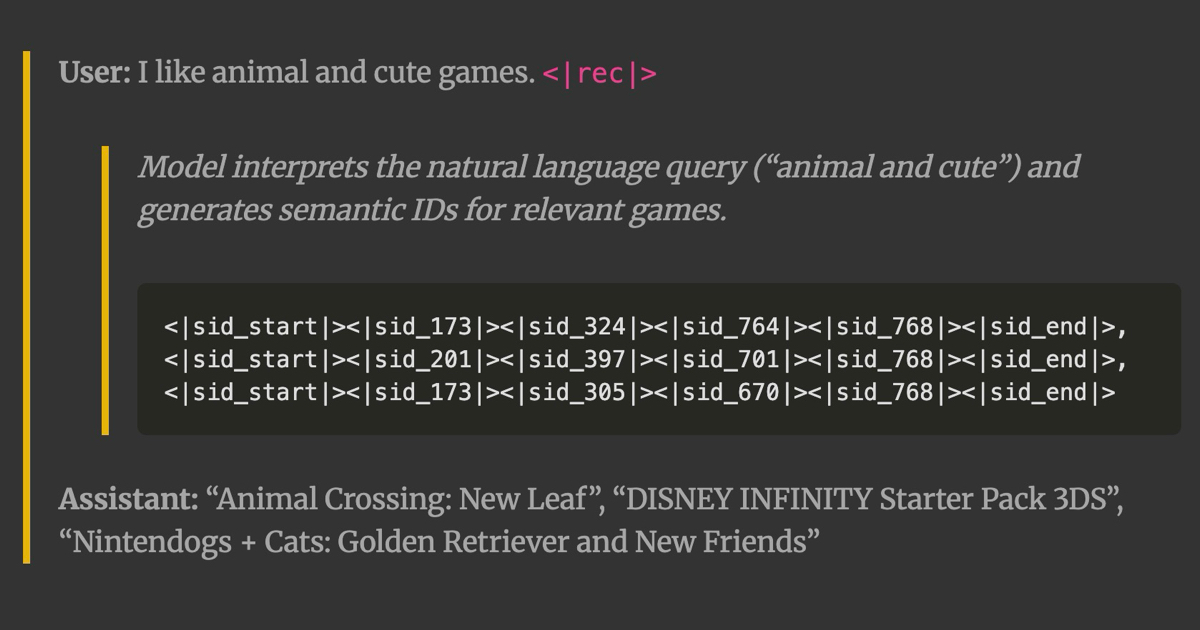
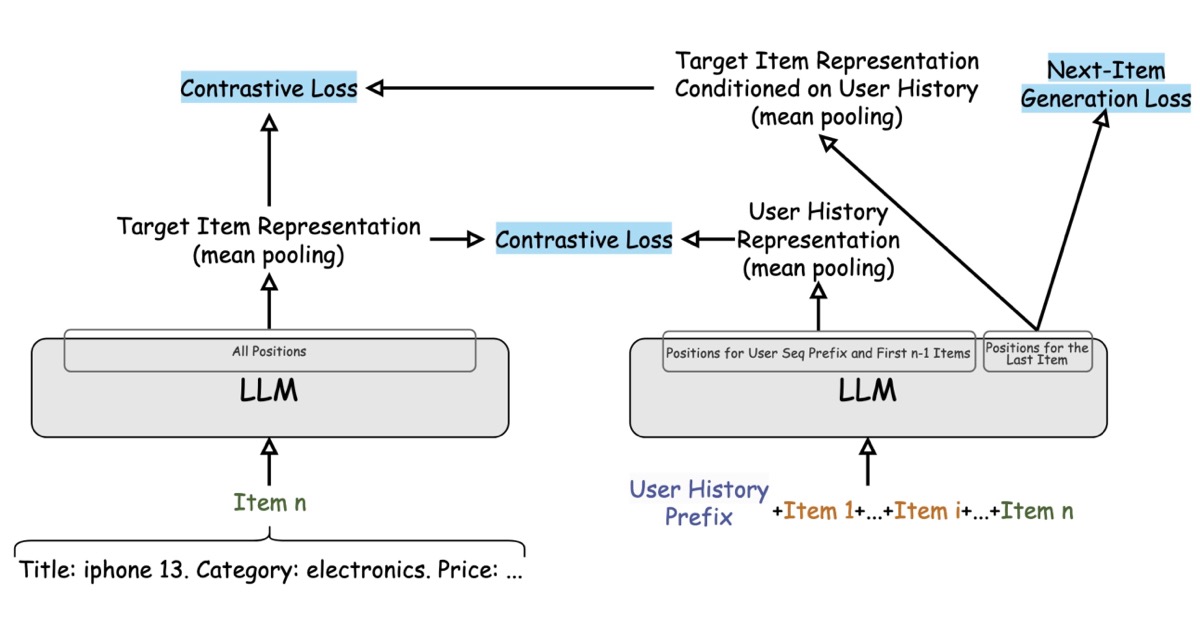
介紹了結合大語言模型(LLM)與推薦系統(RecSys)的新方法,利用「語意 ID」將商品轉化為可理解的語義符號。作者展示了如何透過 RQ-VAE 生成語義 ID,並訓練一個可對話的 LLM 來進行推薦。
探討如何評估長上下文下的問答系統。作者指出,隨著文件變大,資訊過載、位置偏差、多跳推理及幻覺等問題會顯著增加。文章介紹了評估指標、如何建立評估資料集的方法,並回顧了多個文件型別(如小說、技術文獻)的測試基準,強調需同時考量忠實度與幫助性。
介紹了 AI 工程師如何透過 LLM 技術提升推薦系統與搜尋效能。作者分享了在 2025 年 AI 工程師世界 fair 上關於 RecSys 與 Search 的演講內容,涵蓋了使用語義 ID、資料增強及統一基礎模型來實現這兩者的融合。
介紹了如何使用 Amazon Q CLI、Anthropic MCP 和 tmux 來建立每日新聞摘要的自動化工作流。作者透過將新聞分組並啟動多個子代理,讓每個子代理獨立處理特定來源,最後由主代理整合結果。
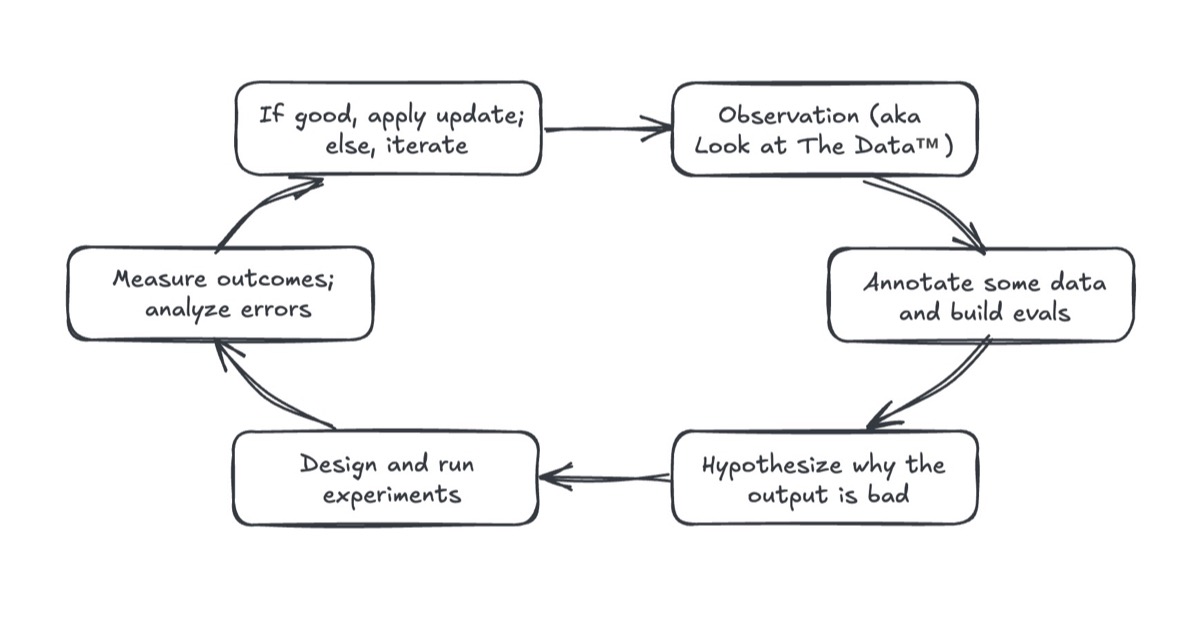
指出,單純增加 LLM 作為裁判或額外工具無法解決產品問題,因為這只是掩蓋核心問題。真正的關鍵在於建立「產品評估迴圈」,即運用科學方法,透過觀察資料、標註失敗案例、提出假說並進行實驗驗證,形成資料飛輪。
這篇文章由資料科學家伊恩·揚分享,他解釋了撰寫過程的起源、目的與方法。作者從學習、分享觀點、表達異見及社群連結四方面出發,並針對個人、團隊與領導者等不同受眾,採用不同的寫作策略。
Chip Huyen 與作者分享了在 NVIDIA GTC 2025 上如何建構大型語言模型(LLM)驅動應用程式的最佳實踐與心得。文章涵蓋了從基礎架構到生產環境部署的完整流程,幫助讀者掌握將 AI 能力轉化為實際商業價值的方法。
探討大語言模型(LLM)如何重塑推薦系統與搜尋。透過混合架構、資料生成、訓練正規化及統一框架,解決傳統 ID 基方法的冷啟動與長尾問題。
介紹了作者開發的 AI 閱讀助手 Dewey 及其核心功能。該工具透過理解閱讀上下文、簡化查詢介面、生成摘要與測驗等方式,讓讀者能更流暢地閱讀書籍。
2024 年對作者而言是穩定進步的一年,成功將 2023 年的原型產品投入生產,並持續改善健康習慣。在寫作方面,發表了多篇技術文章,包括與朋友合著的《Building with LLMs》系列,並推出了 Tara AI Coach 和 A…
介紹了如何建立每週閱讀論文俱樂部以建構學習社群。作者分享了一套完整的流程,包括如何選取論文、如何進行預讀、如何擔任主持人以及如何管理活動。透過每週固定時間的討論,讀者可以深入理解關鍵技術與模型,並建立深厚的專業網路。
這篇文章由 Eugene Yan 分享,他從 2019 年 Intel MacBook Pro 升級至 M4 MacBook Pro,並透過整理數位生活從零開始,建立極簡設定。
這篇文章是作者對 2024 年 AI 領域會議的筆記,涵蓋了建立 ML 系統、生產部署、執行與協作的 39 個關鍵原則。內容強調建立真實世界的獎勵函式、設計資料飛輪、平衡短期與長期回報,以及避免過度依賴單一模型。
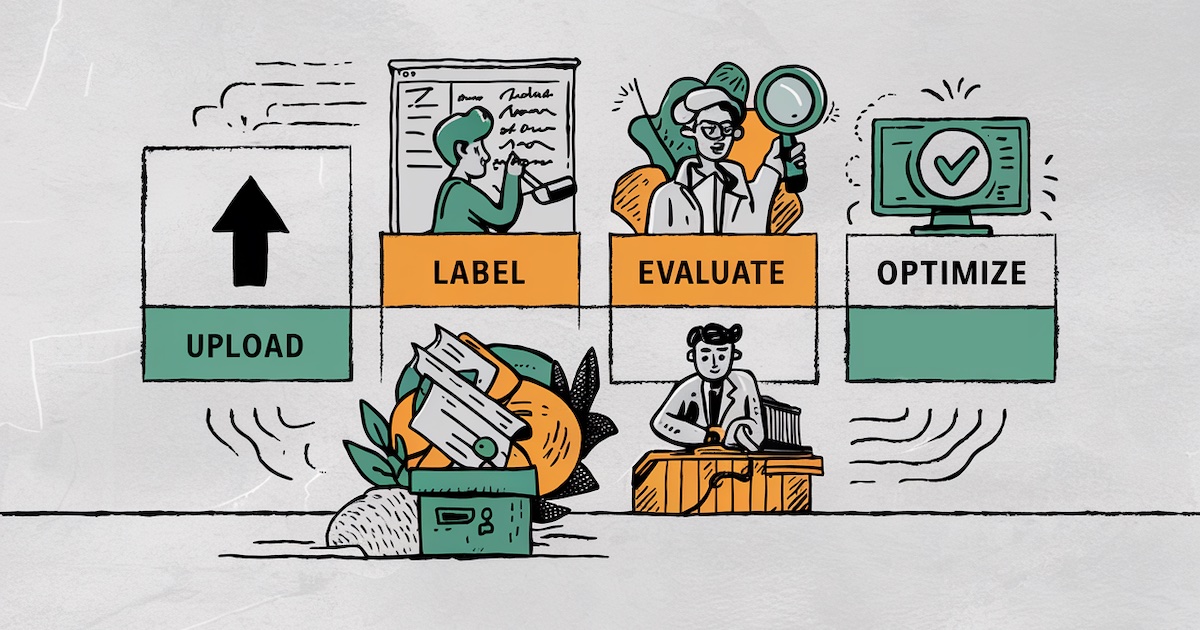
介紹 AlignEval 是一個簡化 LLM 評估流程的應用程式。使用者只需上傳 CSV 資料、標記樣本(透過或失敗)、定義評估標準,AlignEval 就能自動最佳化評估器。作者強調應從資料出發而非預設標準,並提供實作步驟與工具推薦。
作者於 Weights & Biases LLM-as-a-Judge Hackathon 擔任評審,參與了超過 100 人的 15 個團隊展示。團隊展示了知識圖譜建構、MBTI 評估、提示最佳化等多種實作。
這篇文章作者嘗試用 FastAPI、FastHTML、Next.js 和 SvelteKit 四個不同框架,構建完全相同的「看你的資料」Web 應用程式。透過實作 CRUD 操作,作者希望比較各框架的獨特功能與開發者體驗。
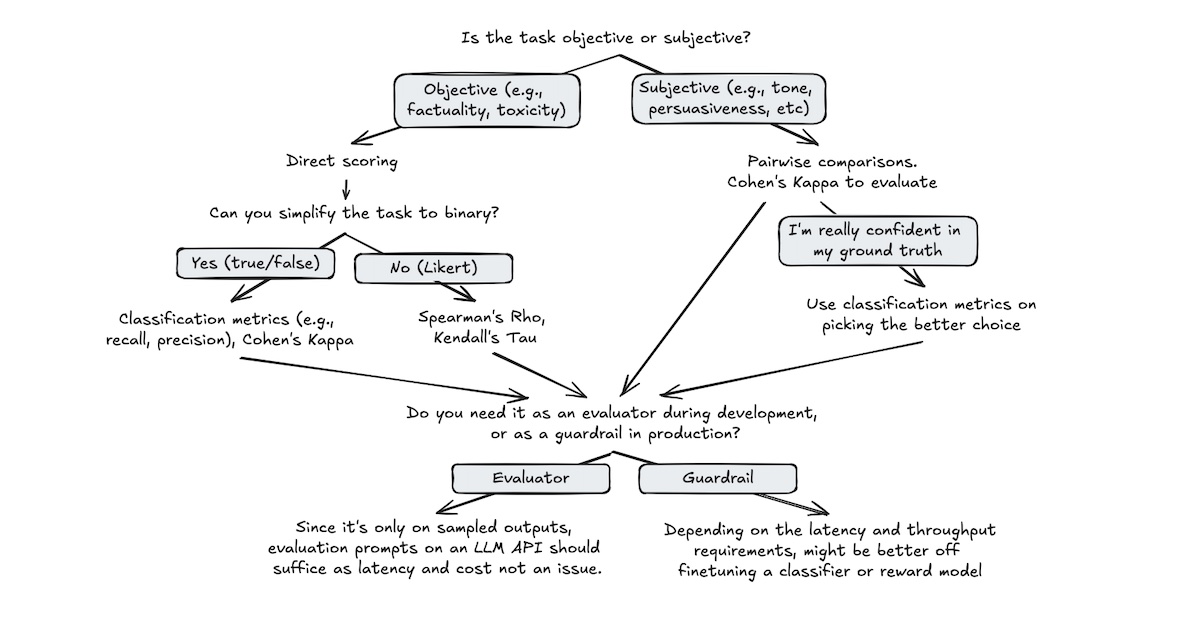
探討了 LLM 作為裁判器(LLM-as-Judge)的效能,涵蓋了應用場景、評估技術、模型對齊及訓練方法。作者分析了直接評分、成對比較與參考評估三種方法,並討論了分類指標與相關係數指標的適用性。
這篇文章詳細介紹了如何進行 ML/AI 工程師的面試與選才。內容涵蓋了評估技術與非技術素養、如何進行電話初選、執行面試迴圈以及後期反饋,並提供了關於資料文藝、模型評估、科學廣度與深度、以及影響力的面試問題與評估標準。
作者們在 AI Engineer World 2024 閉幕演講中分享了使用 LLM 一年的經驗。他們探討了如何準備多講者會議、選擇合適的演講形式,並強調了與 AI 合作的重要性。
這篇文章由 Amazon 資深應用科學家 Eugene Yan 撰寫,分享了在 Netflix 2024 年個人化研討會上的經驗。他談及在消費者規模部署大語言模型(LLM)推薦系統時所面臨的挑戰與經驗,涵蓋評估、可擴充套件性及安全邊界。
深入探討了大語言模型(LLM)提示工程的核心基礎,包括結構化輸入輸出、預填充、多範例提示(n-shots)、思維鏈(CoT)以及減少幻覺的方法。
分享如何打造一個 AI 教練來克服「猴子心態」,利用語音轉文字、文字轉語音及大語言模型,並搭配虛擬電話號碼,讓對話更自然且具同理心。
探討了針對特定任務(如分類、摘要、翻譯)的 LLM 評估方法,指出許多通用評估工具在實際應用中效果不佳。作者推薦了基於 NLI 的一致性檢查、NLI 模型作為事實一致性指標、以及 chrF、BLEURT 和 COMET 等翻譯質量評估指標。
探討了將傳統軟體測試方法應用於機器學習程式時遇到的困難。作者指出,ML 程式碼的核心是學習邏輯而非直接包含邏輯,因此測試方式必須改變:通常需透過模型推理來驗證輸出,而非直接斷言結果。
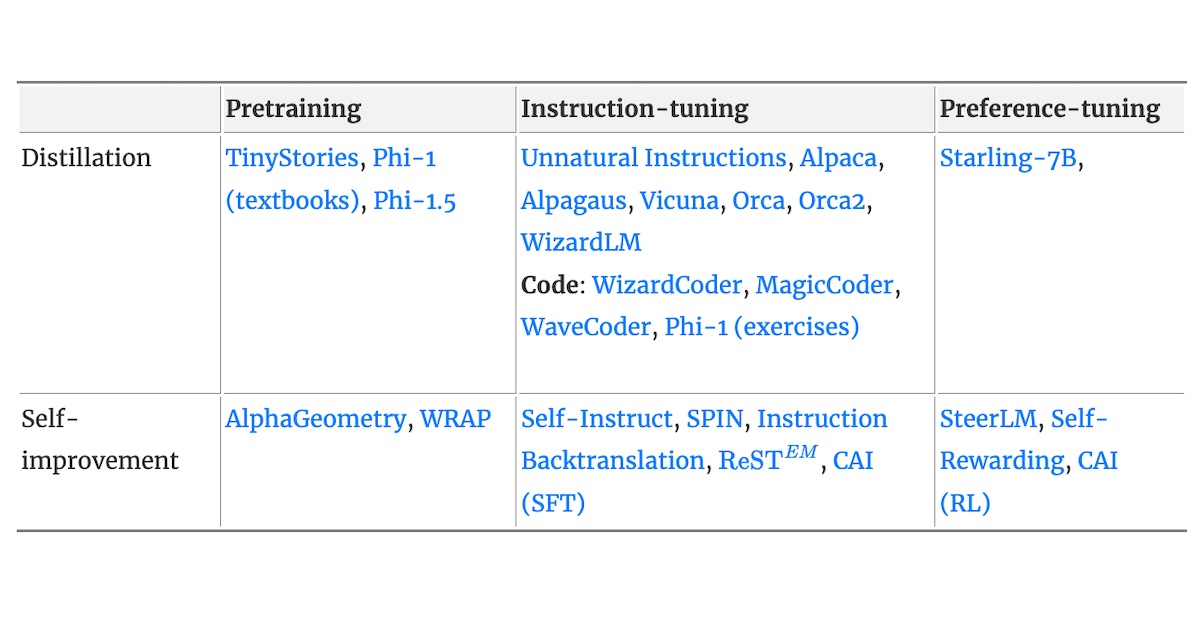
探討如何透過生成式資料來解決人工標籤的瓶頸,適用於指令調教、偏好調教及預訓練。作者介紹了兩種主要方法:透過較強模型蒸餾知識,或讓模型自我改進。
本文列舉了語言模型領域的 30 篇核心論文,涵蓋從基礎架構到最新技術的演進。讀者可透過這些論文了解 LLM 的訓練原理、最佳化策略及未來趨勢,建立自己的「論文俱樂部」,深入掌握機器學習的前沿知識。
回顧了 2023 年的學習與工作程序,涵蓋了撰寫 26 篇部落格文章、參與 AI 工程師峰會、投資 ML 初創公司以及個人健康調整。作者透過實際案例展示了如何將 AI 技術應用於系統設計與產品開發,並反思了從量變到質變的寫作策略。
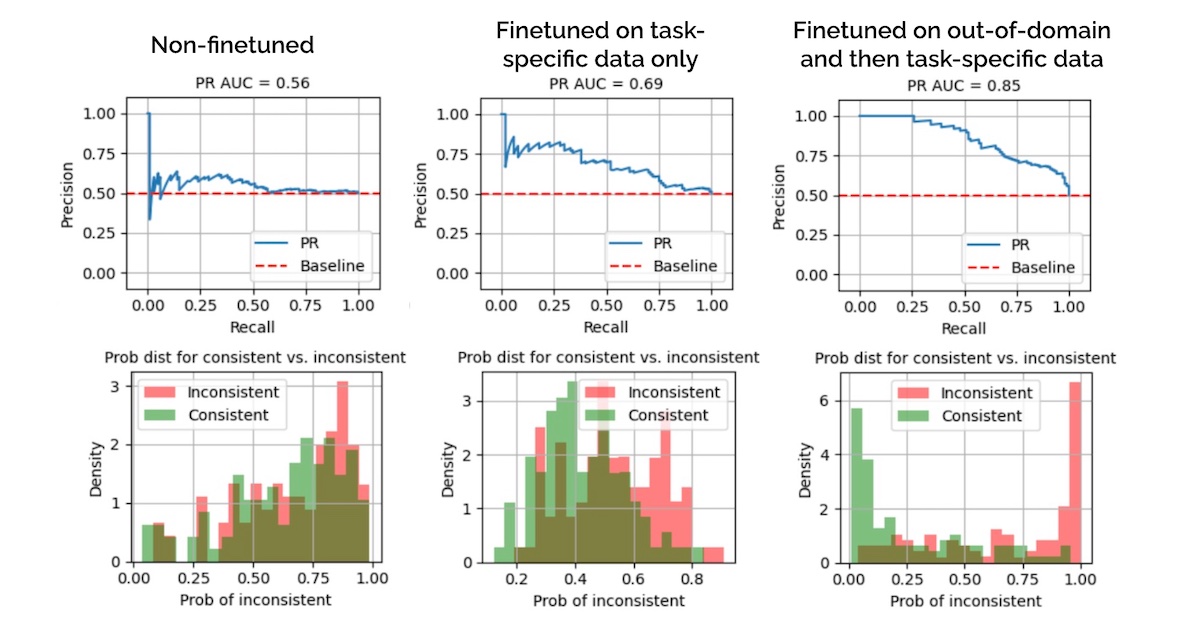
探討如何利用外域資料(如維基百科摘要)進行預訓練,來提升對新聞摘要中事實不一致(即謠言)的檢測能力。作者發現,即使預訓練階段在相關領域(維基百科)上只進行了少量訓練,也能顯著改善後續在特定任務(FIB)上的表現,從而減少需要收集大量標註資…
回顧了 2023 年 AI 工程師盛會,重點指出評估(Evals)與服務成本是部署最大的挑戰。作者分享了如何透過 VCR.py 儲存回應來降低成本,並強調 LLM 需具備後向相容性,同時指出多模態模型尚未成熟,但文字仍是通用媒介。
演講者分享了構建 LLM 系統的四大關鍵模式:評估(Eval)、檢索增強生成(RAG)、護欄(Guardrails)及回饋收集。他強調需針對特定任務設計評估集,並結合檢索技術與推薦系統理念來最佳化結果。