Are LLM Performance Benchmarks Reliable? — Ashok Chandrasekar & Jason Kramberger, Google(在新分頁開啟原站)
探討大型語言模型(LLM)的效能基準是否可靠,並分析其潛在問題。
※ 摘要僅根據標題與說明
LLM Fundamentals ・ 174 筆內容
語言模型怎麼運作、怎麼被訓練出來,以及生成式 AI 的整體觀念。
也叫做:LLM、LLMs、大型語言模型、大語言模型、大语言模型、大模型、large language model、生成式AI導論、生成式 AI 導論、生成式AI、生成式 AI、generative AI、GenAI、語言模型
依相關、人氣、新鮮度綜合排序;站長推薦的加成
探討大型語言模型(LLM)的效能基準是否可靠,並分析其潛在問題。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
這則影片介紹了終於出現的 Karpathy LLM Wiki 開放標準,讓使用者能自由存取與使用。
※ 摘要僅根據標題與說明
Yves Raimond 與 Jacqueline Wood 探討如何讓大語言模型學會說歌單,並分析 Spotify 的資料如何影響 AI 的學習。
※ 摘要僅根據標題與說明
Meta 的 Devansh Tandon 在影片中探討 LLM 推薦器將成為 AI 領域最大的使用者應用程式,並分析其發展趨勢。
※ 摘要僅根據標題與說明
探討 DoorDash 如何將大型語言模型用於搜尋與個人化,而非直接服務使用者。
※ 摘要僅根據標題與說明
介紹了如何將路徑模型(LLM)部署於生產環境,涵蓋從引擎訊號到策略的完整流程。
※ 摘要僅根據標題與說明
Stanford 線上課程《Language Modeling from Scratch》的 Spring 2026 版,由 Dan Fu 主講,深入探討從零開始構建語言模型的基礎原理。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
探討語言模型訓練中「引導」的重要性,指出模型聰明程度取決於人類如何設計指令。影片結合生成式 AI 與機器學習基礎,分析大型語言模型的學習歷程與內部運作機制,並透過實際實驗案例說明如何最佳化模型表現。
※ 摘要僅根據標題與說明
Stanford CS229 第 13 課介紹大型語言模型如何預測下一個字,探討其損失函式的機制。
※ 摘要僅根據標題與說明
Stanford CS336 第 17 課介紹如何從頭開始學習語言模型,專注於多模態下的指令跟隨。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
本影片由 AI Fluency 課程介紹什麼是生成式 AI,內容簡潔說明其基本定義與核心概念。
※ 摘要僅根據標題與說明
影片解釋了大語言模型如何將輸入文字轉換成可計算的 token,並說明為何許多開發者誤解此機制。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
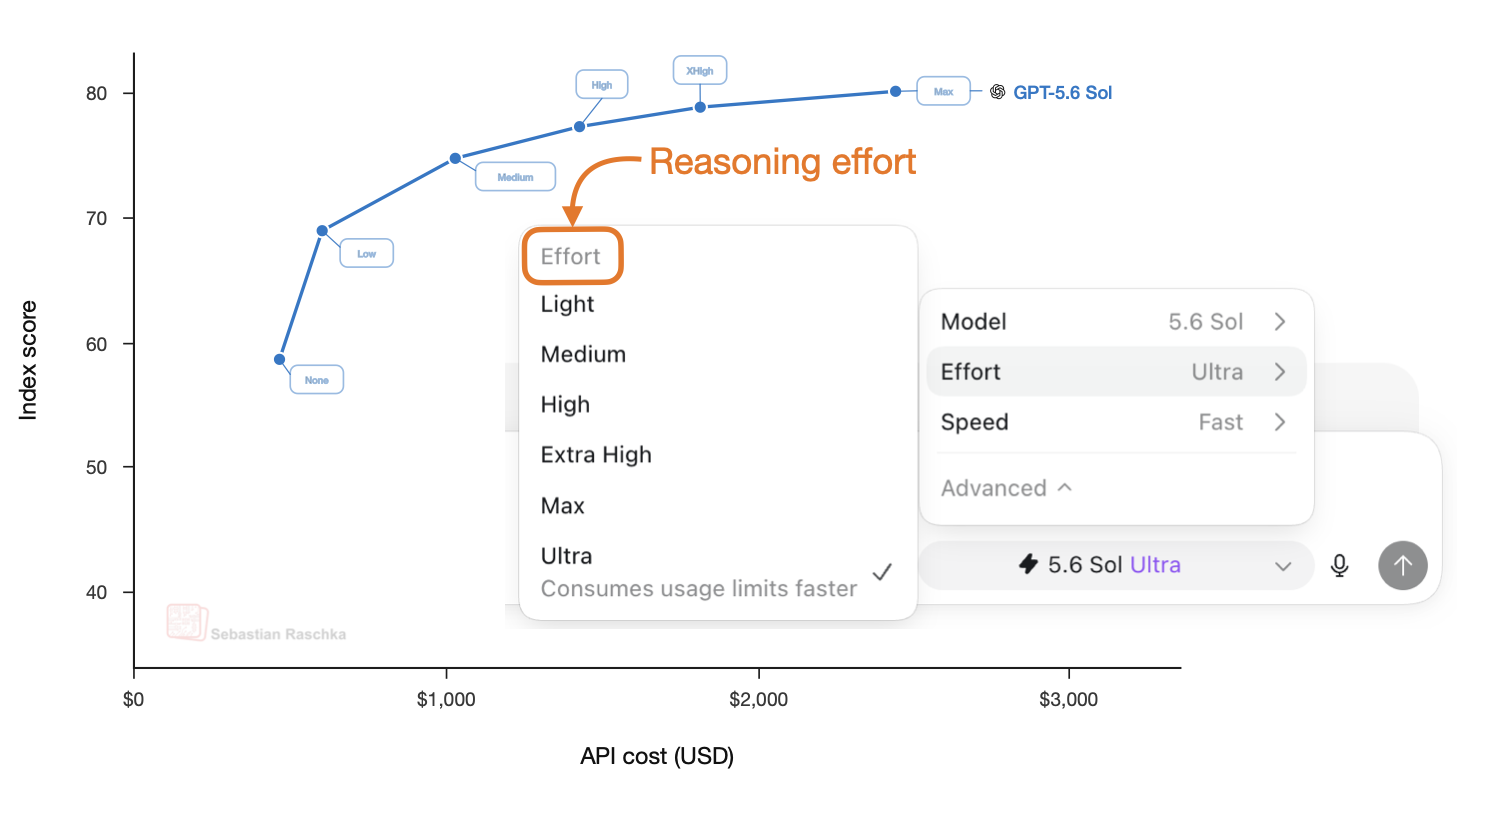
介紹了如何控制大型語言模型(LLM)的推理努力程度,使其具備低、中、高三種模式。透過 RLVR 訓練與推理時排程,模型可根據任務需求切換推理模式。
探討如何從專有 LLM API 中竊取推理痕跡,並說明這可能導致隱私洩露。
※ 摘要僅根據標題與說明
Yao Shunyu 分享他在 Anthropic 與 Gemini 的訓練經驗,探討 AI 領域的未來趨勢。
※ 摘要僅根據標題與說明
Granite 4.2 是 Granite 系列的首個稠密推理 LLM 家族,提供 3B、8B 和 30B 三種規模。它們採用自研的五階段訓練策略,從 15T token 上無預留訓練開始,經過 SFT 和多階段 RL 訓練。
本講解探討生成式 AI 時代下,大型語言模型的推理過程為何應追求足夠而非過長,並闡述如何平衡效率與品質。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
探討 Erdős 問題如何成為 AI 的新研究熱點,並介紹相關數學背景與演演算法應用。
※ 摘要僅根據標題與說明
本講介紹生成式 AI 時代下機器學習的語言模型發展歷程,涵蓋從早期技術到現代演進的完整路徑。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
本講解探討生成式 AI 時代機器學習的技術突破與未來發展,幫助讀者理解這一領域的核心概念。
※ 摘要僅根據標題與說明
Eve Bodnia 指出大型語言模型(LLM)因缺乏內部驗證機制,無法確保關鍵任務(如飛行、金融分析)的正確性。她提出的能量基於模型(EBM)透過物理能量最小化原理,將所有可能結果對映為數學地帶,從而提供可驗證的決策過程。
本講解析語言模型如何從單一神經元演變為整群神經元的運作機制,並探討其內心世界,內容聚焦於生成式 AI 時代的學習原理。
※ 摘要僅根據標題與說明
Stanford 線上課程《Diffusion & Large Vision Models》第七課,探討大語言模型與大視覺模型的評估方法。
※ 摘要僅根據標題與說明
深入解析 LLM 至 Agent Skill 的完整邏輯鏈,涵蓋 Token、Context Window 及 Prompt Engineering 等核心概念,並介紹 Tool 與 MCP 技術,最終掌握如何開發具備自主能力的 Agen…
※ 摘要僅根據標題與說明
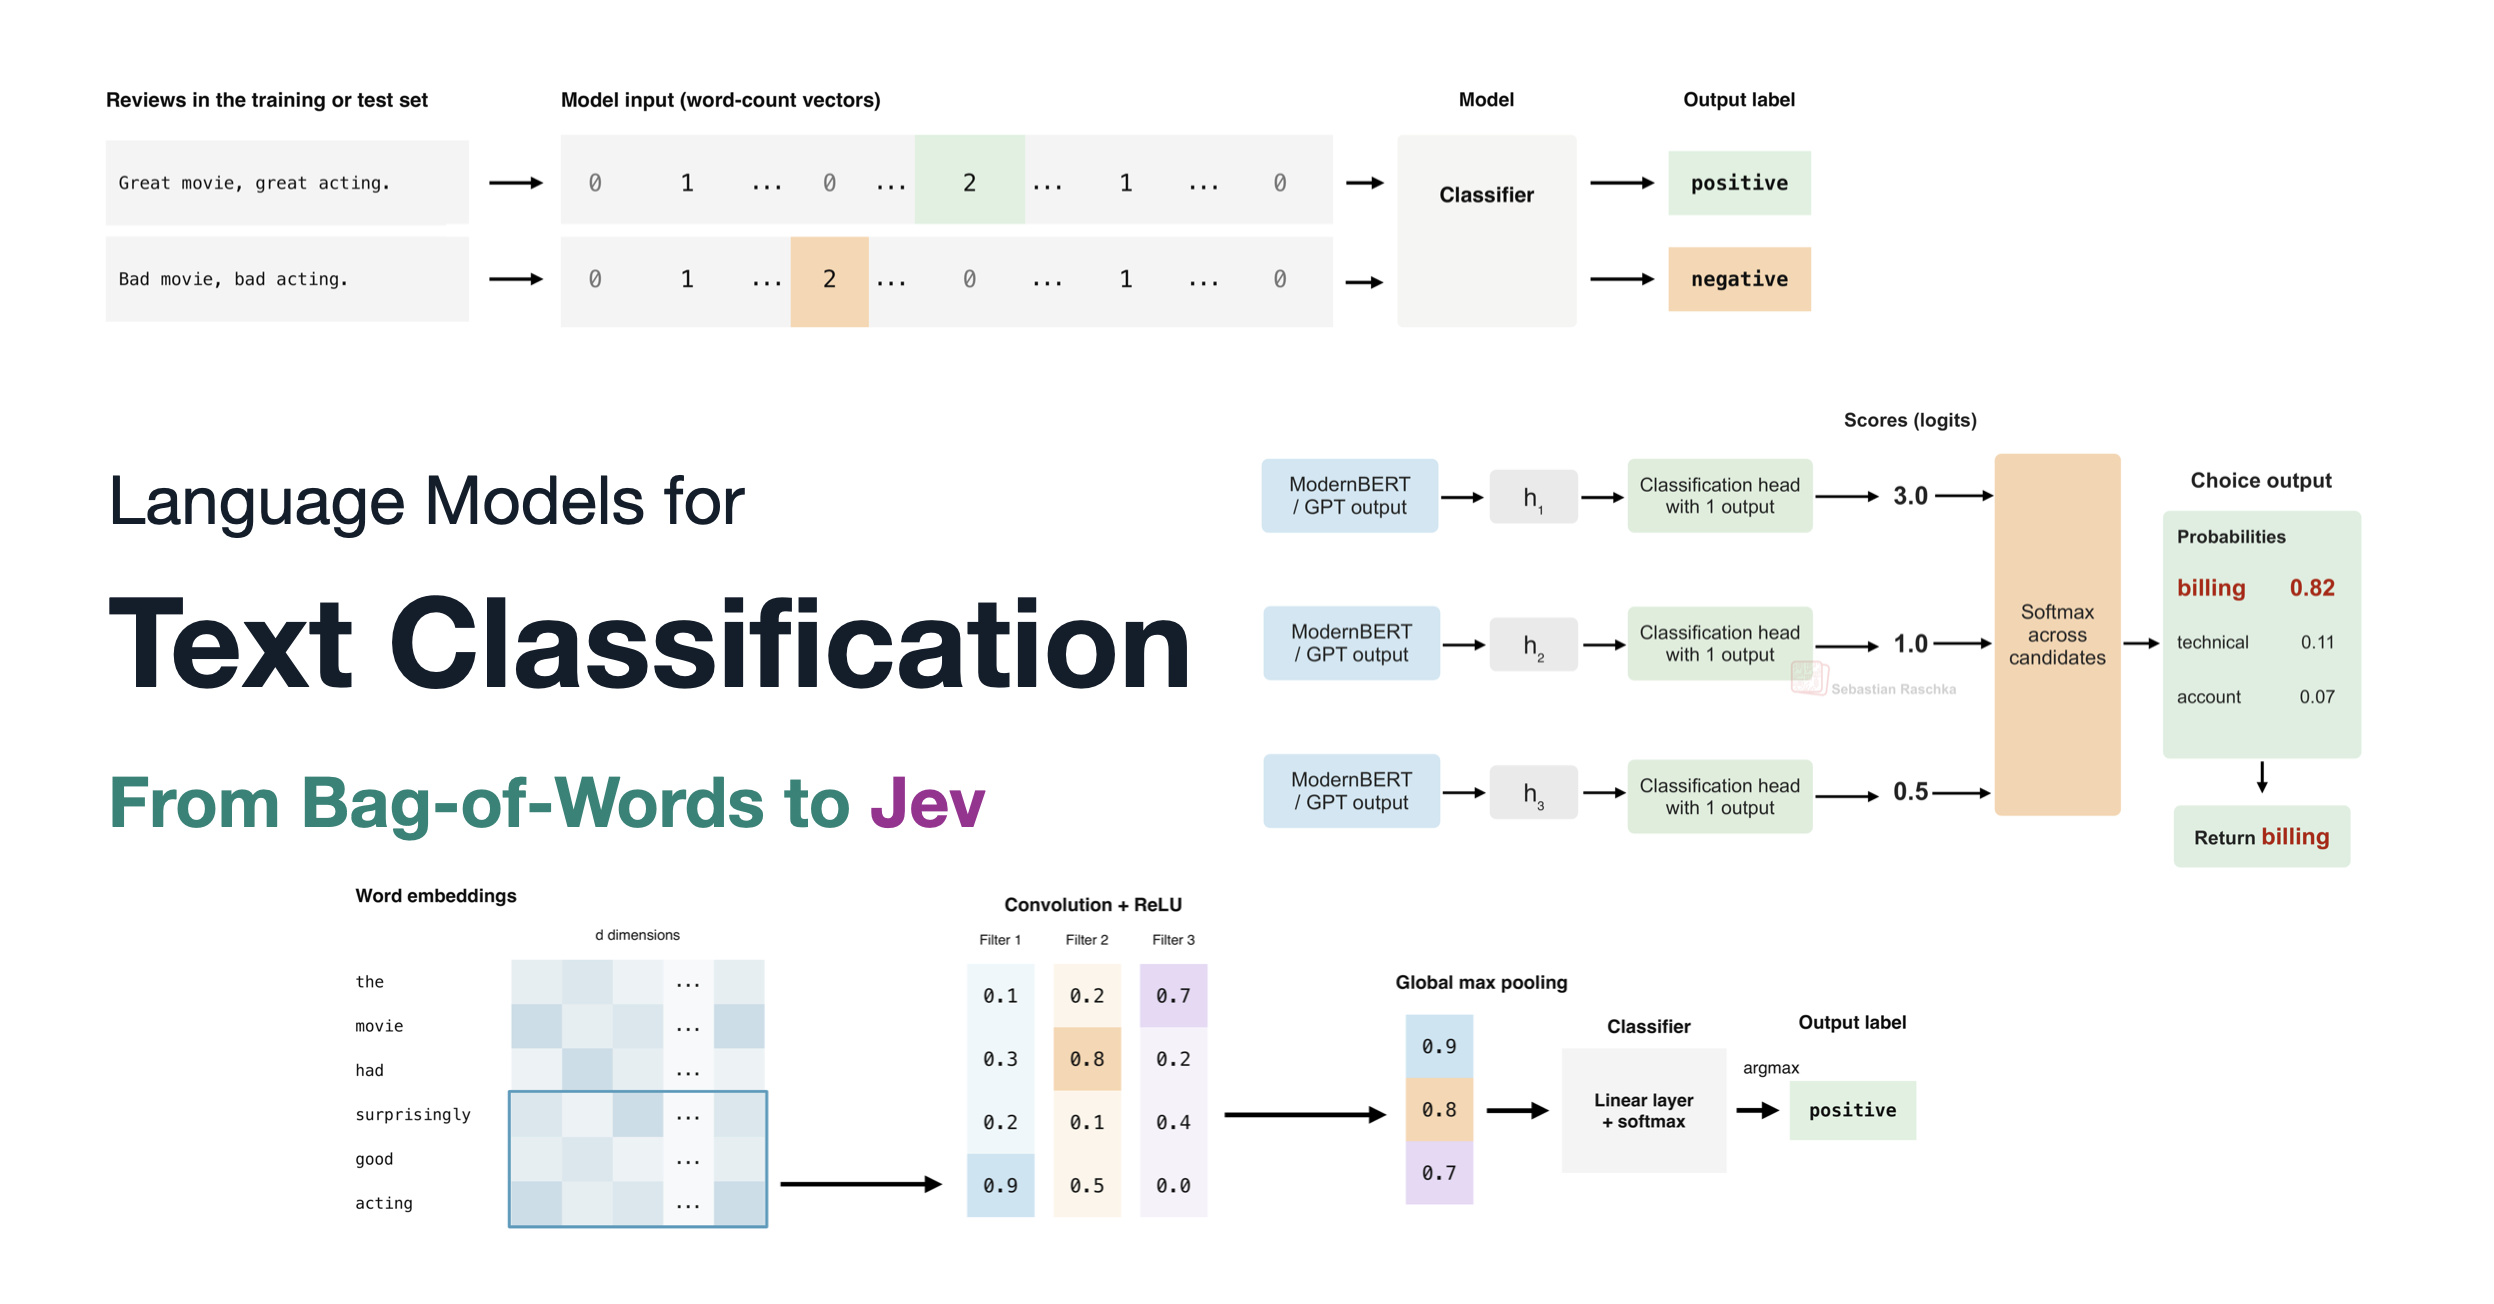
探討了「Jev」模型,一種專為文字分類設計的輕量級語言模型。作者指出,雖然傳統方法如 Bag-of-Words 和深度學習(RNN/CNN)已存在,但 Jev 在處理特定分類任務時比通用大語言模型(LLM)更快且更便宜。
回顧了 2026 年 1 月至 3 月間十款開放權重大語言模型的十款主要發布,涵蓋了從 3B 到 1T 引數的各種架構。文章重點分析了 Arcee Trinity Large、Moonshot Kimi K2.5、StepFun Step…
影片解釋了 LLM 接收到的訊息實際呈現為何,並指出這些訊息可能包含錯誤或無意義的資料,提醒使用者需謹慎處理。
※ 摘要僅根據標題與說明
本講解探討生成式 AI 時代下,大型語言模型訓練的核心方法「預訓練 - 對齊」,解析其強大與極限。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
探討純模型與增強大語言模型推薦器,並比較兩者優缺點。
※ 摘要僅根據標題與說明
介紹了如何啟用 LLM 的「串流」功能,讓回應逐字顯示而非等待整段完成。作者展示了如何使用 SDK 的 stream() 方法,並透過程式碼實作來處理中斷情況,確保即使模型回答不完整,也能正確記錄已完成的內容。
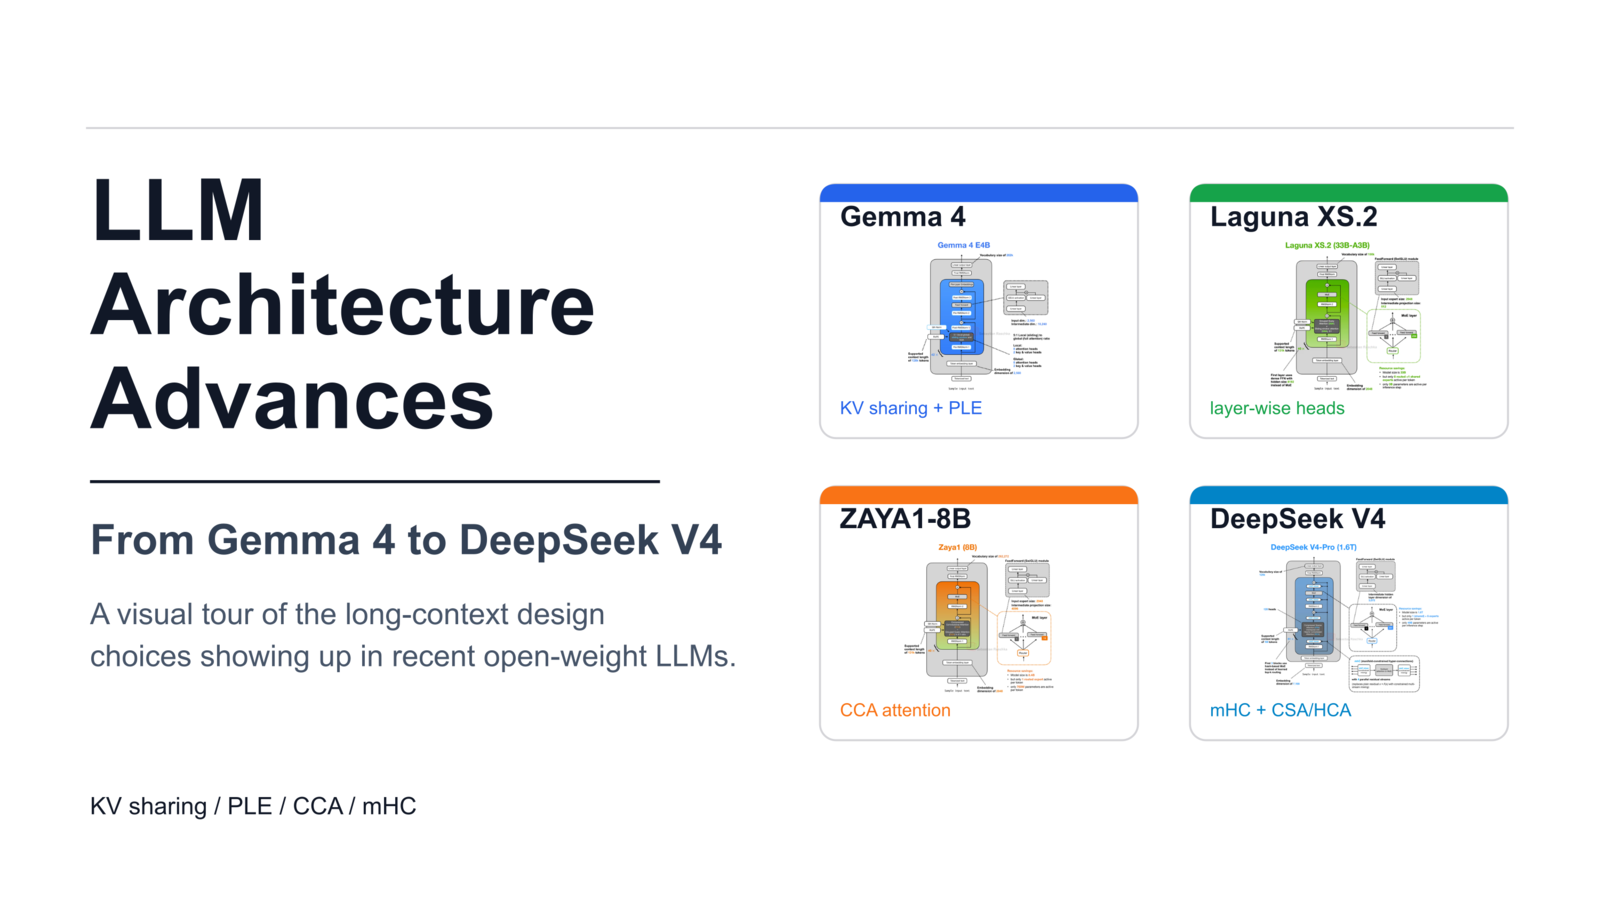
介紹了近期開源大語言模型(LLM)在長文處理效率上的幾項重要架構創新。主要涵蓋了 Gemma 4 的跨層 KV 共享與每層嵌入、Laguna XS.2 的層級注意力預算、ZAYA1-8B 的壓縮凸積注意力,以及 DeepSeek V4 的…
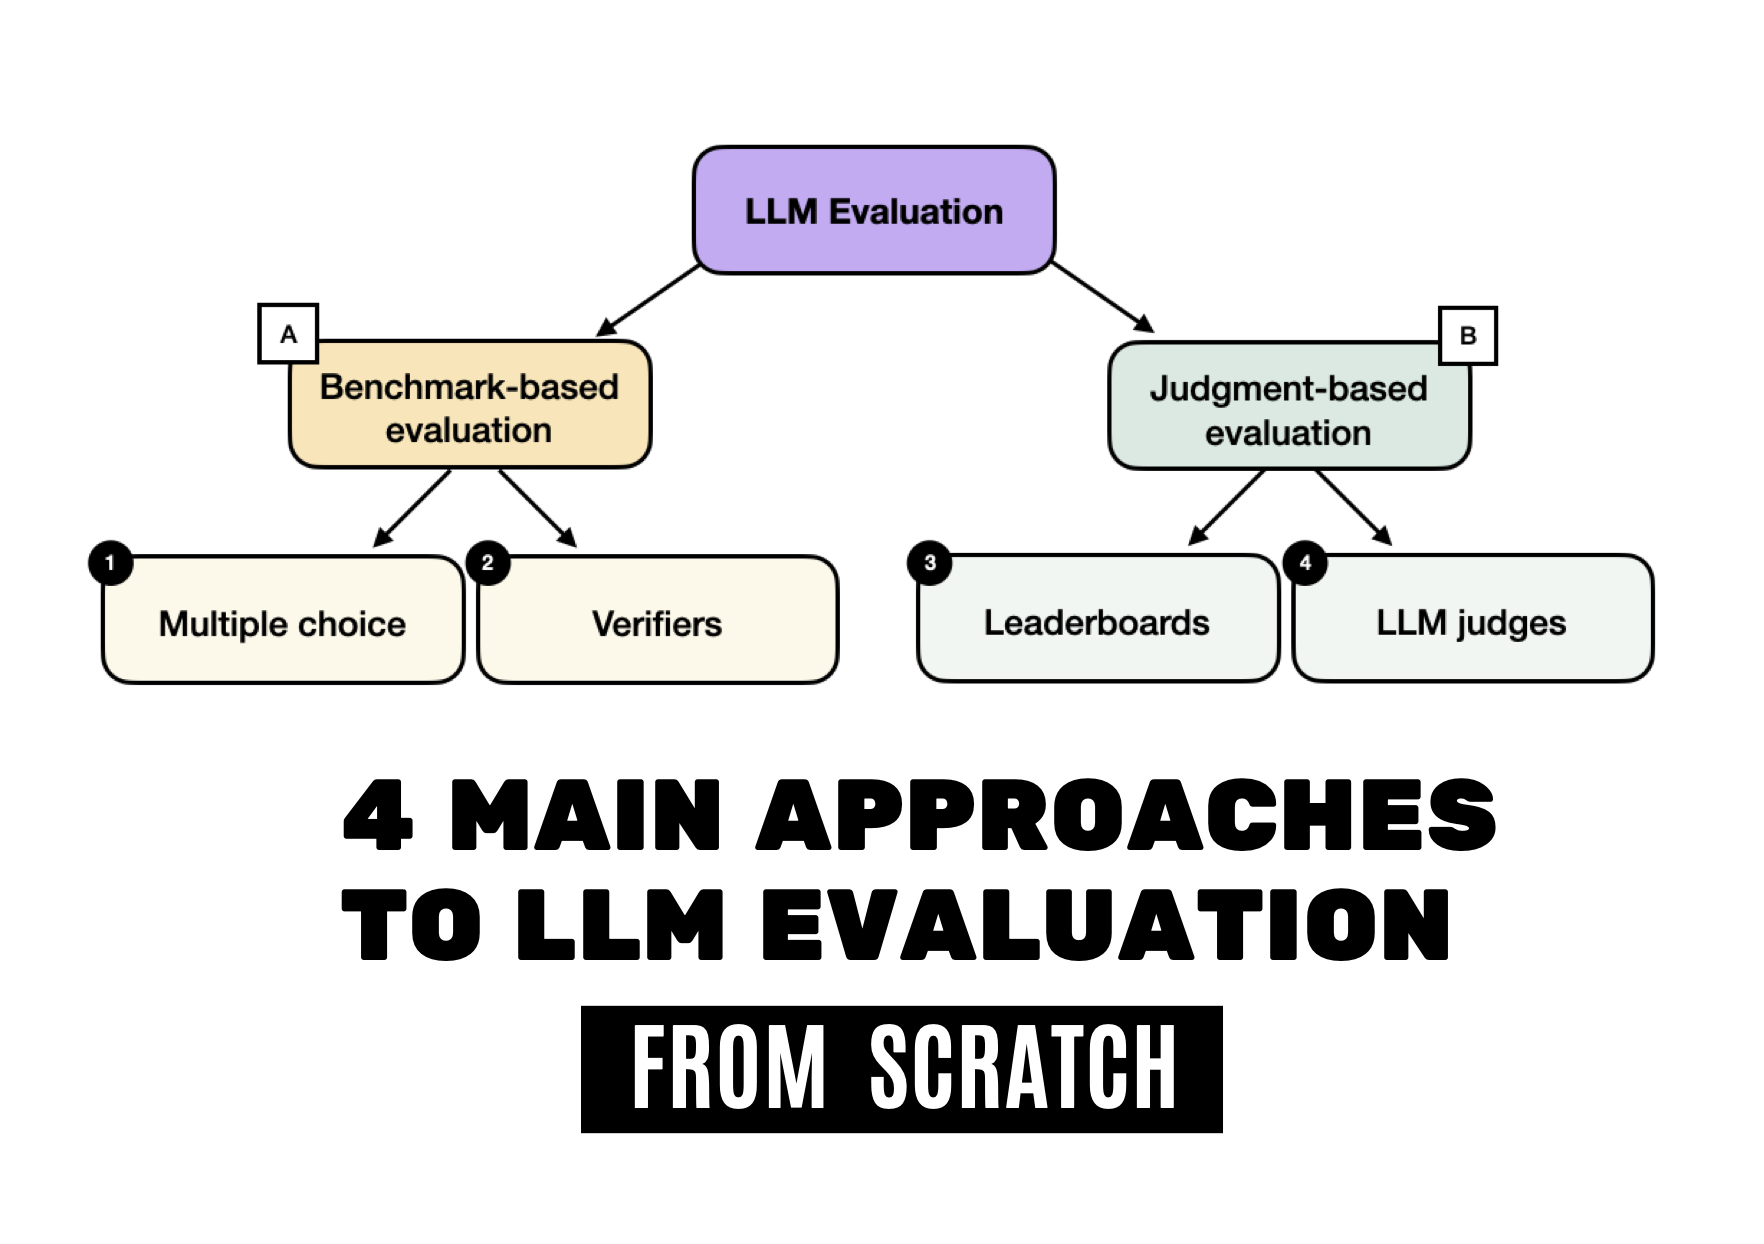
介紹了評估大語言模型(LLM)的四大主流方法:多選題庫、驗證器、排行榜和 LLM 裁判。透過程式碼實作,讀者能理解這些方法的運作原理與優缺點。
分享了他撰寫 AI 教科書的經驗,探討了大語言模型在長篇非虛實寫作中的滯後現象。他認為模型目前仍難以處理需要深度思考、情感表達和獨特觀點的任務,而更擅長處理可驗證的細節和重複性工作。
這篇影片介紹了如何透過外部知識增強大語言模型的推理能力,並提供了一個全面的調查報告,幫助讀者理解相關技術。
※ 摘要僅根據標題與說明
Will England 是 Walleye Capital 執行長,他將整個組織轉型為 AI 導向。他認為拒絕使用 AI 就像 1995 年拒絕使用網路,並分享了自己如何透過 LLM 提升思考效率,以及 Walleye 如何透過記錄會議…
影片解釋了大語言模型如何透過上下文視窗來理解對話,並指出許多開發者對此概念仍存誤解。
※ 摘要僅根據標題與說明
本講探討生成式 AI 時代下機器學習的評分系統問題,並分析大型語言模型的評估方法。
※ 摘要僅根據標題與說明
探討了企業在 AI 時代應如何調整策略。作者指出,像「木頭順紋」這樣的原則可應用於大型語言模型:企業應尊重模型內建的偏好,而非強行編寫規則去「反紋」或強制統一命名規範。
Zhang Peng 談論中國首間上市大語言模型公司的 IPO 程序,並分享相關資訊。
※ 摘要僅根據標題與說明
探討了大型語言模型基礎設施中三個看似不可能並存的矛盾:高可擴充套件性、高可用性和高效能。作者指出,當我們追求極致效能時,往往會犧牲可擴充套件性或可用性,反之亦然。
這篇影片探討大型語言模型(LLM)結合多智慧體系統(MAS)時的創意應用,並進行全面調查。
※ 摘要僅根據標題與說明
依發布時間
Google 於 9 月 30 日推出 Gemini 4 Argon,將輸出 Token 上限從 64K 提升至 100 萬,旨在處理更長的工作流程。
介紹了如何啟用 LLM 的「串流」功能,讓回應逐字顯示而非等待整段完成。作者展示了如何使用 SDK 的 stream() 方法,並透過程式碼實作來處理中斷情況,確保即使模型回答不完整,也能正確記錄已完成的內容。
本場次探討 AI 模擬人類行為的潛力與挑戰。教授指出,由於決策常基於不完整的資訊,我們常做出錯誤猜測。雖然 Agent-based models 和生成式模擬已有應用,但現有方法往往過於簡化或刻板。
探討了「Jev」模型,一種專為文字分類設計的輕量級語言模型。作者指出,雖然傳統方法如 Bag-of-Words 和深度學習(RNN/CNN)已存在,但 Jev 在處理特定分類任務時比通用大語言模型(LLM)更快且更便宜。
探討了大模型能力突變帶來的安全挑戰,強調安全不僅是技術加固,更需融入企業文化並培養員工的適應力。作者呼籲全球組織思考如何應對突發的 AI 能力跳躍,確保人、系統與流程具備足夠的韌性與應變能力。
介紹了 Lenny 的 How I AI 系列中關於 Jev 決策模型的實戰應用,以及作者為何在離開 Claude 後選擇 Opus 5.5 的原因。Jev 是一種決策模型而非語言模型,能將任務成本降低至每百萬字僅 4 美分。
Jev 是 TypeSafe AI 推出的新型決策模型,它返回型別安全的結構化值(如選擇、分數、機率),而非生成式文字。該模型每百萬輸入字元僅 4 美分,且無輸出費用。
Lakshya A. Agrawal 介紹 GEPA,一種利用語言模型對完整執行軌跡進行反思的樣本高效替代方案,可大幅減少 RL 所需的滾動測試次數。
Yves Raimond 與 Jacqueline Wood 探討如何讓大語言模型學會說歌單,並分析 Spotify 的資料如何影響 AI 的學習。
※ 摘要僅根據標題與說明
Meta 的 Devansh Tandon 在影片中探討 LLM 推薦器將成為 AI 領域最大的使用者應用程式,並分析其發展趨勢。
※ 摘要僅根據標題與說明
探討 DoorDash 如何將大型語言模型用於搜尋與個人化,而非直接服務使用者。
※ 摘要僅根據標題與說明
本訪談探討 OpenRouter 如何從早期開源模型中崛起,成為連線開發者的中立路由層,並與 Stripe 合作以應對 AI 經濟中的 Token 詐騙問題。