文章高階EN
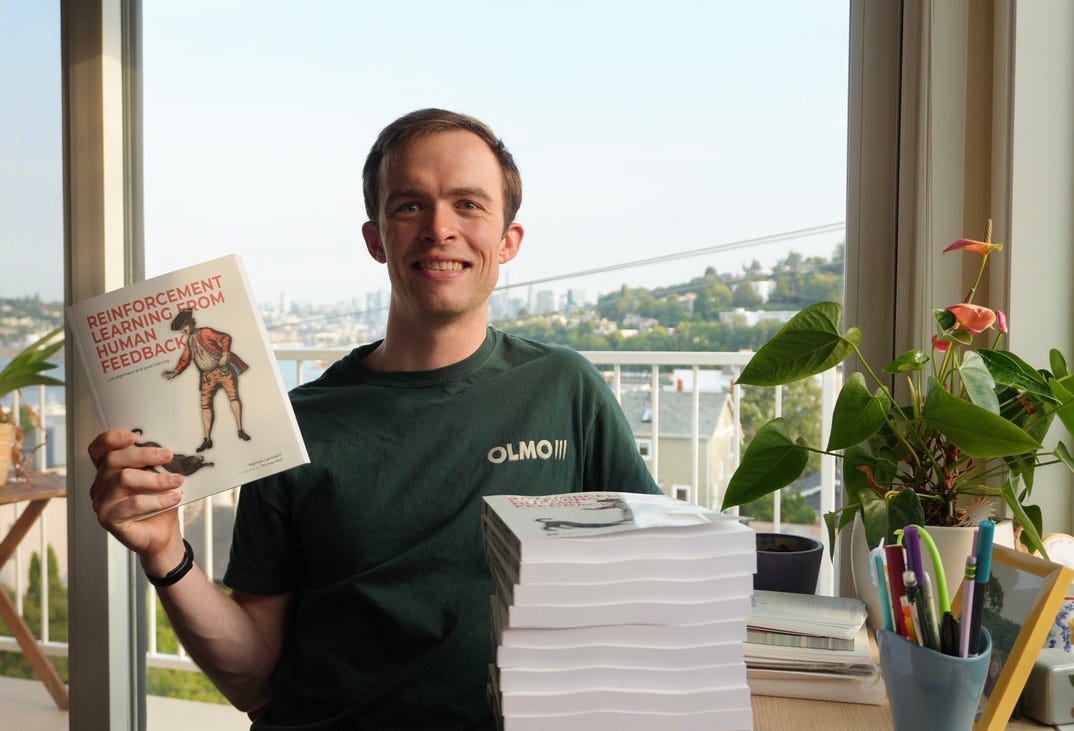
5 useful things you'll learn in my new post-training textbook (shipping now!)
讀原文(在新分頁開啟原站)連到 Nathan Lambert(部落格)
摘要
本書是作者整理多年的開源模型訓練經驗,涵蓋人類回傳強化學習(RLHF)的後訓練技術。內容從 RL 演算法的直覺、系統設計、歷史背景到蒸餾與訓練挑戰,提供從零基礎到深入理解的完整指南,適合有 CS 背景但想掌握現代 LLM 訓練實戰技巧的讀者。
This book consolidates the author's years of experience training open models, covering core RLHF post-training techniques from algorithm intuitions to system design and distillation, suitable for CS graduates seeking practical LLM training insights.
重點
- 本書涵蓋 RLHF 後訓練核心技術,從演算法直覺到系統設計,適合有 CS 背景者。
- 內容包含 RL 演算法直覺、系統平衡、歷史背景、蒸餾技術及訓練挑戰。
- 適合有 CS 背景、想深入理解 LLM 訓練實戰技巧的讀者。
提到的工具與公司
- Manning
- PPO
- GRPO
- CISPO
- DAPO
- Dr. GRPO
- Xiaomi MiMo-V2-Flash
適合誰看
有 CS 背景、想深入理解 LLM 訓練實戰技巧的讀者。
摘要依據
- 講者
- Nathan Lambert
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.82
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- 【生成式AI導論 2024】第8講:大型語言模型修練史 — 第三階段: 參與實戰,打磨技巧 (Reinforcement Learning from Human Feedback, RLHF)影片 ・ Hung-yi Lee ・ 37 分鐘(在新分頁開啟原站)
- Reinforcement Learning from Human Feedback explained with math derivations and the PyTorch code.影片 ・ Umar Jamil ・ 2 小時 15 分(在新分頁開啟原站)
- Reinforcement Learning with Human Feedback (RLHF), Clearly Explained!!!影片 ・ StatQuest with Josh Starmer ・ 18 分鐘(在新分頁開啟原站)
- Reinforcement Learning with Human Feedback (RLHF) in 4 minutes影片 ・ Sebastian Raschka ・ 4 分鐘(在新分頁開啟原站)
- 【生成式AI導論 2024】第3講:訓練不了人工智慧?你可以訓練你自己 (上) — 神奇咒語與提供更多資訊影片 ・ Hung-yi Lee ・ 35 分鐘(在新分頁開啟原站)
- Should You Train Your Own Model?影片 ・ Mastra ・ 24 分鐘(在新分頁開啟原站)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)