从DeepSeek、Kimi到“黄仁勋联盟”:AI模型开源,到底“开”了什么?(在新分頁開啟原站)
探討 AI 模型從「完全開源」到「開放權重」的演變,並對比 DeepSeek、Kimi 等主流模型的差異。作者透過前 Hugging Face 負責人與 TinyFish 創始人的視角,解析開放權重模型如何重塑產業生態,並揭示其商業邏輯與…
11.8 萬次觀看
※ 摘要僅根據標題與說明
Open Models ・ 97 筆內容
Llama、Qwen、DeepSeek、Gemma、Mistral 等可自行下載的模型與其生態。
也叫做:開源模型、开源模型、open source model、open-source models、open weights、Llama、Qwen、DeepSeek、Gemma、Mistral、Hugging Face
依相關、人氣、新鮮度綜合排序;站長推薦的加成
探討 AI 模型從「完全開源」到「開放權重」的演變,並對比 DeepSeek、Kimi 等主流模型的差異。作者透過前 Hugging Face 負責人與 TinyFish 創始人的視角,解析開放權重模型如何重塑產業生態,並揭示其商業邏輯與…
※ 摘要僅根據標題與說明
這篇文章列舉了過去幾年關於開放式 AI 模型的關鍵文章,涵蓋了開放模型的定義、商業策略、經濟影響、安全風險以及中美模型競爭等議題。讀者可以透過這些資源全面了解開放模型現狀,並掌握如何評估其風險與優勢。
OpenAI 宣佈將免費開放 10 萬名學者的前沿模型,讓學術界能更輕鬆地接觸最新技術。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
Moonshot AI 推出 Kimi K3,這是近來最接近開源前沿的模型之一。文章指出,中美模型效能差距縮短至 3-5 個月,顯示中國實驗室在資源效率、架構創新和文化自由度上取得顯著進展。
※ 摘要僅根據標題與說明
Z.ai 執行長 Li 介紹 GLM-5.2,該模型在長程程式碼與代理任務的測試中表現優異,甚至超越非思考模式。Li 解釋了 GLM 名稱的由來及其超越程式碼的潛力,並強調 Z.ai 開放權重策略,讓企業與政府能自行部署與調教模型。
※ 摘要僅根據標題與說明
NVIDIA 的 Ming-Yu Liu 闡述了「開放模型」對於 AI 生態系的重要性,特別是對於物理 AI 的未來。透過開放模型,開發者能更快速理解模型原理、進行本地化部署,並透過開放資料與訓練框架進行創新。
探討 Nvidia 如何透過開放權重模型(如 Nemotron)來降低 AI 訓練門檻,讓更多人能自行開發模型以獲取 Token。作者指出,雖然 Nvidia 投入巨大,但未來是否成功取決於能否建立自給自足的經濟迴圈,否則將依賴外部資金。
探討了開放式大模型的現狀,重點包括 Kimi K3 的發布、中國與美國模型的競爭、以及模型蒸餾的爭議。節目指出雖然中國模型在效能上領先,但開源模型仍面臨資料和訓練時間的挑戰。
Peter Gostev 介紹了 GPT-6 Astra 模型,這是 OpenAI 最新推出的大型語言模型,主要用於處理多模態資料。
※ 摘要僅根據標題與說明
分析了 2026 年夏季 Hugging Face 開放模型生態的現狀。中國實驗室在模型規模上已超越美國,並透過量化技術讓大模型更易部署。
GLM-5.2 與 MiniMax-M3 在 AI 分析指數上並列第一,且價格僅為 Opus 4.8 的五分之一。這標誌著開源大模型已不再是邊緣選擇,而是具備實質競爭力的新勢力。
※ 摘要僅根據標題與說明
這則影片介紹了終於出現的 Karpathy LLM Wiki 開放標準,讓使用者能自由存取與使用。
※ 摘要僅根據標題與說明
介紹了 cURL 這個網路工具如何從 28 年前開始,經歷多次改動與維護,最終成為目前最活躍的開源專案之一。
※ 摘要僅根據標題與說明
本訪談探討 OpenRouter 如何從早期開源模型中崛起,成為連線開發者的中立路由層,並與 Stripe 合作以應對 AI 經濟中的 Token 詐騙問題。
探討 Reflection AI 是否可能取代美國 DeepSeek 的開源模型地位,內容聚焦於模型競爭與技術挑戰。
※ 摘要僅根據標題與說明
探討了近期 AI 領域的動態,包括美國對中國開放模型的潛在政策限制、Kimi K3 與 Qwen 3.8 等開放權重模型的競爭,以及 Hugging Face 因安全事件被迫使用本地模型進行反駁的實證案例。
DeepSeek、Qwen3.8-Flash、GLM-5.3-Flash 等模型因價格高昂遭遇「斬殺線」,引發大模型價格戰。
※ 摘要僅根據標題與說明
報導了 AI 領域的一連串動態,包括 OpenAI 與 Hugging Face 發生的一場未預期的網路攻擊事件,以及 Google Gemini 3.5 Flash Cyber 等專化模型在攻防方面的表現。
本訪談探討 AI 領域的「開放原始主義」,指出 DeepSeek 以 500 萬美元開發出頂級模型,而西方企業仍誤以為 Meta 的 Llama 是真正的開源。
※ 摘要僅根據標題與說明
探討 2026 年「模型戰爭」是否成為虛無,並指出物理 AI 與邊緣裝置的興起讓許多場景不再依賴中心雲端計算。節目強調 agentic 系統、工作流與 AI 基礎設施的轉變才是未來價值所在,而非單純比較開源與閉源模型的表現。
※ 摘要僅根據標題與說明
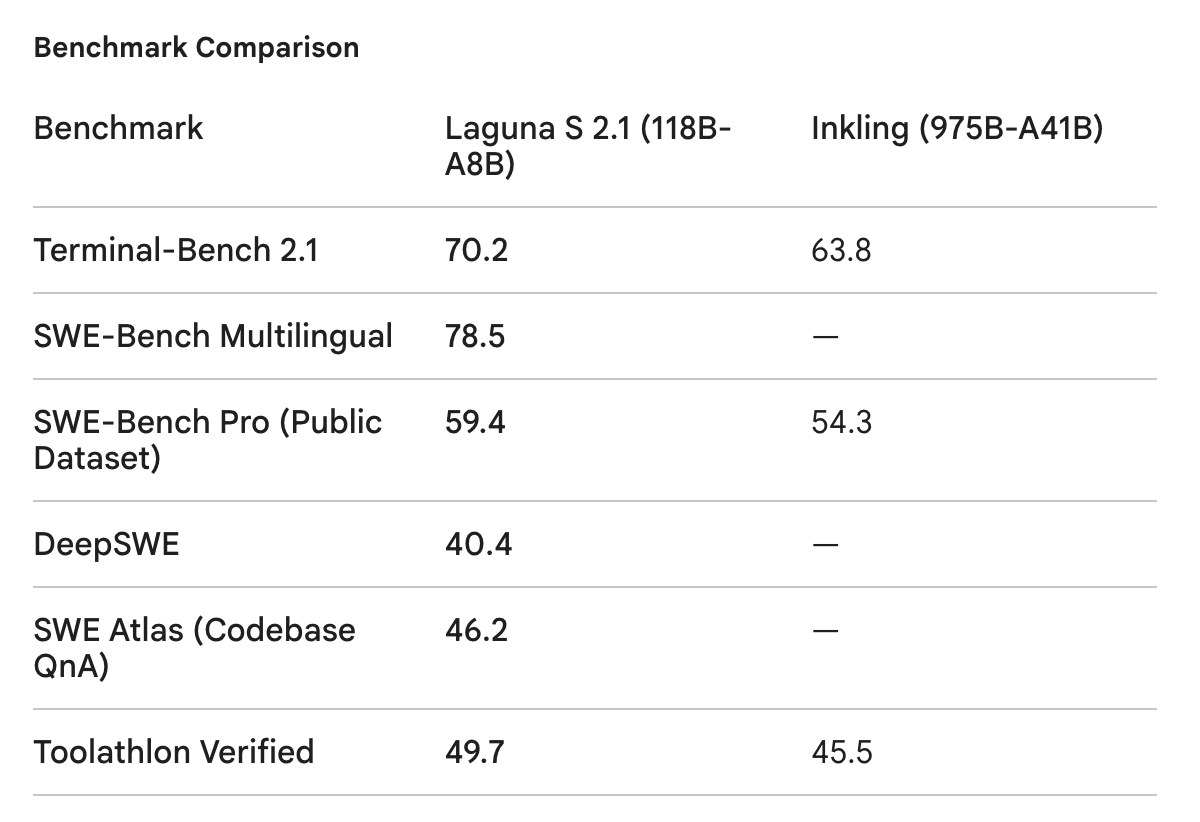
Poolside AI 推出 Laguna S 2.1,其模型體積超越 Thinking Machines 近十倍。創辦人 Eiso Kant 透過「Model Factory」系統,在八週內完成從預訓練到發布的全流程,並強調透過開放權重…
※ 摘要僅根據標題與說明
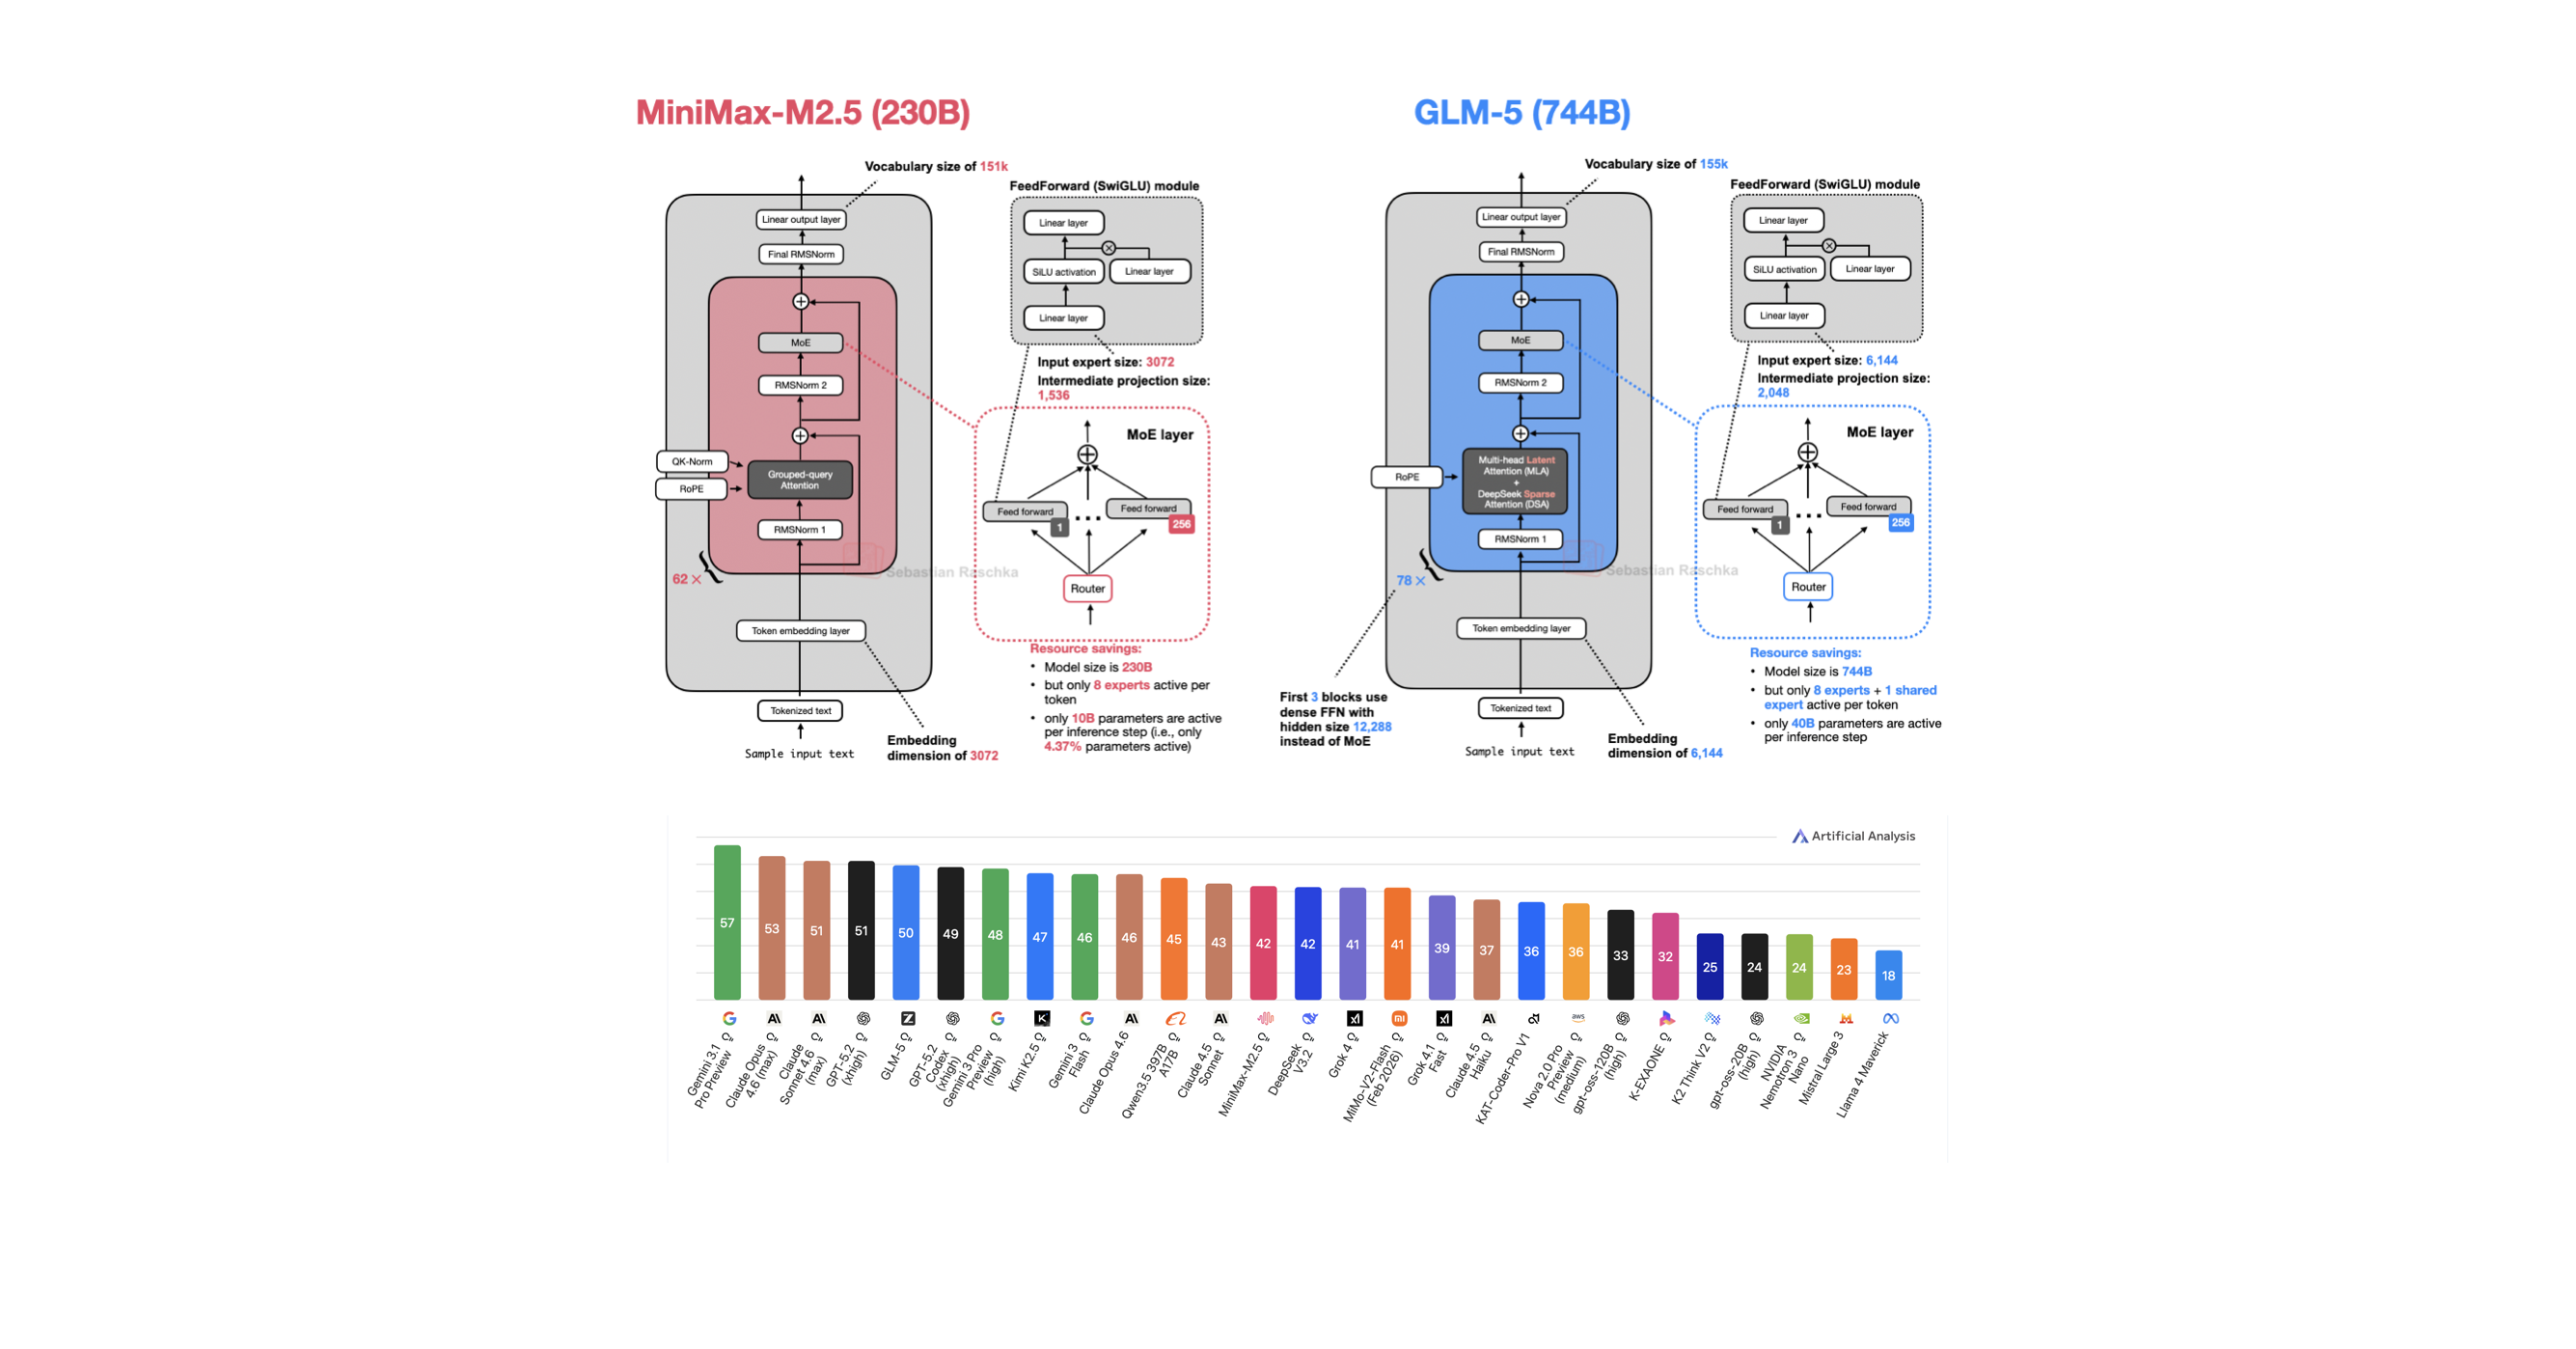
回顧了 2026 年 1 月至 3 月間十款開放權重大語言模型的十款主要發布,涵蓋了從 3B 到 1T 引數的各種架構。文章重點分析了 Arcee Trinity Large、Moonshot Kimi K2.5、StepFun Step…
本訪談探討 Comma AI 如何利用開放原始碼 OpenPilot 將自駕技術普及化。主持人與 Harald Schäfer 討論了從早期未整合的自駕系統到如今高普及率的現狀,強調開放原始碼對促進創新與透明度的重要性。
馬斯克帝國即將合一?影片探討 MoltBook 之亂與 Kimi K2.5 最強開源模型,並指出其特別技術亮點。
※ 摘要僅根據標題與說明
探討馬斯克帝國整合趨勢,並介紹 Kimi K2.5 作為最強開源模型,同時深入解析 MoltBook 的獨特技術亮點。
※ 摘要僅根據標題與說明
依發布時間
介紹了 Olmo-core 3,這是 Hugging Face 推出的大型混合專家(MoE)訓練架構升級版。它旨在將訓練規模擴充套件至十億引數級別,同時保持計算效率。
NVIDIA 的 Ming-Yu Liu 闡述了「開放模型」對於 AI 生態系的重要性,特別是對於物理 AI 的未來。透過開放模型,開發者能更快速理解模型原理、進行本地化部署,並透過開放資料與訓練框架進行創新。
介紹了 Open TTS Leaderboard,旨在解決開放源 TTS 模型評測碎片化問題。該板塊使用視覺化指標(如 WER、RTFx、SIM)替代傳統的人工偏好評分,讓評測更快速且具可比性。
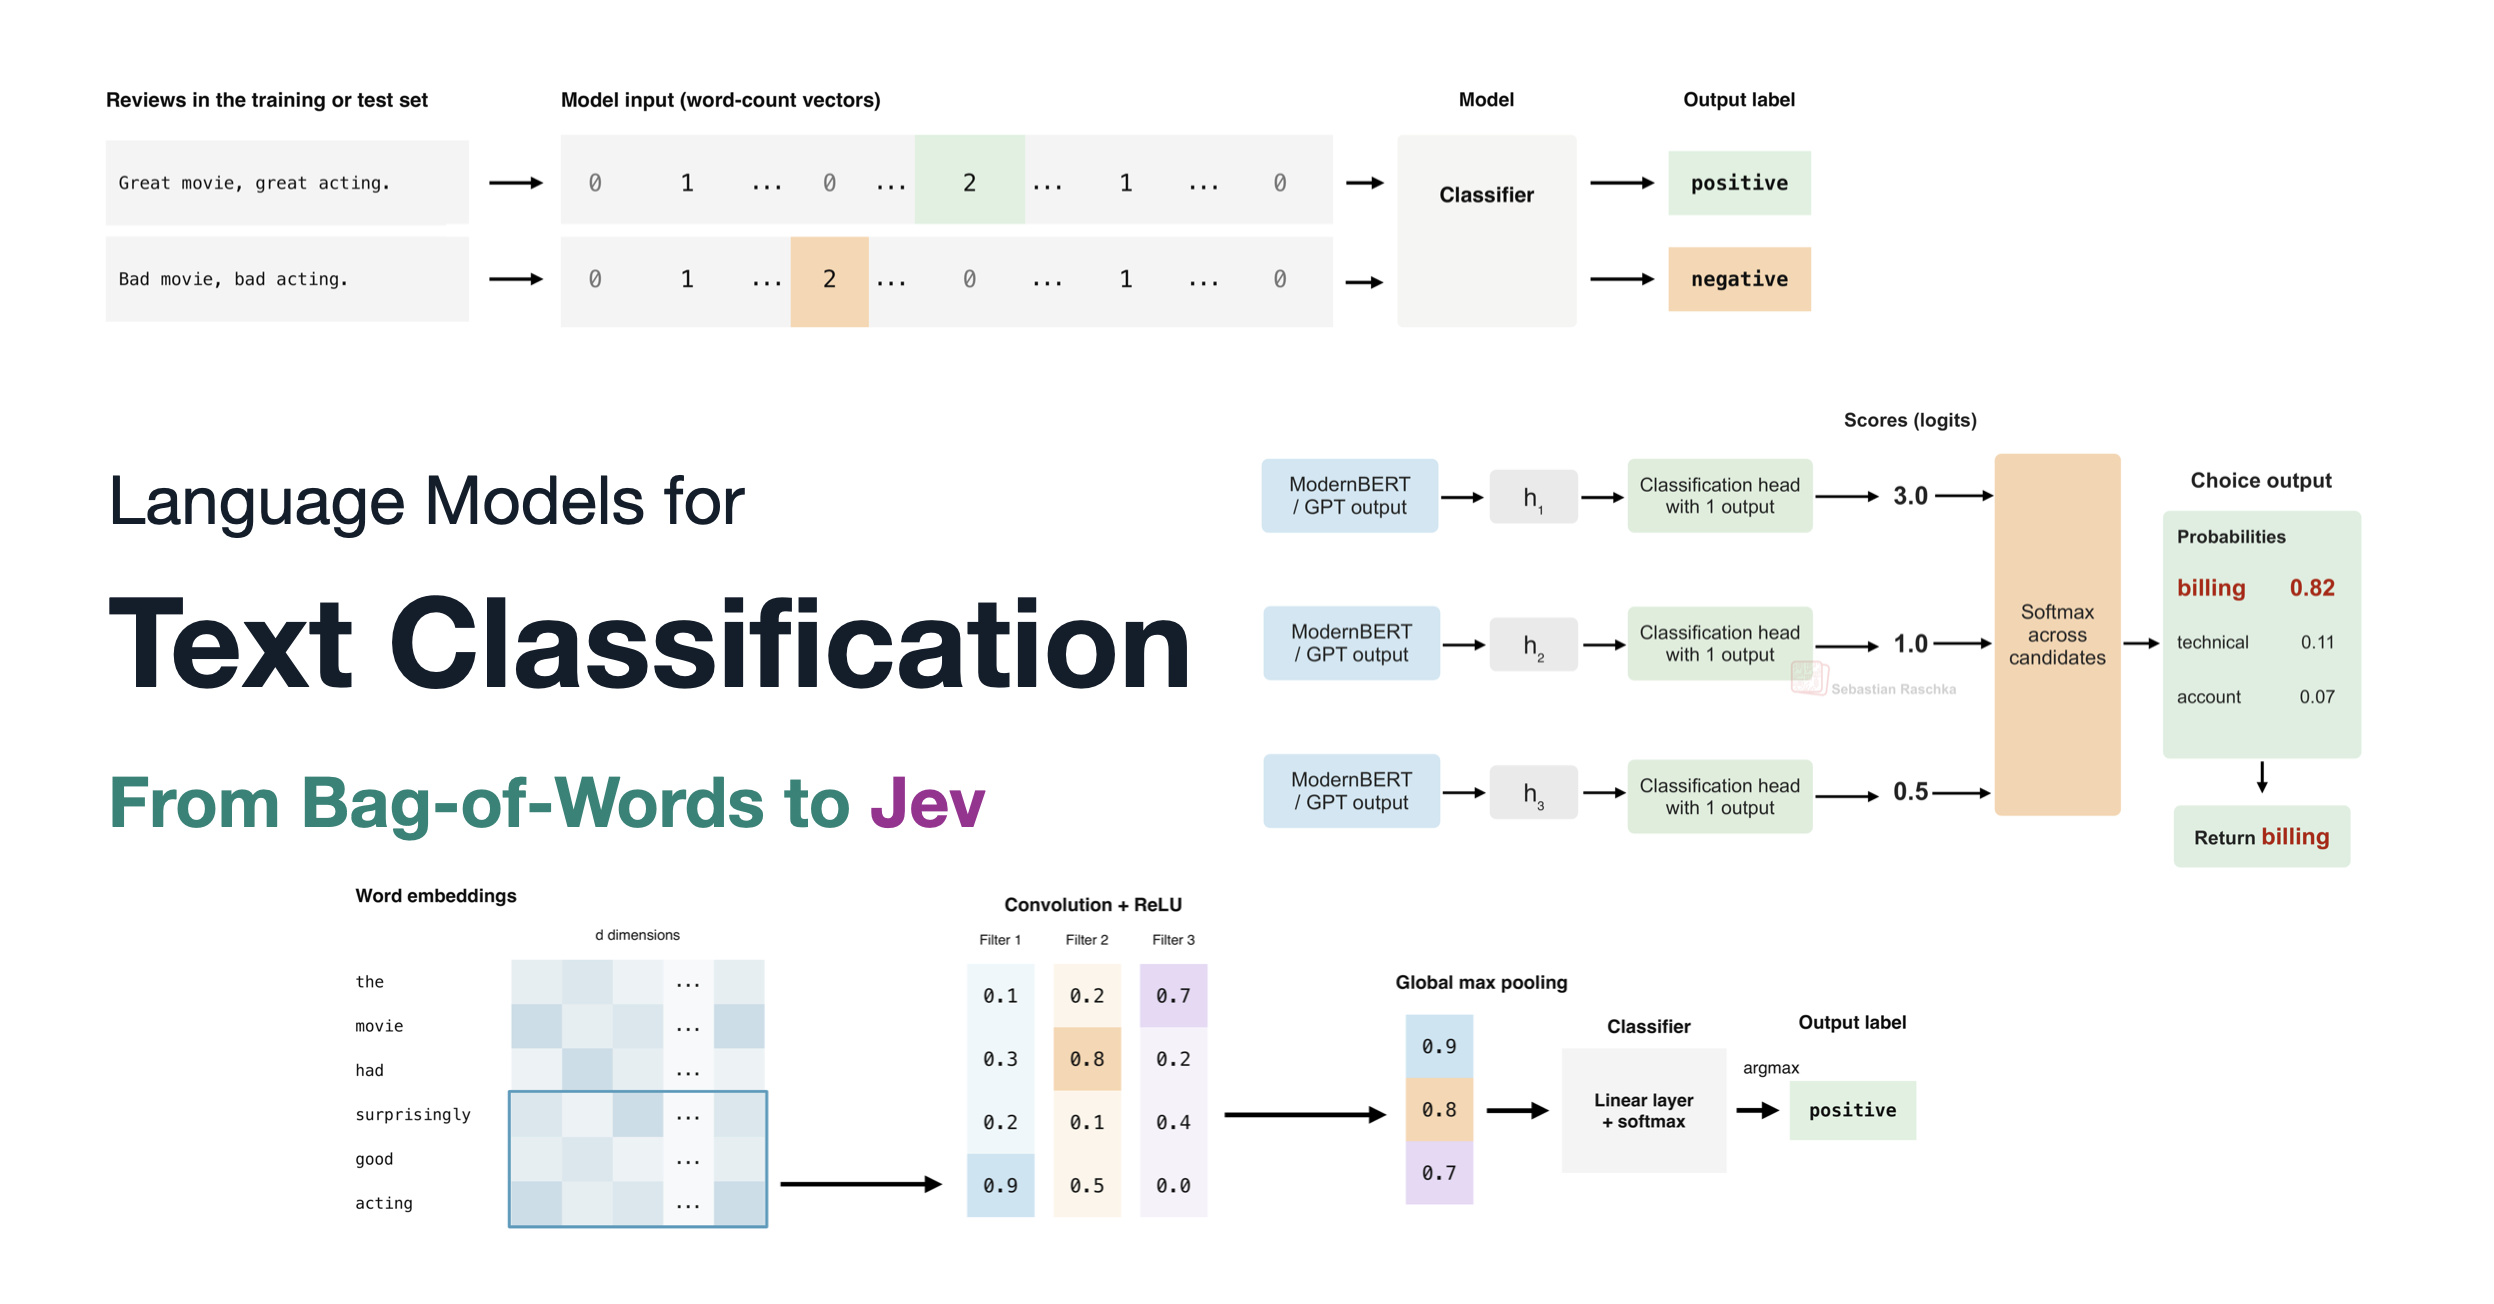
探討了「Jev」模型,一種專為文字分類設計的輕量級語言模型。作者指出,雖然傳統方法如 Bag-of-Words 和深度學習(RNN/CNN)已存在,但 Jev 在處理特定分類任務時比通用大語言模型(LLM)更快且更便宜。
梁文鋒在 Best Partners TV 公開 DeepSeek 的 Agent 訓練沙盒平台 DSec 技術細節。該平台支援 V3.2 至 V4.1 版本,提供 FnCall、容器、Firecracker 微 VM 及完整 VM 四種…
※ 摘要僅根據標題與說明
Z.ai 執行長 Li 介紹 GLM-5.2,該模型在長程程式碼與代理任務的測試中表現優異,甚至超越非思考模式。Li 解釋了 GLM 名稱的由來及其超越程式碼的潛力,並強調 Z.ai 開放權重策略,讓企業與政府能自行部署與調教模型。
※ 摘要僅根據標題與說明
本訪談探討 OpenRouter 如何從早期開源模型中崛起,成為連線開發者的中立路由層,並與 Stripe 合作以應對 AI 經濟中的 Token 詐騙問題。
介紹 DeepSeek V4.1 Flash 與 Bonsai 2 兩大技術,大幅壓縮 KV Cache 與模型權重。DeepSeek V4.1 Flash 將 Token 的 KV Cache 壓縮至 1KB,DeepSeek 將 V1…
AI Engineer Paris 2026 開場演講,聚焦 Mistral、Langfuse 與 Sizzy 等 AI 相關主題,內容涵蓋最新趨勢與技術應用。
※ 摘要僅根據標題與說明
指出,部署大型視覺語言模型存在風險,建議改用專為特定技能設計的模型來解決問題。
※ 摘要僅根據標題與說明
介紹了 cURL 這個網路工具如何從 28 年前開始,經歷多次改動與維護,最終成為目前最活躍的開源專案之一。
※ 摘要僅根據標題與說明
這篇文章列舉了過去幾年關於開放式 AI 模型的關鍵文章,涵蓋了開放模型的定義、商業策略、經濟影響、安全風險以及中美模型競爭等議題。讀者可以透過這些資源全面了解開放模型現狀,並掌握如何評估其風險與優勢。