讀原文(在新分頁開啟原站)連到 Sebastian Raschka(部落格)
摘要
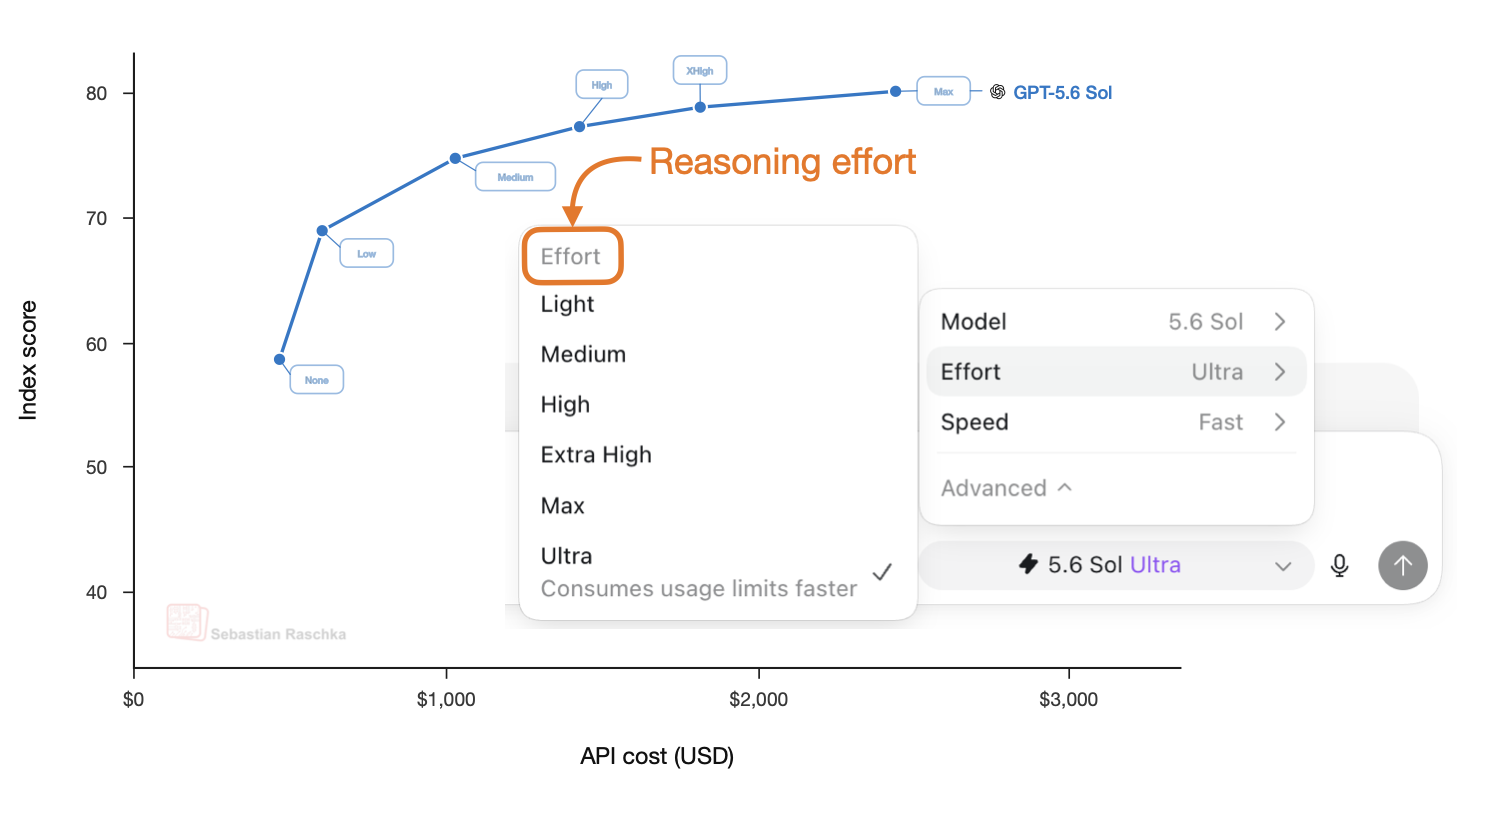
介紹了如何控制大型語言模型(LLM)的推理努力程度,使其具備低、中、高三種模式。透過 RLVR 訓練與推理時排程,模型可根據任務需求切換推理模式。文章詳述了 DeepSeek-R1、GPT-5.6 等模型的訓練與推理機制,並列舉了多項開源模型(如 Qwen3、DeepSeek V4)的實際實作方案。
This article explains how to control Large Language Model (LLM) reasoning effort levels, enabling low, medium, and high modes. Through RLVR training and inference scheduling, models can switch reasoning modes based on task requirements. The article details the training and inference mechanisms of L1…
重點
- 模型具備低、中、高三種推理努力模式,可根據任務需求切換。
- 透過 RLVR 訓練與推理時排程,模型可根據任務需求切換推理模式。
- 多項開源模型(如 Qwen3、DeepSeek V4)已實作此功能。
提到的工具與公司
- RLVR
- SFT
- DeepSeek-R1
- GPT-5.6
- Qwen3
- DeepSeek V4
適合誰看
AI 開發者、程式設計師、模型研究者。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.75
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- State of LLMs 2026: RLVR, GRPO, Inference Scaling — Sebastian RaschkaPodcast ・ The MAD Podcast ・ 1 小時 8 分(在新分頁開啟原站)
- The State Of LLMs 2025: Progress, Problems, and Predictions文章 ・ Sebastian Raschka(部落格)
- 【生成式AI時代下的機器學習(2025)】第七講:DeepSeek-R1 這類大型語言模型是如何進行「深度思考」(Reasoning)的?影片 ・ Hung-yi Lee ・ 1 小時 18 分(在新分頁開啟原站)
- Looped LLM? Recurrent Depth Transformer Explained影片 ・ bycloud ・ 19 分鐘(在新分頁開啟原站)
- Granite 4.2 LLMs: How They're Built文章 ・ Hugging Face Blog
- Build A Reasoning Model From Scratch 3: The Verifier for Evaluation and RL with Verifiable Rewards影片 ・ Sebastian Raschka ・ 1 小時 27 分(在新分頁開啟原站)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)