Sebastian Raschka
12 筆內容・被提到 1 筆 ・ 9.8 萬 訂閱
《Build a Large Language Model (From Scratch)》作者
他的來源
最受歡迎
依人氣
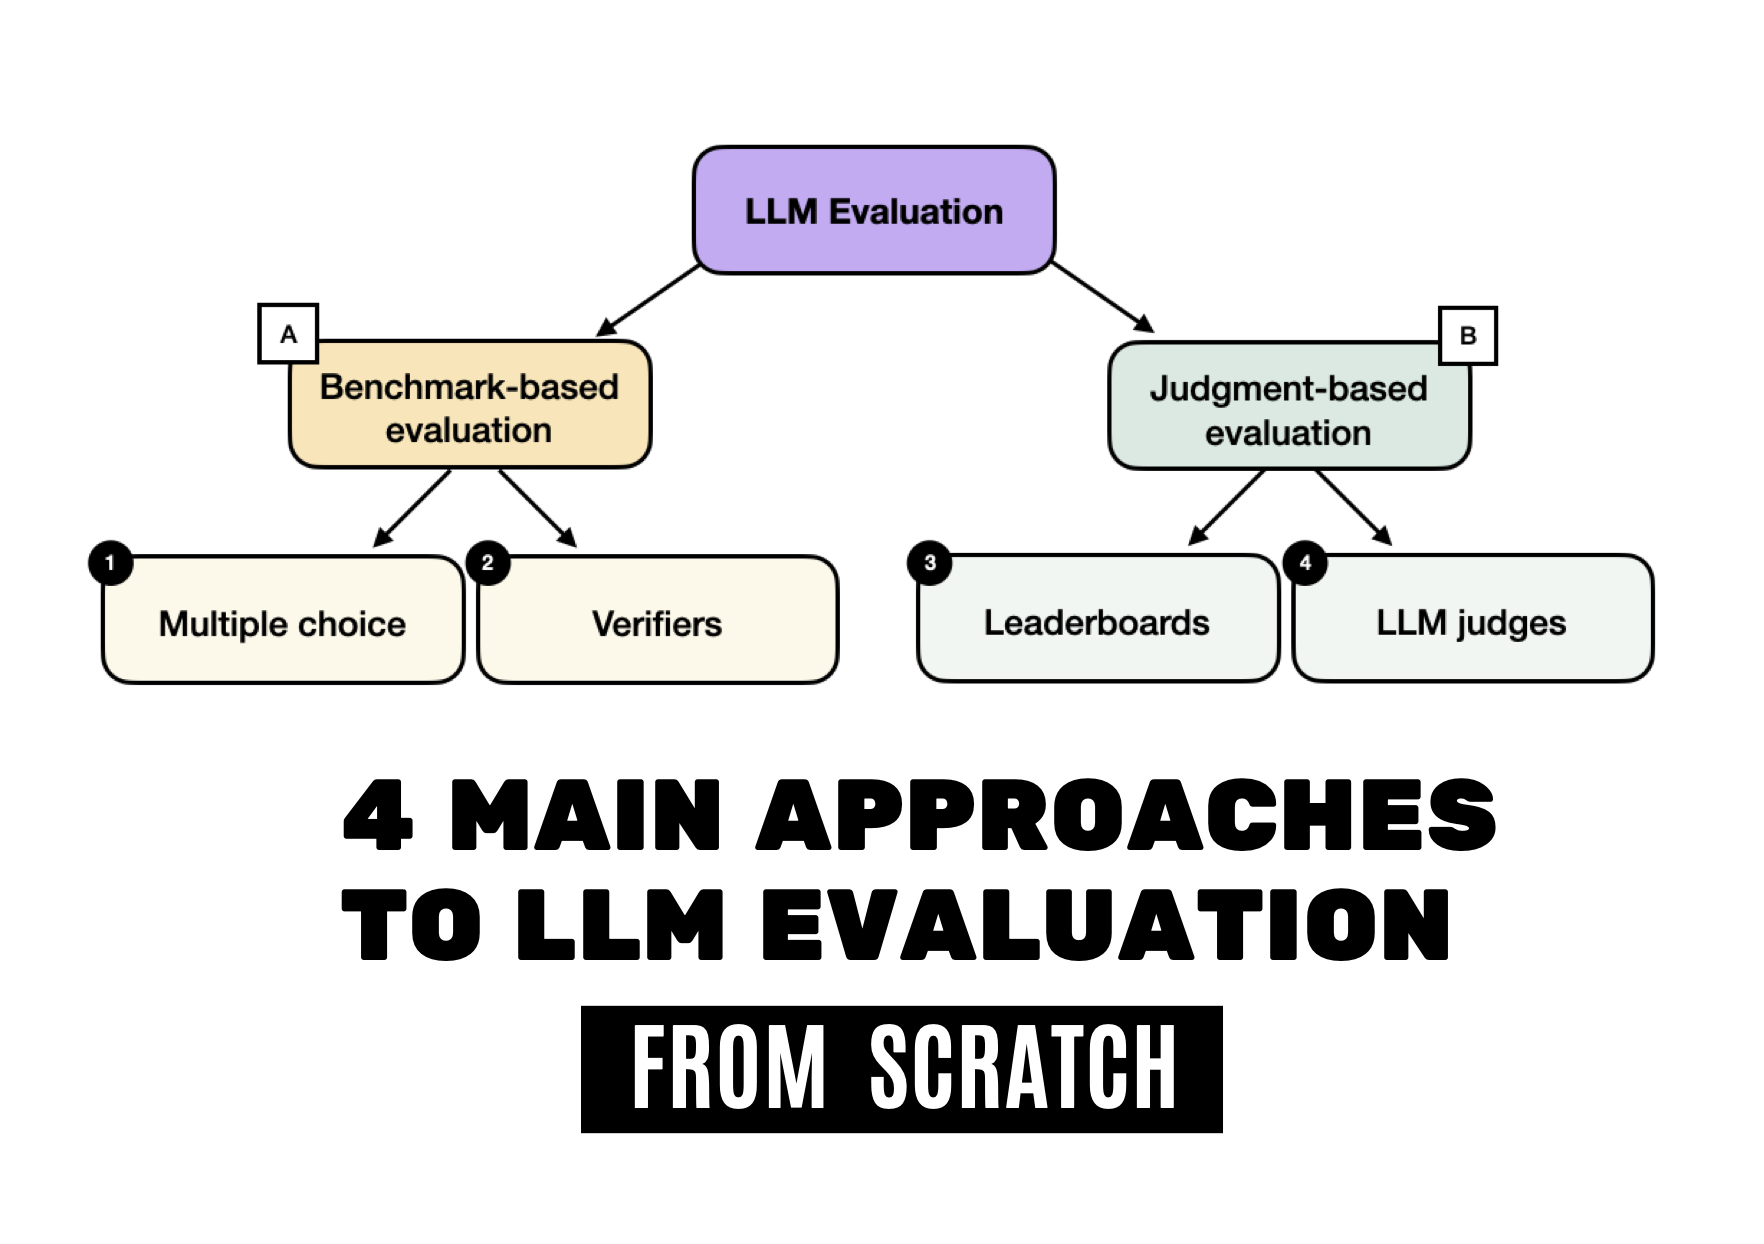
Understanding the 4 Main Approaches to LLM Evaluation (From Scratch)(在新分頁開啟原站)
介紹了評估大語言模型(LLM)的四大主流方法:多選題庫、驗證器、排行榜和 LLM 裁判。透過程式碼實作,讀者能理解這些方法的運作原理與優缺點。
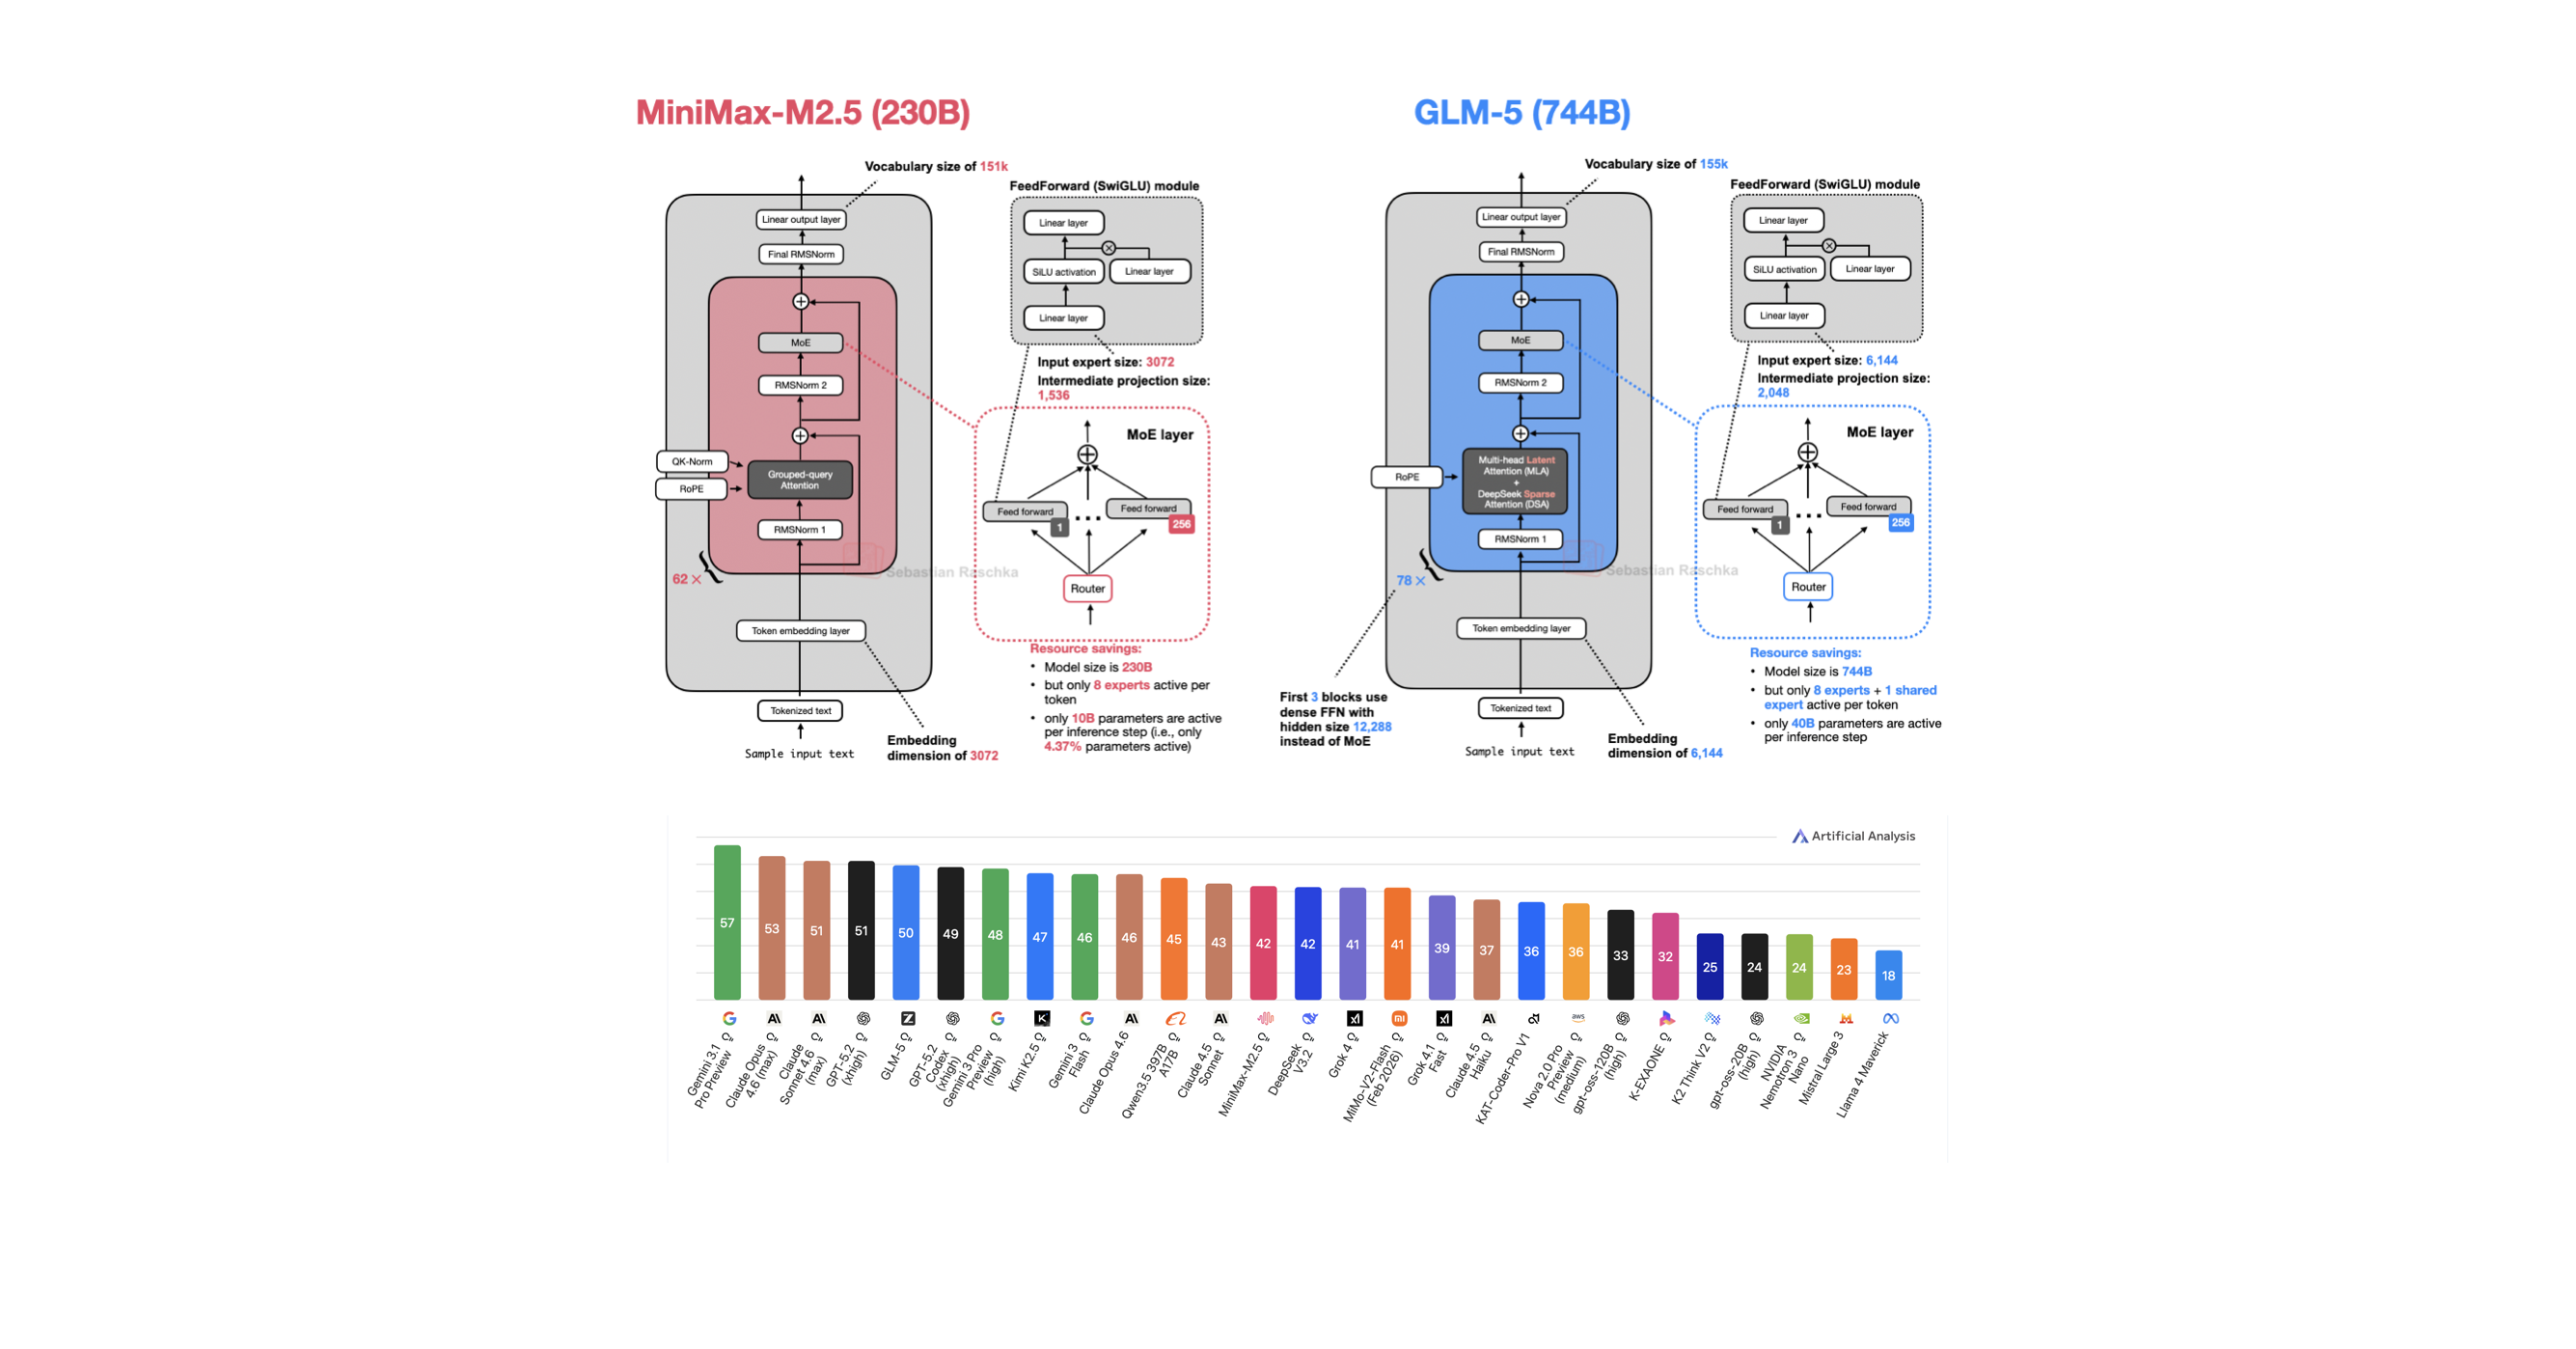
A Dream of Spring for Open-Weight LLMs: 10 Architectures from Jan-Feb 2026(在新分頁開啟原站)
回顧了 2026 年 1 月至 3 月間十款開放權重大語言模型的十款主要發布,涵蓋了從 3B 到 1T 引數的各種架構。文章重點分析了 Arcee Trinity Large、Moonshot Kimi K2.5、StepFun Step…
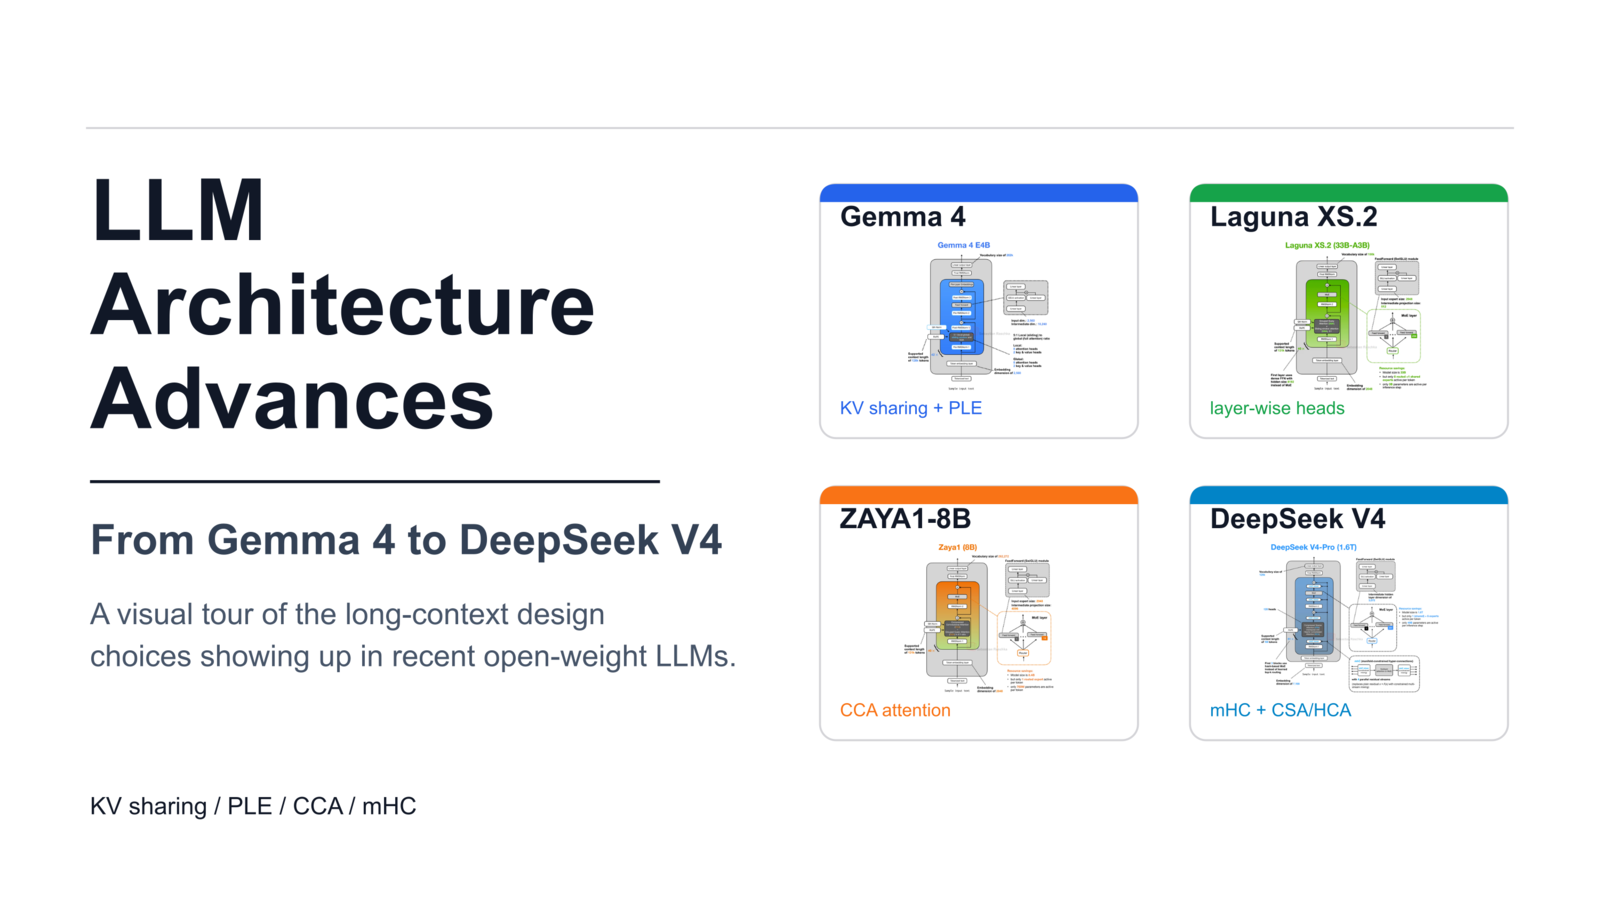
Recent Developments in LLM Architectures: KV Sharing, mHC, and Compressed Attention(在新分頁開啟原站)
介紹了近期開源大語言模型(LLM)在長文處理效率上的幾項重要架構創新。主要涵蓋了 Gemma 4 的跨層 KV 共享與每層嵌入、Laguna XS.2 的層級注意力預算、ZAYA1-8B 的壓縮凸積注意力,以及 DeepSeek V4 的…
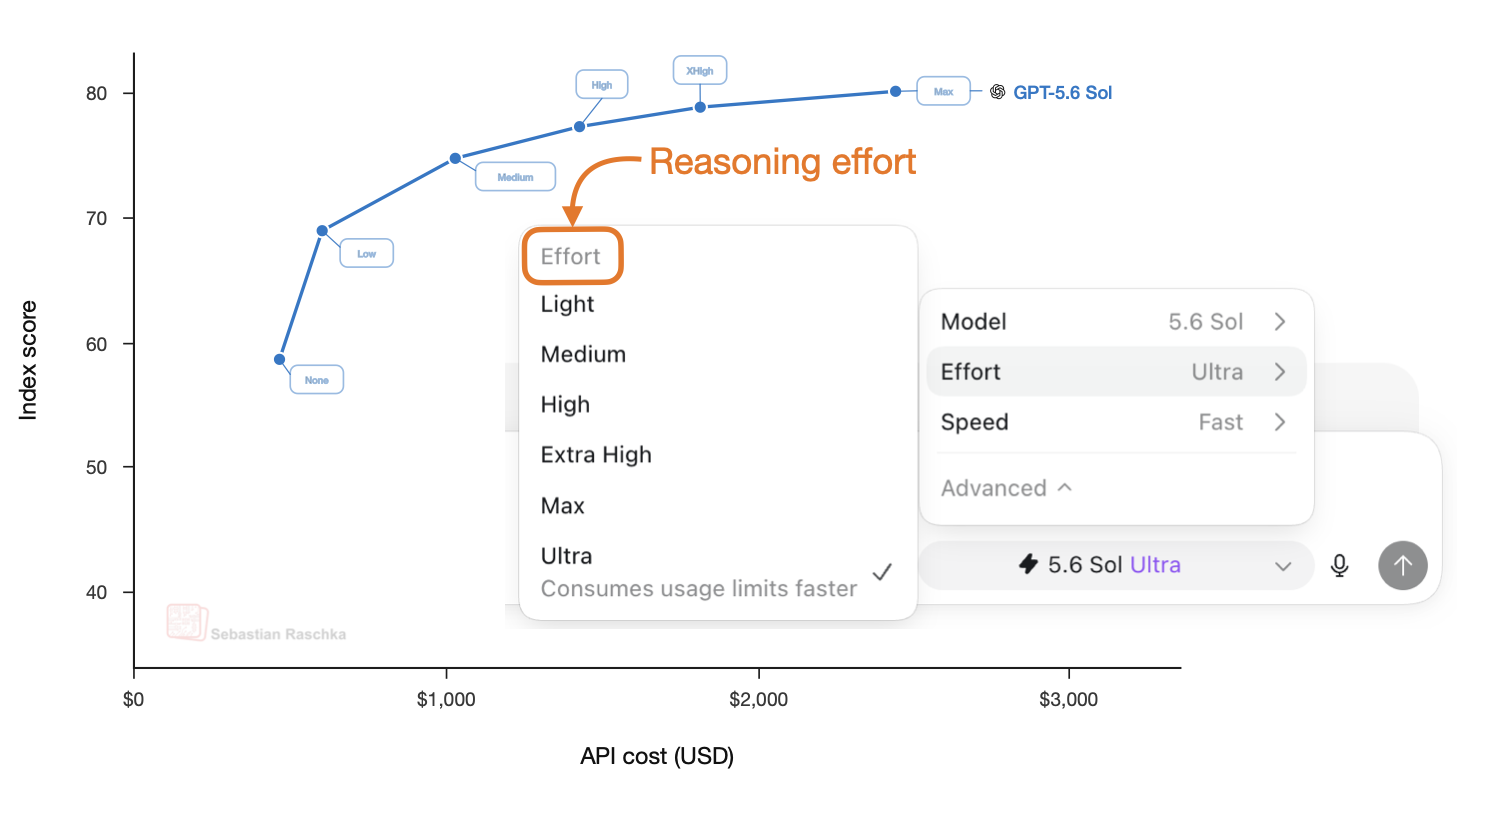
Controlling Reasoning Effort in LLMs(在新分頁開啟原站)
介紹了如何控制大型語言模型(LLM)的推理努力程度,使其具備低、中、高三種模式。透過 RLVR 訓練與推理時排程,模型可根據任務需求切換推理模式。
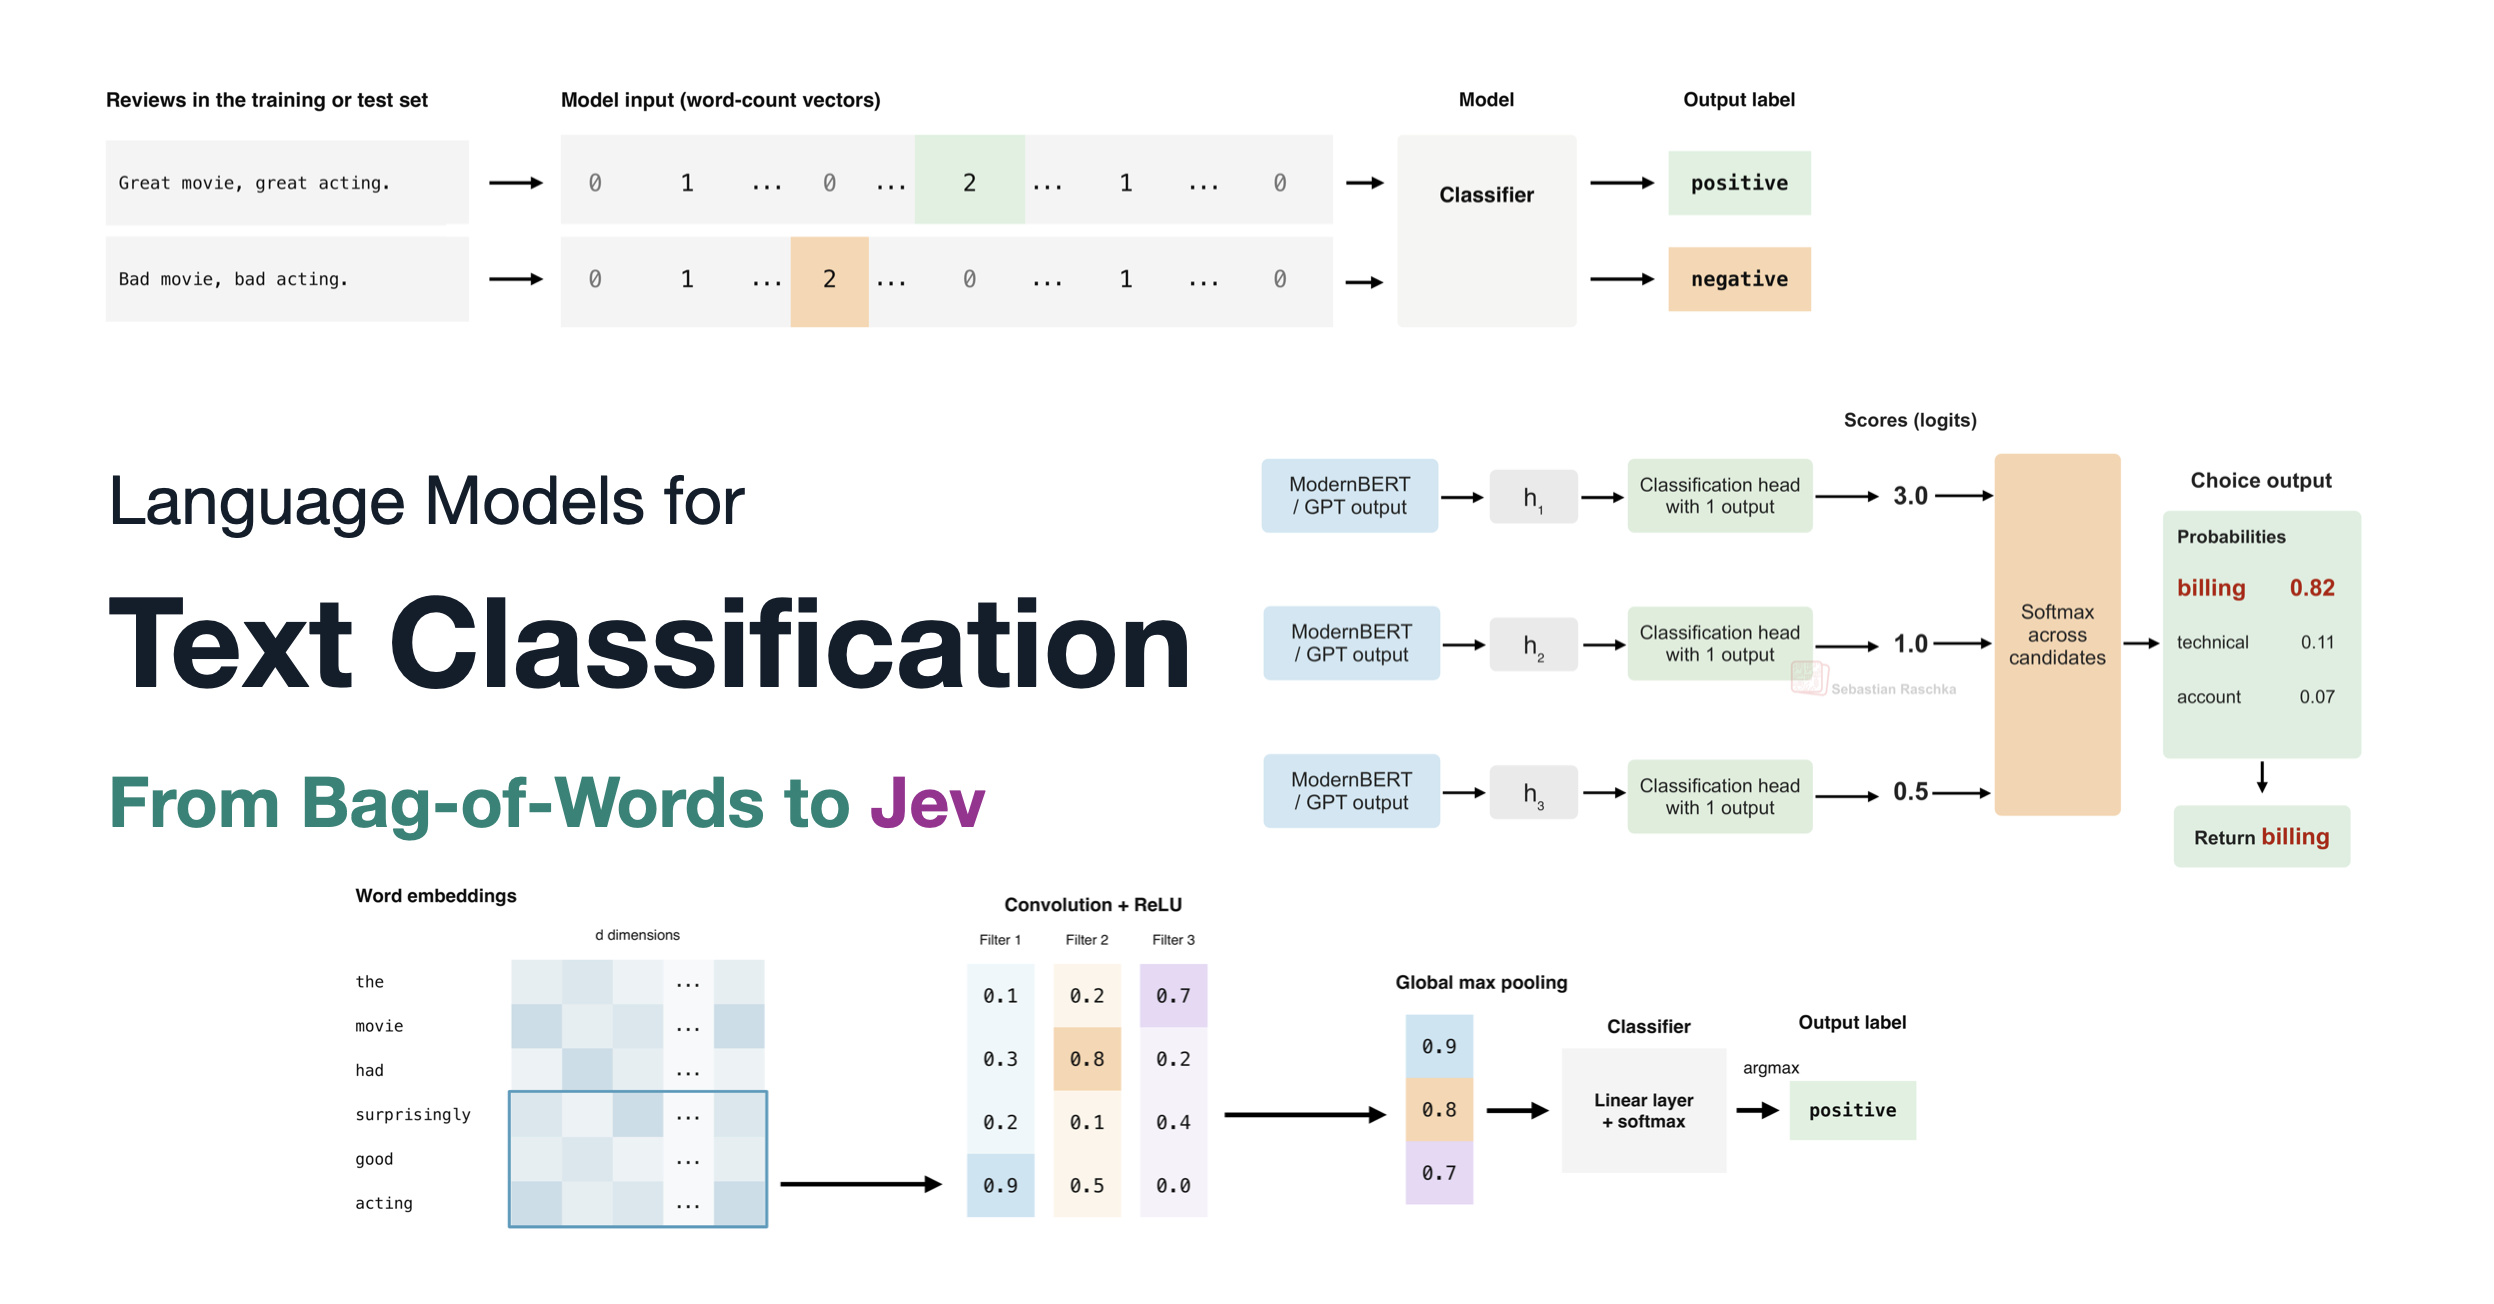
Language Models for Text Classification: From Bag-of-Words to Jev(在新分頁開啟原站)
探討了「Jev」模型,一種專為文字分類設計的輕量級語言模型。作者指出,雖然傳統方法如 Bag-of-Words 和深度學習(RNN/CNN)已存在,但 Jev 在處理特定分類任務時比通用大語言模型(LLM)更快且更便宜。
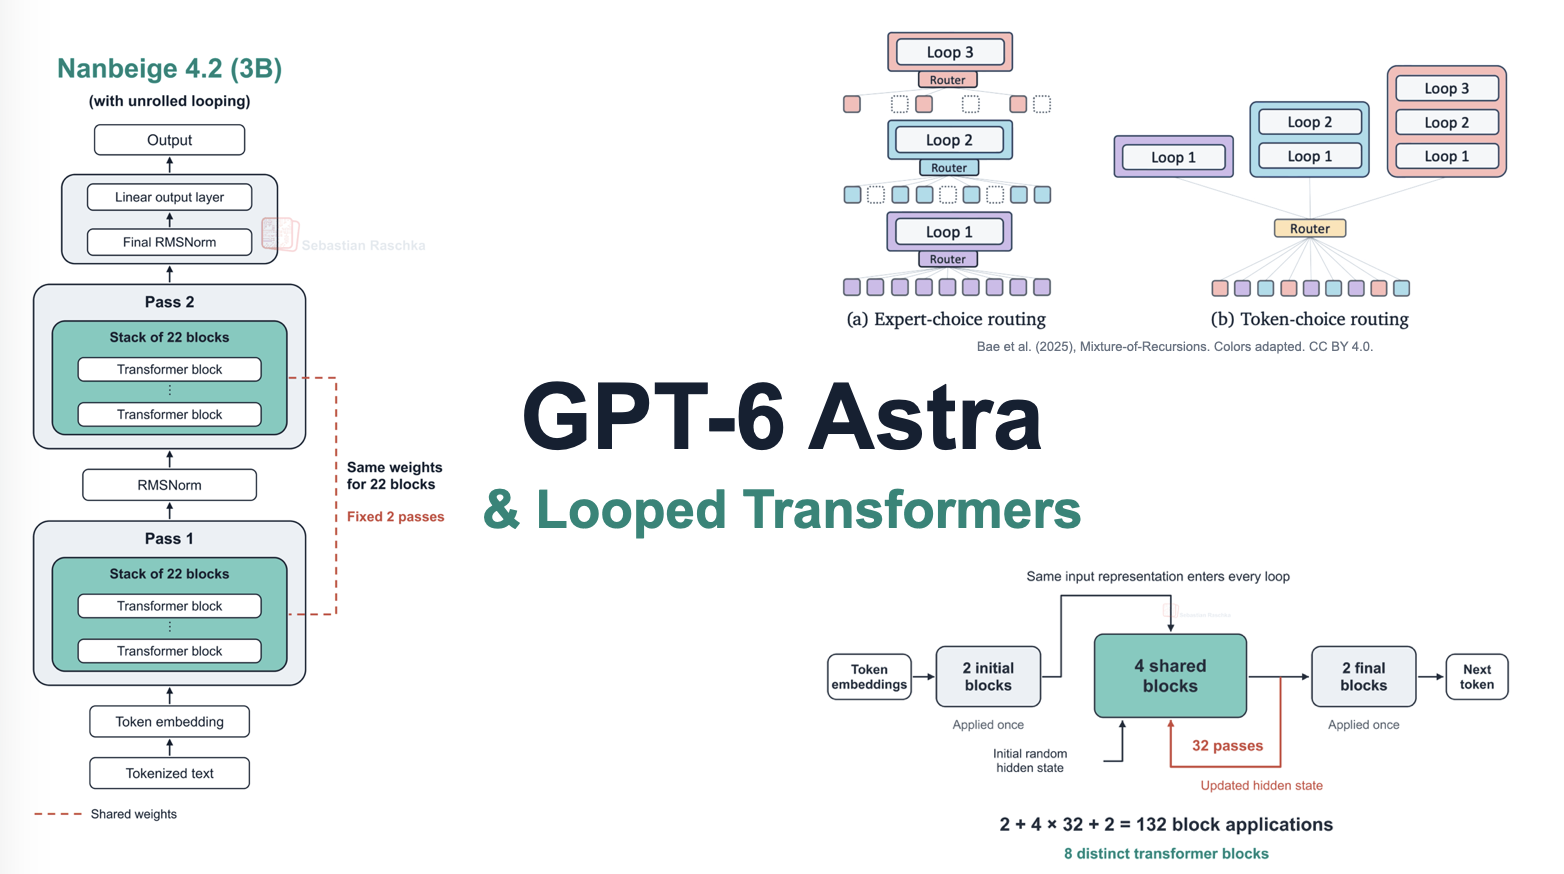
GPT-6 Astra, Looped Transformers, and Hidden Reasoning(在新分頁開啟原站)
探討了 OpenAI 的 GPT-6 Astra 模型,特別是其優異的電腦使用能力與可能使用的「迴圈轉譯器」架構。文章指出,迴圈轉譯器能在固定計算預算下提升模型效能,並引用最新研究探討迴圈機制如何影響推理過程。
How Claude Watermarks AI-Generated Text(在新分頁開啟原站)
本影片詳細解釋了Claude 如何在其文字生成過程中加入隱形水印,並說明如何檢測與移除這些水印。影片透過從零開始的程式碼實作,深入剖析了 LLM 的隨機樣本機制,並展示了如何透過隨機鍵將隨機數變為可重複的確定性樣本,從而實現水印功能。
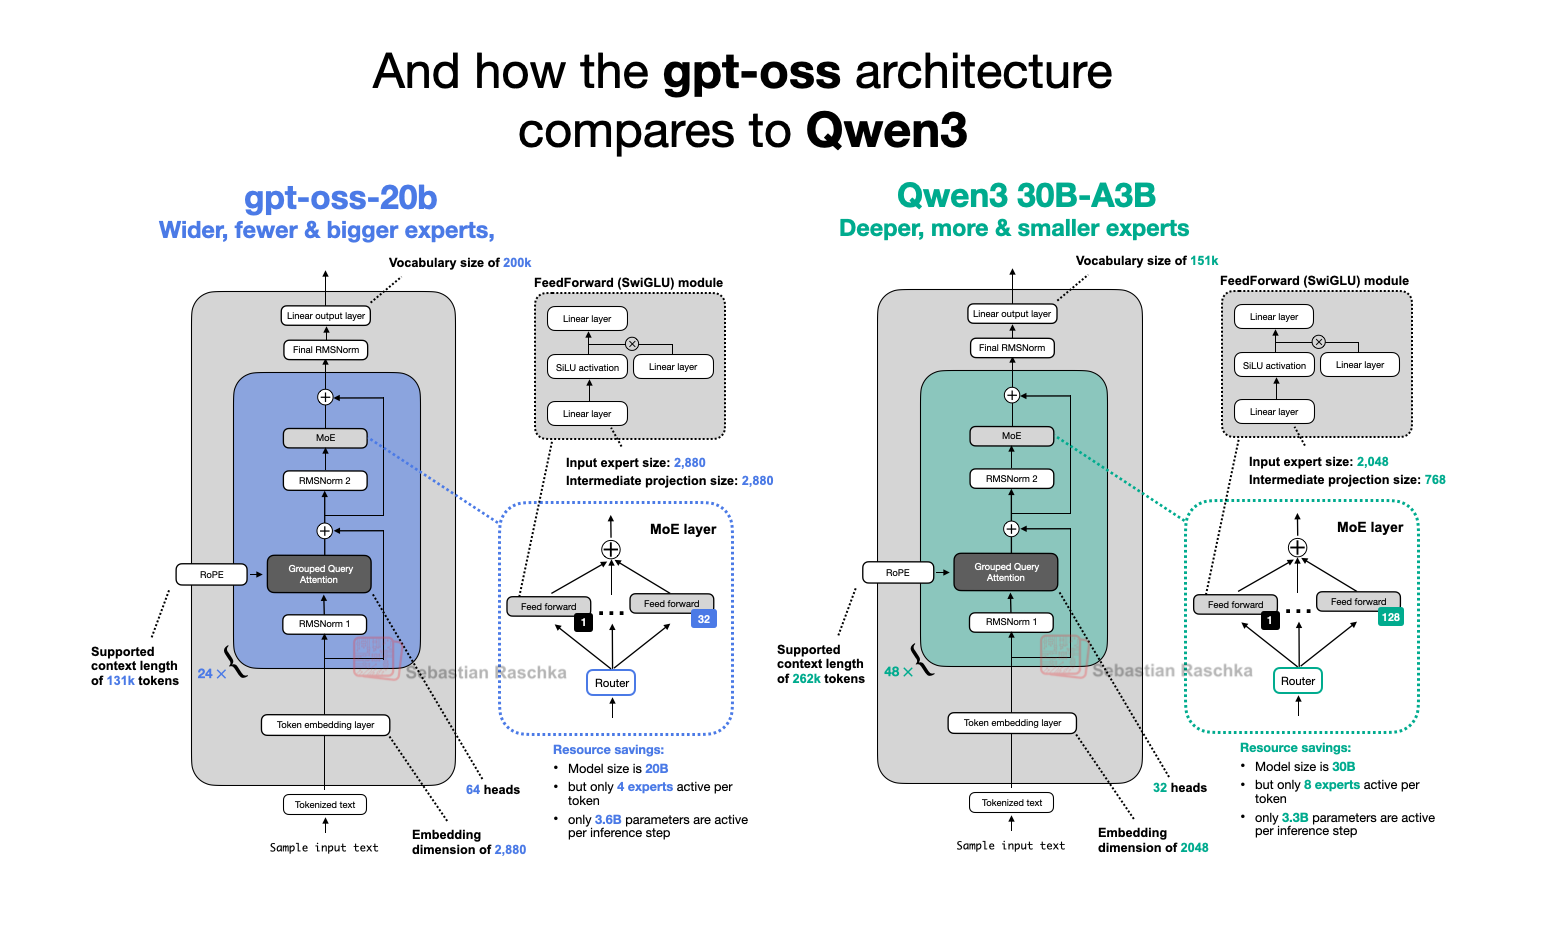
From GPT-2 to gpt-oss: Analyzing the Architectural Advances(在新分頁開啟原站)
深入分析 OpenAI 推出的 gpt-oss 系列模型,與 GPT-2 進行架構對比,並詳述其移除 Dropout、採用 RoPE、使用 SwiGLU 及 RMSNorm 等技術最佳化的細節。
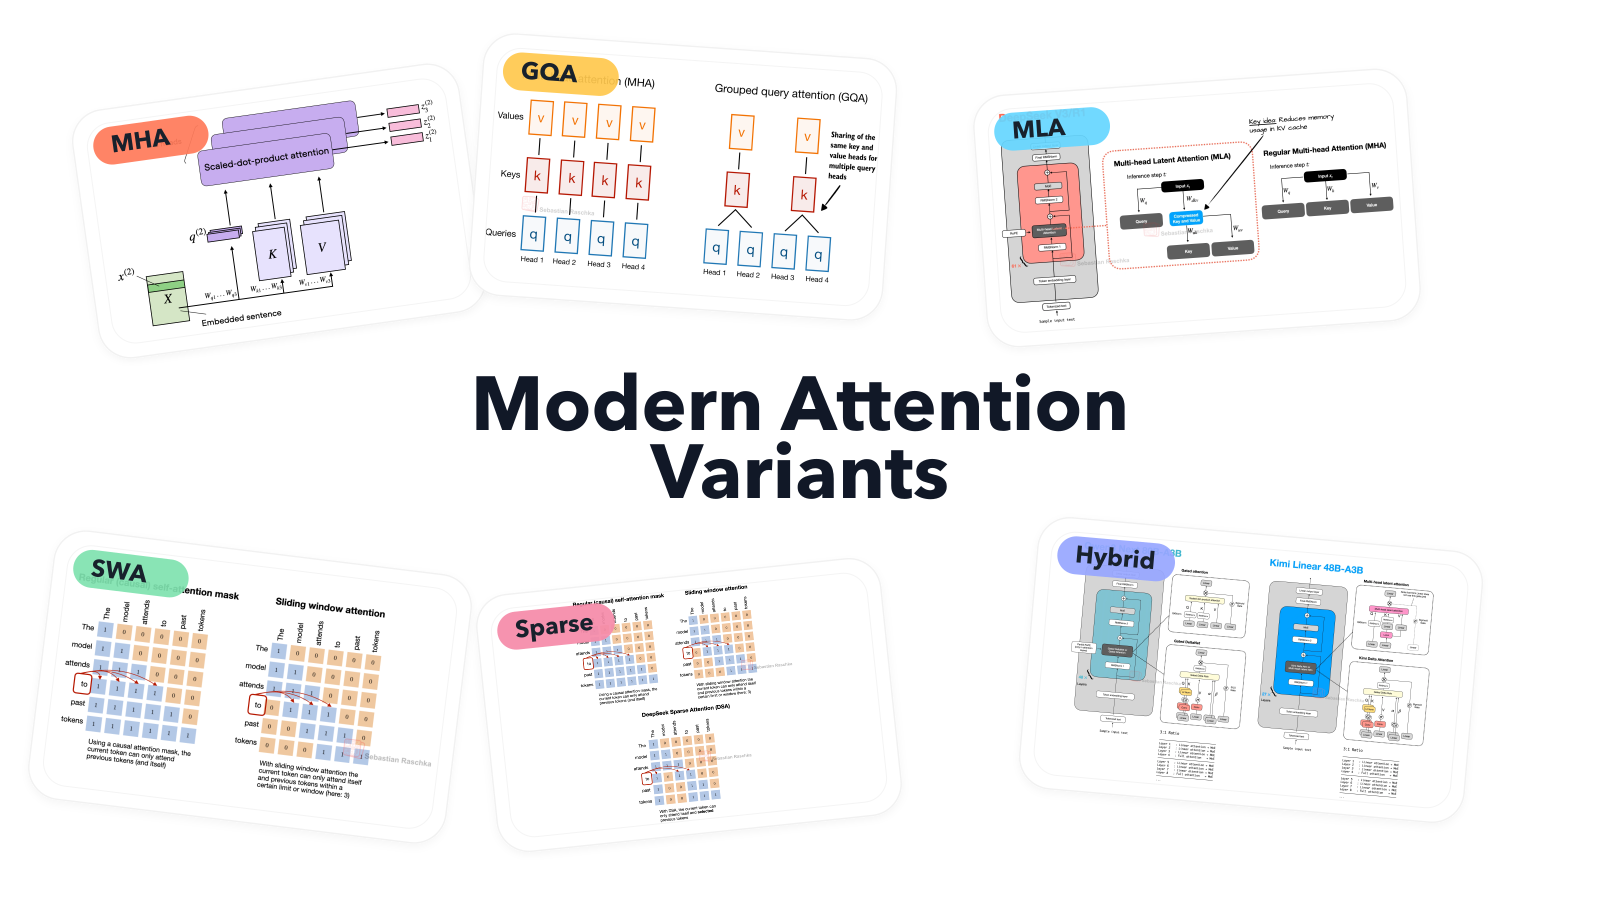
A Visual Guide to Attention Variants in Modern LLMs(在新分頁開啟原站)
整理了現代大型語言模型中多種注意力變體,包括多頭注意力、GQA、MLA、滑動窗注意力等。透過視覺化模型卡片,讀者可以了解不同架構如何平衡計算效率與模型效能,特別適合想深入理解 LLM 內部機制或選擇合適架構的開發者。
最新內容
依發布時間
Language Models for Text Classification: From Bag-of-Words to Jev(在新分頁開啟原站)
探討了「Jev」模型,一種專為文字分類設計的輕量級語言模型。作者指出,雖然傳統方法如 Bag-of-Words 和深度學習(RNN/CNN)已存在,但 Jev 在處理特定分類任務時比通用大語言模型(LLM)更快且更便宜。
GPT-6 Astra, Looped Transformers, and Hidden Reasoning(在新分頁開啟原站)
探討了 OpenAI 的 GPT-6 Astra 模型,特別是其優異的電腦使用能力與可能使用的「迴圈轉譯器」架構。文章指出,迴圈轉譯器能在固定計算預算下提升模型效能,並引用最新研究探討迴圈機制如何影響推理過程。
How Claude Watermarks AI-Generated Text(在新分頁開啟原站)
本影片詳細解釋了Claude 如何在其文字生成過程中加入隱形水印,並說明如何檢測與移除這些水印。影片透過從零開始的程式碼實作,深入剖析了 LLM 的隨機樣本機制,並展示了如何透過隨機鍵將隨機數變為可重複的確定性樣本,從而實現水印功能。
Controlling Reasoning Effort in LLMs(在新分頁開啟原站)
介紹了如何控制大型語言模型(LLM)的推理努力程度,使其具備低、中、高三種模式。透過 RLVR 訓練與推理時排程,模型可根據任務需求切換推理模式。
Recent Developments in LLM Architectures: KV Sharing, mHC, and Compressed Attention(在新分頁開啟原站)
介紹了近期開源大語言模型(LLM)在長文處理效率上的幾項重要架構創新。主要涵蓋了 Gemma 4 的跨層 KV 共享與每層嵌入、Laguna XS.2 的層級注意力預算、ZAYA1-8B 的壓縮凸積注意力,以及 DeepSeek V4 的…
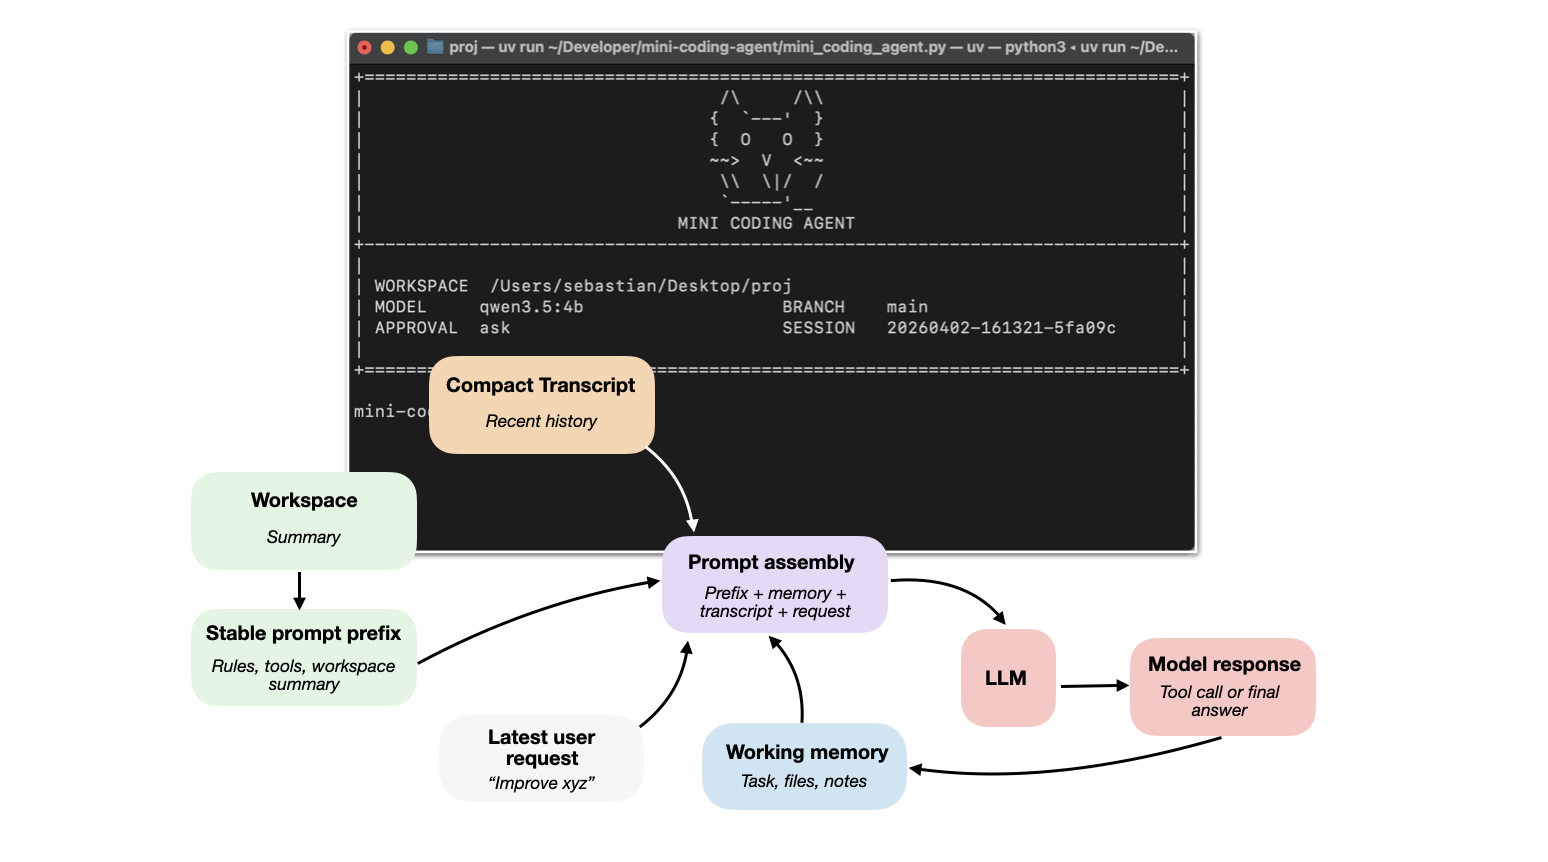
Components of A Coding Agent(在新分頁開啟原站)
這篇文章詳細介紹了編寫程式碼代理(Coding Agents)的六大核心元件,包括實時專案上下文、提示詞與快取最佳化、結構化工具、上下文壓縮、記憶管理以及子代理分發。
A Visual Guide to Attention Variants in Modern LLMs(在新分頁開啟原站)
整理了現代大型語言模型中多種注意力變體,包括多頭注意力、GQA、MLA、滑動窗注意力等。透過視覺化模型卡片,讀者可以了解不同架構如何平衡計算效率與模型效能,特別適合想深入理解 LLM 內部機制或選擇合適架構的開發者。
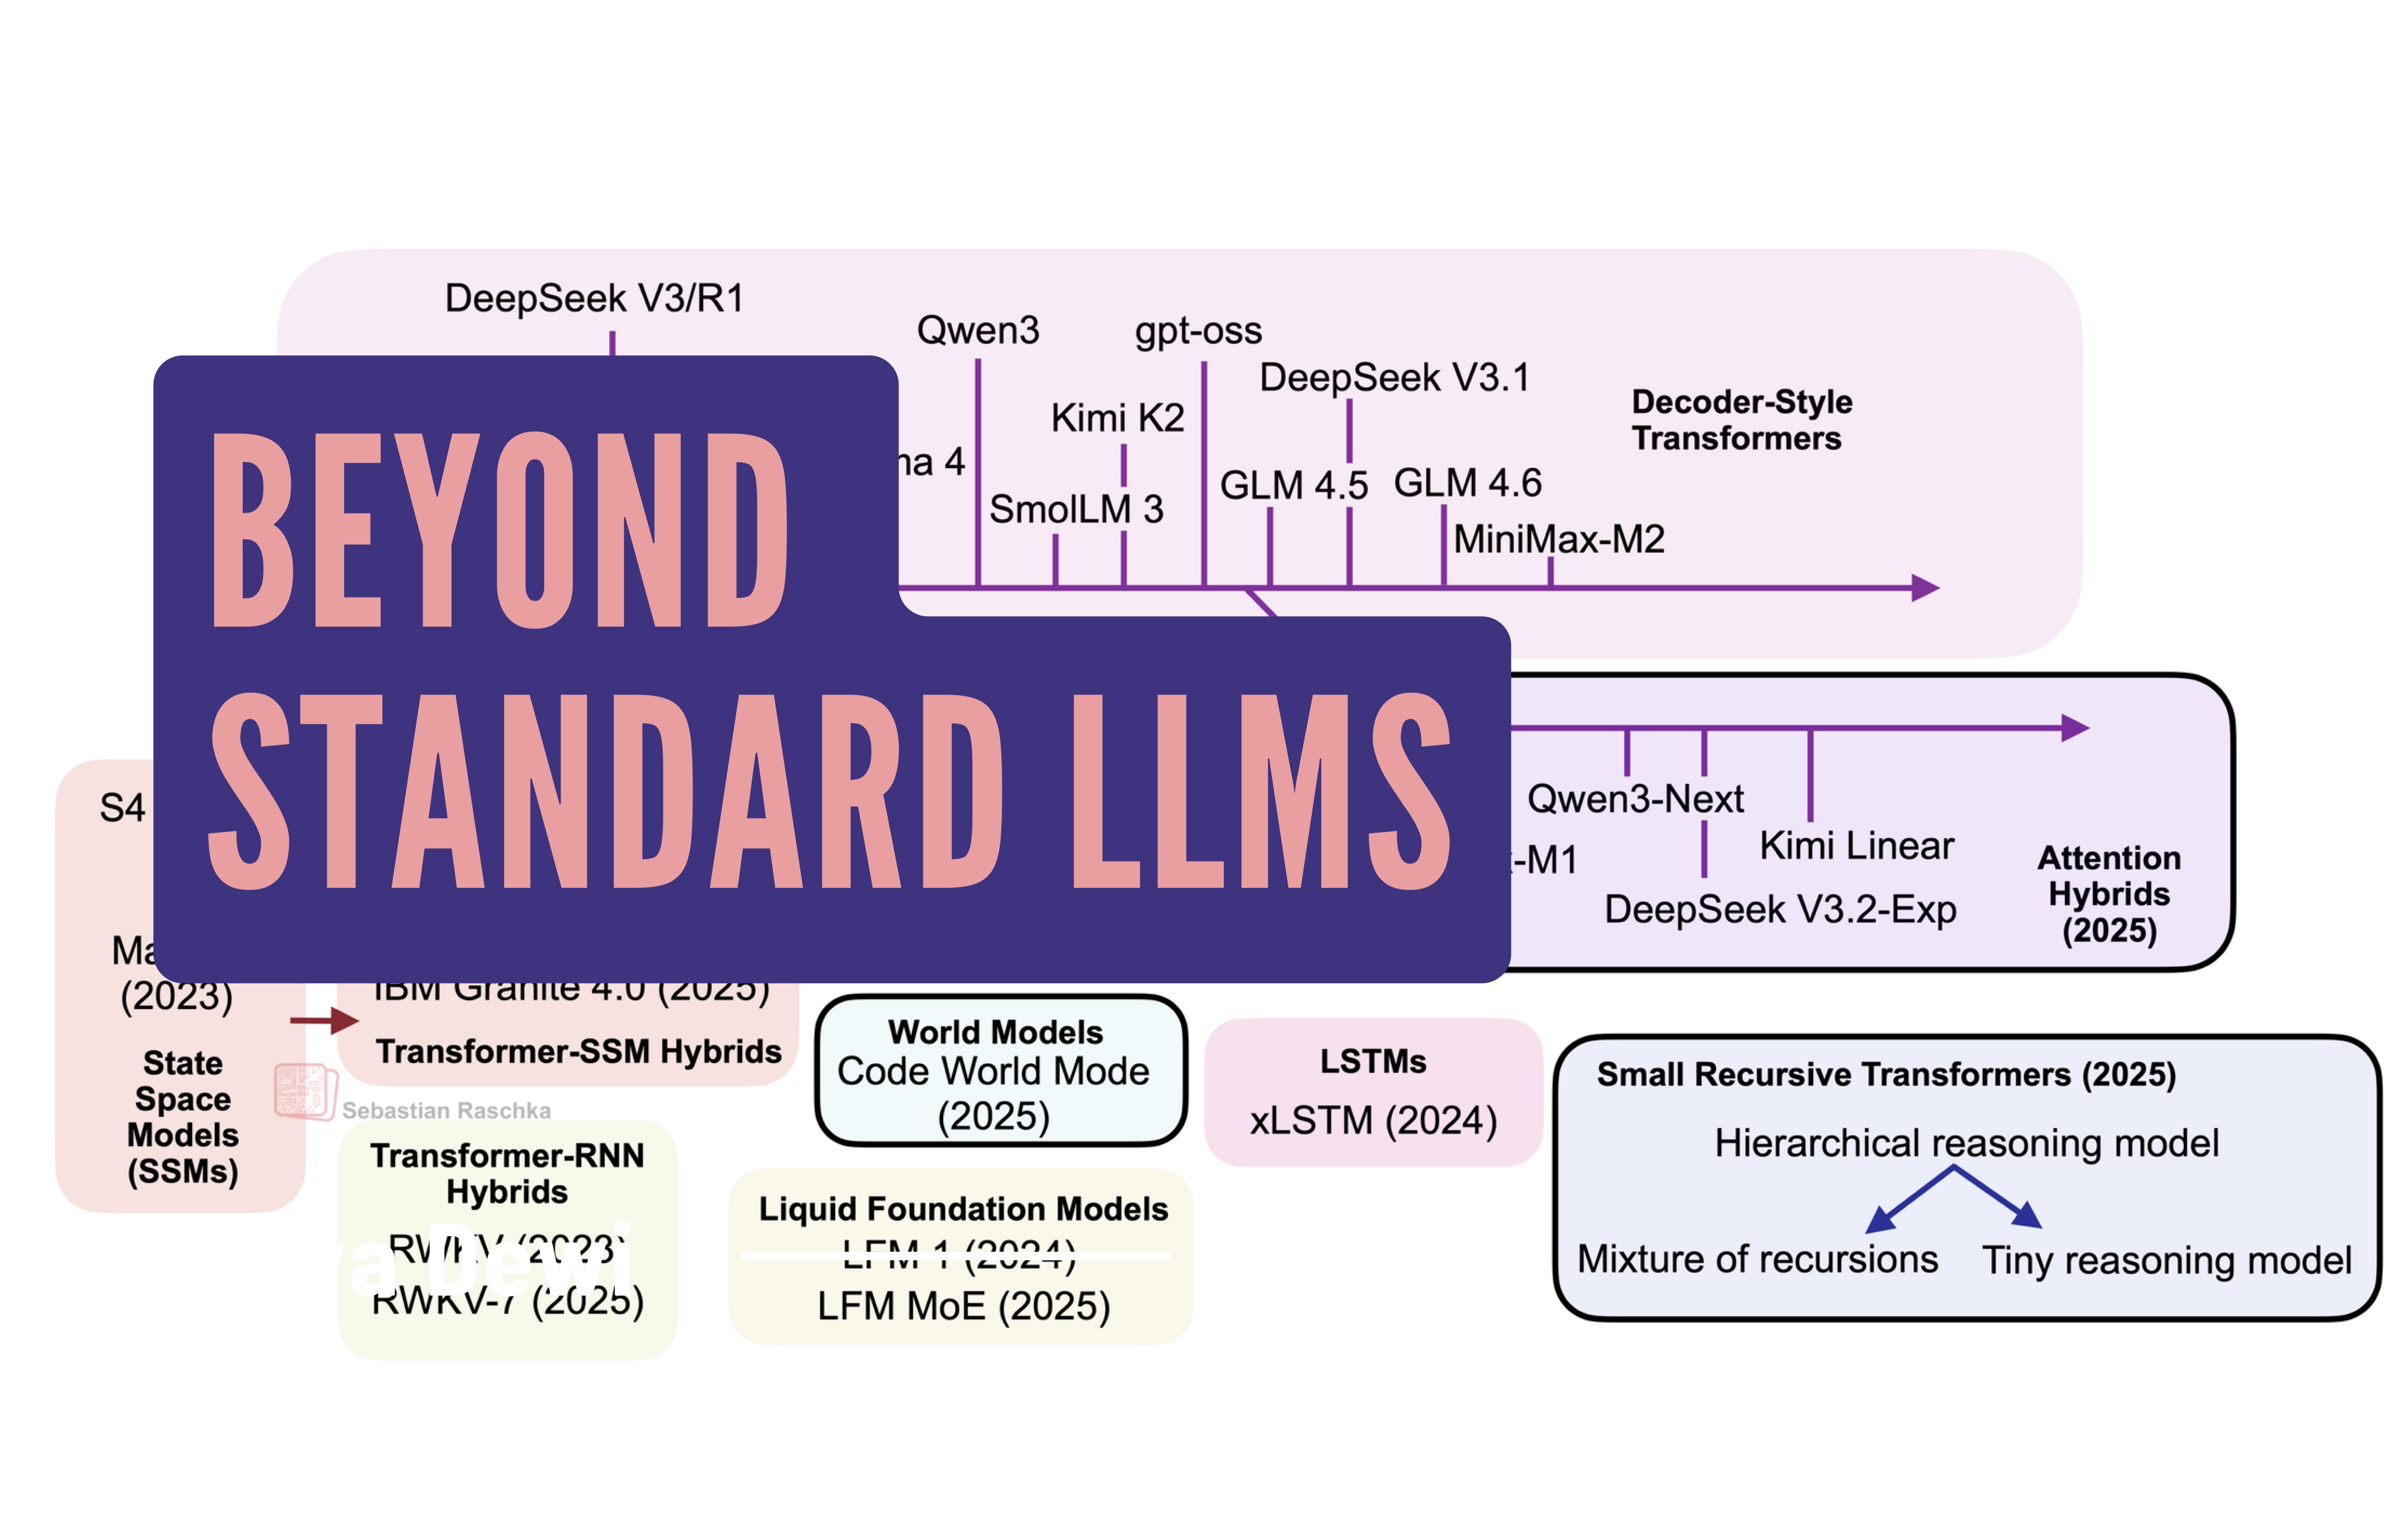
A Dream of Spring for Open-Weight LLMs: 10 Architectures from Jan-Feb 2026(在新分頁開啟原站)
回顧了 2026 年 1 月至 3 月間十款開放權重大語言模型的十款主要發布,涵蓋了從 3B 到 1T 引數的各種架構。文章重點分析了 Arcee Trinity Large、Moonshot Kimi K2.5、StepFun Step…
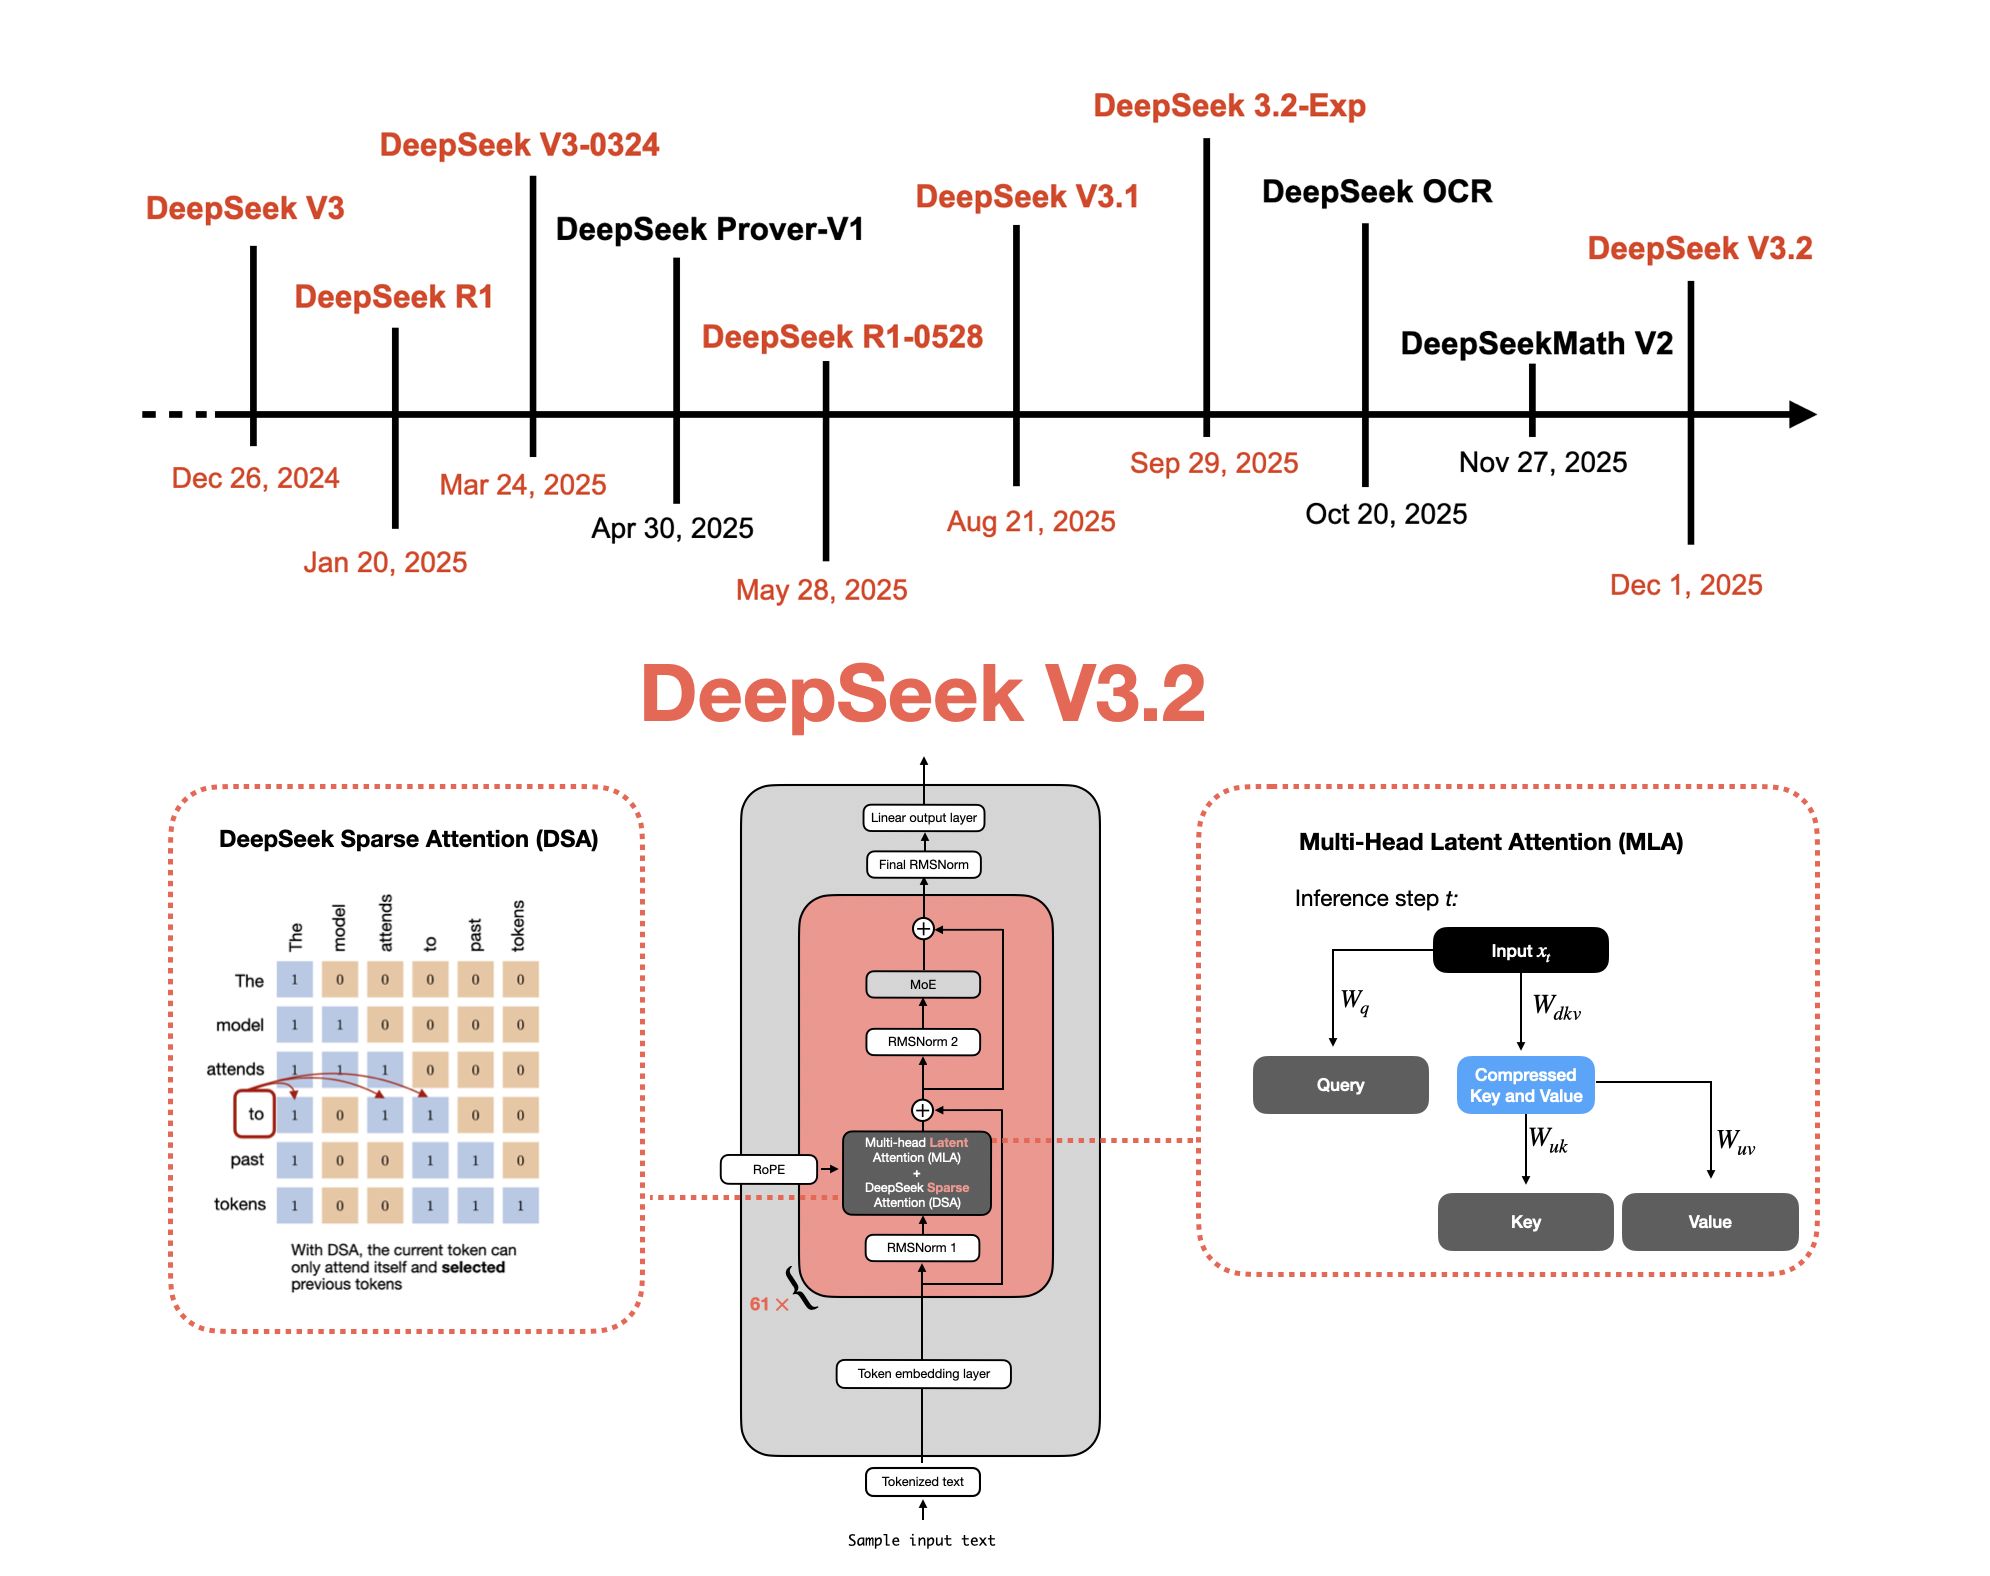
From DeepSeek V3 to V3.2: Architecture, Sparse Attention, and RL Updates(在新分頁開啟原站)
這篇文章詳細介紹了 DeepSeek 的 V3.2 模型,包括其稀疏注意力機制、混合推理架構以及針對數學問題的自驗證訓練方法。作者分析了從 V3 到 V3.2 的演進,並探討了 GRPO 最佳化與自反思技術如何提升模型推理能力。
Understanding the 4 Main Approaches to LLM Evaluation (From Scratch)(在新分頁開啟原站)
介紹了評估大語言模型(LLM)的四大主流方法:多選題庫、驗證器、排行榜和 LLM 裁判。透過程式碼實作,讀者能理解這些方法的運作原理與優缺點。
From GPT-2 to gpt-oss: Analyzing the Architectural Advances(在新分頁開啟原站)
深入分析 OpenAI 推出的 gpt-oss 系列模型,與 GPT-2 進行架構對比,並詳述其移除 Dropout、採用 RoPE、使用 SwiGLU 及 RMSNorm 等技術最佳化的細節。
出現在別人的節目
其他來源裡提到或訪談這位人物的內容
[LIVE] Anthropic Distillation & How Models Cheat (SWE-Bench Dead) | Nathan Lambert & Sebastian Raschka(在新分頁開啟原站)
本節目由 Nathan Lambert 與 Sebastian Raschka 主持,探討 Anthropic 的模型壓縮技術(Distillation)及其如何讓模型「作弊」,特別針對 SWE-Bench 等測試集失效的問題進行分析。
※ 摘要僅根據標題與說明