讀原文(在新分頁開啟原站)連到 Eugene Yan(部落格)
摘要
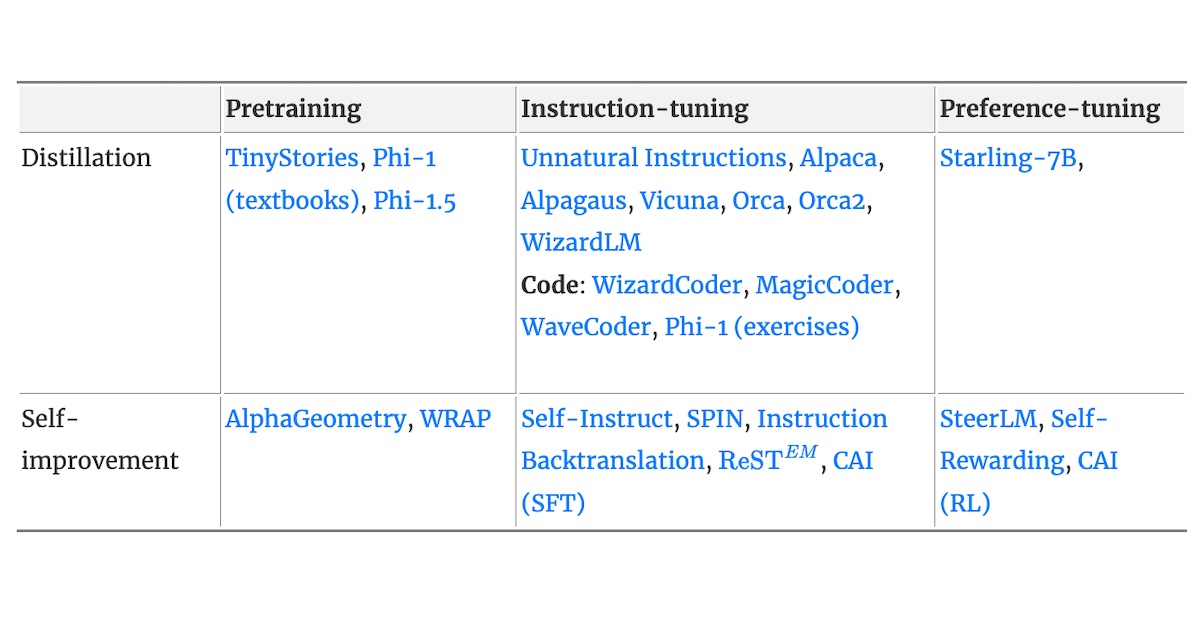
探討如何透過生成式資料來解決人工標籤的瓶頸,適用於指令調教、偏好調教及預訓練。作者介紹了兩種主要方法:透過較強模型蒸餾知識,或讓模型自我改進。文中詳細說明如何生成合成指令與回應,並結合 AlpacaEval 等工具進行評估,強調此方法能提升模型效能並避免隱私問題。
This article explores how synthetic data can overcome the bottleneck of human annotations in instruction tuning, preference tuning, and pretraining. It covers two main approaches: distillation from a stronger model or self-improvement. The text details how to generate synthetic instruction-response…
重點
- 使用合成資料可替代人工標籤,解決資料瓶頸。
- 兩種方法:模型蒸餾或自我改進,各有優缺點。
- 透過生成指令與回應進行指令調教與偏好調教。
提到的工具與公司
- AlpacaEval
- GPT-3.5
- GPT-4
- RLHF
- SFT
- ReST
適合誰看
程式開發者、AI 研究者、資料科學家。
摘要依據
- 講者
- Eugene Yan
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.02
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Learning with not Enough Data Part 3: Data Generation文章 ・ Lilian Weng(部落格)
- E253|谁在给大模型出题、卖题、判卷?聊聊AI数据行业的野蛮生长影片 ・ 硅谷101播客 ・ 58 分鐘
- Learning with not Enough Data Part 1: Semi-Supervised Learning文章 ・ Lilian Weng(部落格)
- The Evolution of Reasoning in Small Language Models with Yejin Choi - #761Podcast ・ The TWIML AI Podcast ・ 1 小時 6 分(在新分頁開啟原站)
- 【生成式AI導論 2024】第3講:訓練不了人工智慧?你可以訓練你自己 (上) — 神奇咒語與提供更多資訊影片 ・ Hung-yi Lee ・ 35 分鐘(在新分頁開啟原站)
- 一个人、两周、数百美元,如何训出登顶 Hugging Face 的模型 | 对谈研究员逯雨鑫Podcast ・ 42章经 ・ 47 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)