How to go from your agent's traces to a fine-tuned model in one workflow(在新分頁開啟原站)
介紹 SmithTune 工具,將 LangSmith 的 Agent 軌跡轉化為訓練資料,並直接用於微調 Qwen 模型。使用者可透過單一命令完成從軌跡準備、訓練到評估的全流程,無需手動整理資料。
8,524次觀看
※ 摘要僅根據標題與說明
Fine-tuning ・ 14 筆內容
用自己的資料調整既有模型,包含 LoRA、QLoRA 等省資源的做法。
也叫做:微調、微调、fine-tuning、fine tuning、finetuning、finetune、fine-tune、LoRA、QLoRA、PEFT
由淺入深:入門 → 進階 → 高階
Fine-tuning a 350M Model for Better Structured Outputs in 100 GRPO Steps
Hugging Face Blog● 有原文
Finetuning Open-Source LLMs(在新分頁開啟原站)
Sebastian Raschka20 分鐘○ 無原文
依相關、人氣、新鮮度綜合排序;站長推薦的加成
介紹 SmithTune 工具,將 LangSmith 的 Agent 軌跡轉化為訓練資料,並直接用於微調 Qwen 模型。使用者可透過單一命令完成從軌跡準備、訓練到評估的全流程,無需手動整理資料。
※ 摘要僅根據標題與說明
介紹如何透過 GRPO 自訂訓練將 350M 引數模型提升為結構化輸出專家。透過設計針對 JSON/YAML 格式與欄位數的獎勵函式,在 100 步內即可讓模型從 22.6% 提升至 29.7% 的結構正確率,證明小模型也能透過精細化訓練…
※ 摘要僅根據標題與說明
本講由李一駿助教整理,聚焦於生成式 AI 與機器學習的終身學習策略。內容涵蓋使用梯度下降微調引數、模型編輯與合併等技術,並首次介紹測試時訓練(TTT)的新方法。
※ 摘要僅根據標題與說明
介紹如何從零開始構建一個自定義的語言模型,並深入探討指令精調(Instruction Finetuning)的具體步驟與方法。
※ 摘要僅根據標題與說明
這篇影片介紹了低秩適應(LoRA)技術,一種用於訓練大型語言模型的輕量化方法,讓使用者能以較低的代價快速學習模型知識。
※ 摘要僅根據標題與說明
依發布時間
介紹 SmithTune 工具,將 LangSmith 的 Agent 軌跡轉化為訓練資料,並直接用於微調 Qwen 模型。使用者可透過單一命令完成從軌跡準備、訓練到評估的全流程,無需手動整理資料。
※ 摘要僅根據標題與說明
介紹了使用 AsyncGRPOTrainer 與 LoRA 技術,在 Hugging Face Jobs 架構下實現跨節點訓練的方法。
介紹如何透過 GRPO 自訂訓練將 350M 引數模型提升為結構化輸出專家。透過設計針對 JSON/YAML 格式與欄位數的獎勵函式,在 100 步內即可讓模型從 22.6% 提升至 29.7% 的結構正確率,證明小模型也能透過精細化訓練…
介紹如何使用 Sentence Transformers 訓練和微調多向量嵌入模型,以實現類似 ColBERT 的晚互動檢索。
本講由李一駿助教整理,聚焦於生成式 AI 與機器學習的終身學習策略。內容涵蓋使用梯度下降微調引數、模型編輯與合併等技術,並首次介紹測試時訓練(TTT)的新方法。
※ 摘要僅根據標題與說明
介紹如何從零開始構建一個自定義的語言模型,並深入探討指令精調(Instruction Finetuning)的具體步驟與方法。
※ 摘要僅根據標題與說明
這篇影片介紹了低秩適應(LoRA)技術,一種用於訓練大型語言模型的輕量化方法,讓使用者能以較低的代價快速學習模型知識。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
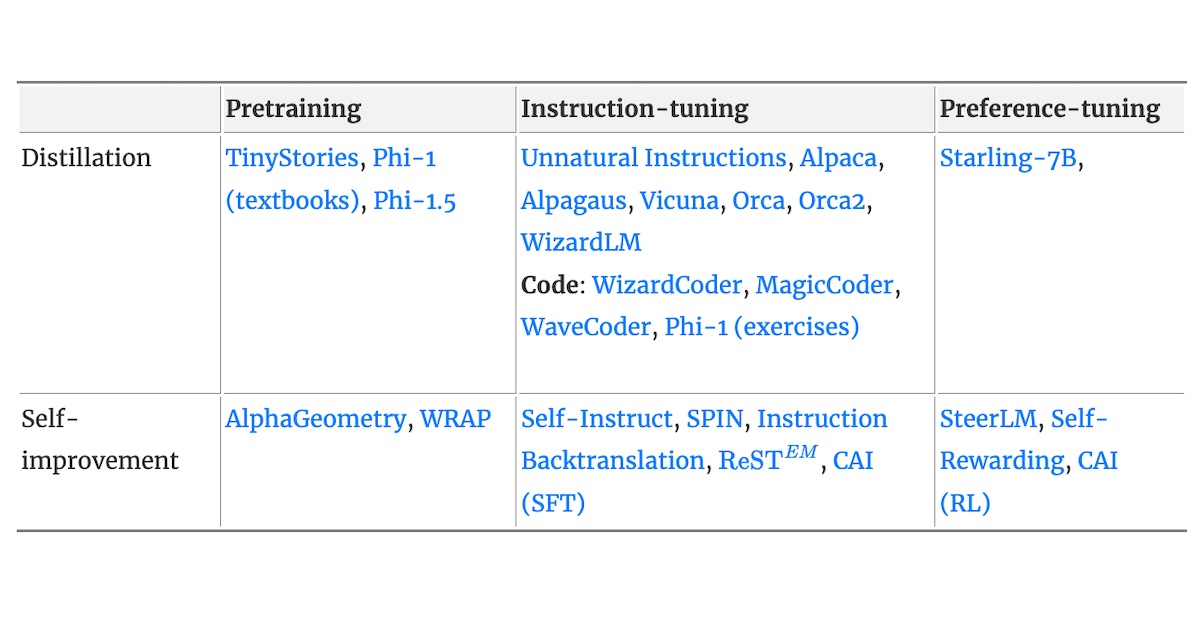
探討如何透過生成式資料來解決人工標籤的瓶頸,適用於指令調教、偏好調教及預訓練。作者介紹了兩種主要方法:透過較強模型蒸餾知識,或讓模型自我改進。
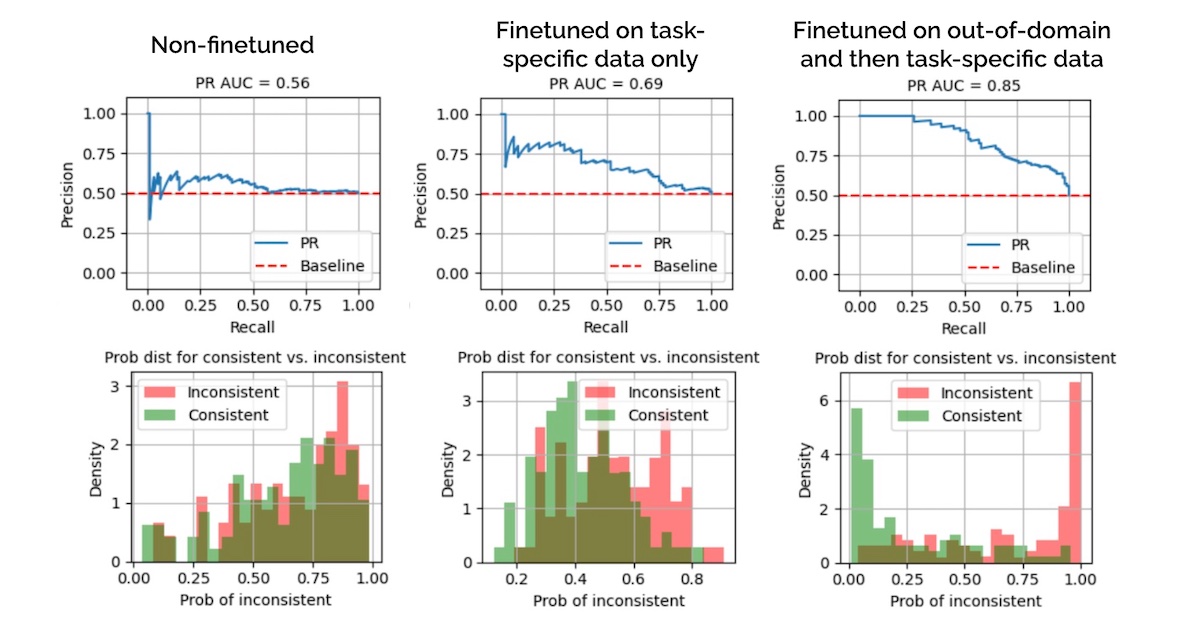
探討如何利用外域資料(如維基百科摘要)進行預訓練,來提升對新聞摘要中事實不一致(即謠言)的檢測能力。作者發現,即使預訓練階段在相關領域(維基百科)上只進行了少量訓練,也能顯著改善後續在特定任務(FIB)上的表現,從而減少需要收集大量標註資…
本影片詳細解構 BERT 模型,涵蓋訓練、推理、精調等核心概念,並深入探討其與 GPT/LLaMA 的差異。透過視覺化步驟,讓讀者掌握自注意力機制、[CLS] 標記及多工應用(如分類與問答)的實作原理。
※ 摘要僅根據標題與說明
本影片用視覺化方式解釋 LoRA 技術,並提供從零開始的 PyTorch 程式碼實作,讓讀者理解低秩適應如何高效調整大型語言模型。
※ 摘要僅根據標題與說明