讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
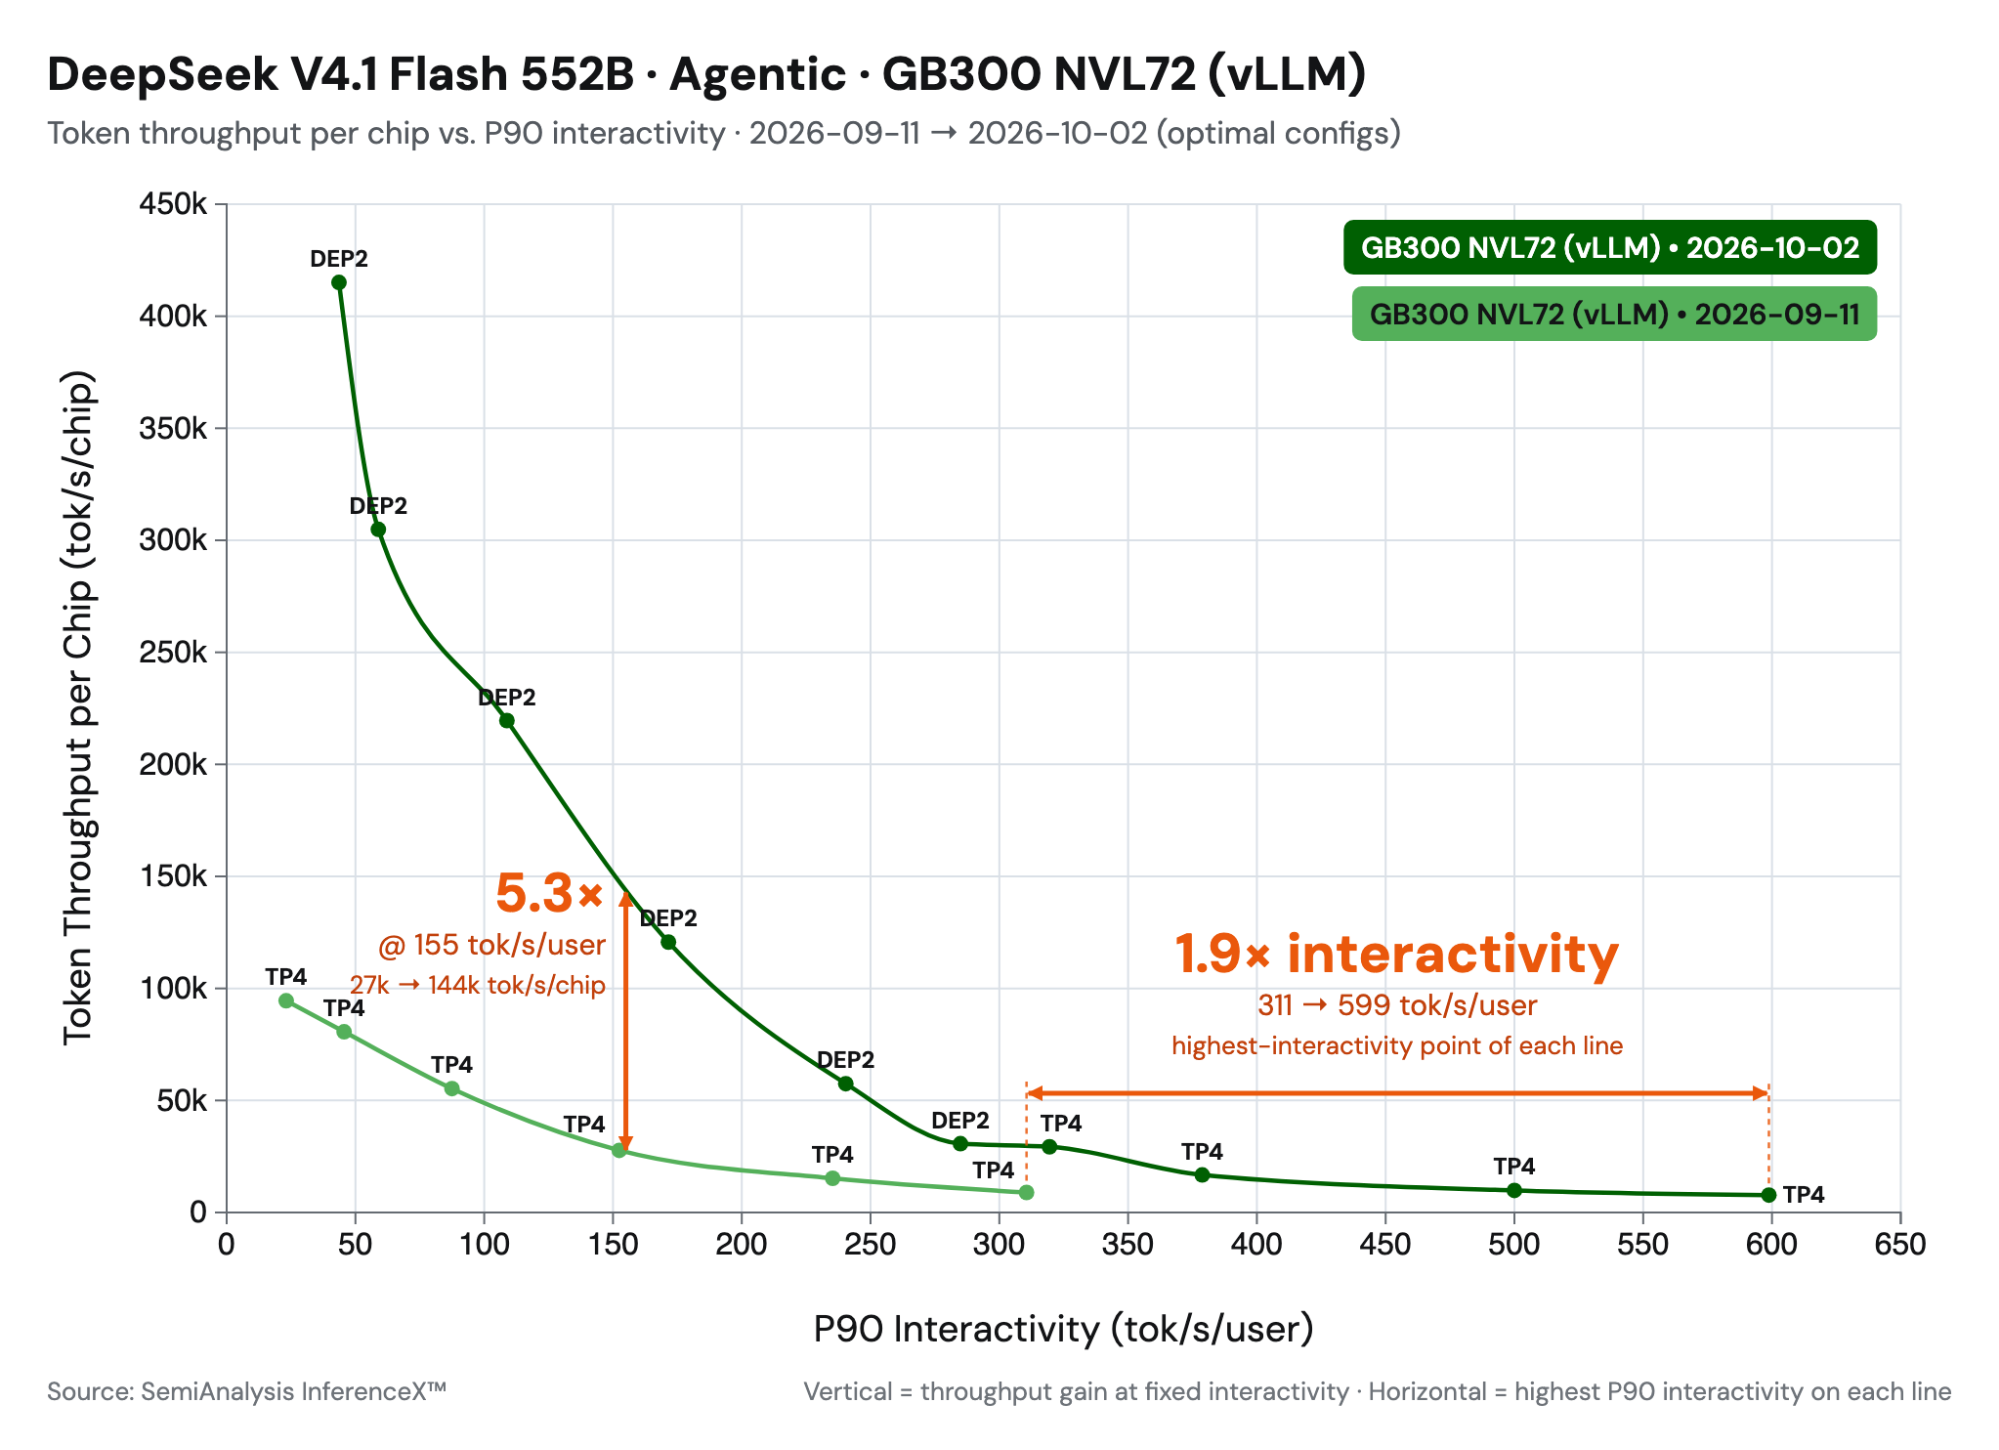
介紹 vLLM 團隊如何結合 DeepSeek-V4.1-Flash 的新架構與系統最佳化,將代理服務吞吐量提升 5 倍。內容涵蓋 SWA 有界重播、CUDA 圖表技術及多項新核函式整合,並驗證了模型精度與效能的顯著改善。
This post details how vLLM combined DeepSeek-V4.1-Flash architecture and system optimizations to achieve a 5x throughput improvement in agentic serving workloads.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 整合 DeepSeek-V4.1-Flash 新架構與 vLLM 系統最佳化。
- 透過 SWA 有界重播與 CUDA 圖表大幅降低預填充時間。
- 利用多項新核函式與記憶體壓縮技術提升吞吐量。
提到的工具與公司
- vLLM
- DeepSeek-V4.1-Flash
- SWA bounded replay
- CUDA graphs
- DeepSelect
- DeepGEMM
- FlashMLA
- Engram
適合誰看
專注於大規模模型部署、效能最佳化或代理系統開發的工程師與研究者。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.99
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- vLLM x AgentX: Optimizing for Real-World Agentic Serving文章 ・ vLLM Blog
- DeepSeek’s Insane New Architecture影片 ・ Two Minute Papers ・ 5 分鐘
- DeepSeek V4.1 Flash 有多快?架构简析 + Pi Agent 演示影片 ・ 01Coder
- Why DeepSeek's New Architecture Is a Huge Breakthrough影片 ・ Prompt Engineering ・ 14 分鐘
- DeepSeek V4.1 Flash Is WAY Better Than I Expected影片 ・ Prompt Engineering ・ 12 分鐘
- DeepSeek V4.1 Flash on Strix Halo: Single-Node SSD vs Two-Node Cluster (DwarfStar)影片 ・ Donato Capitella
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)