1文章高階EN
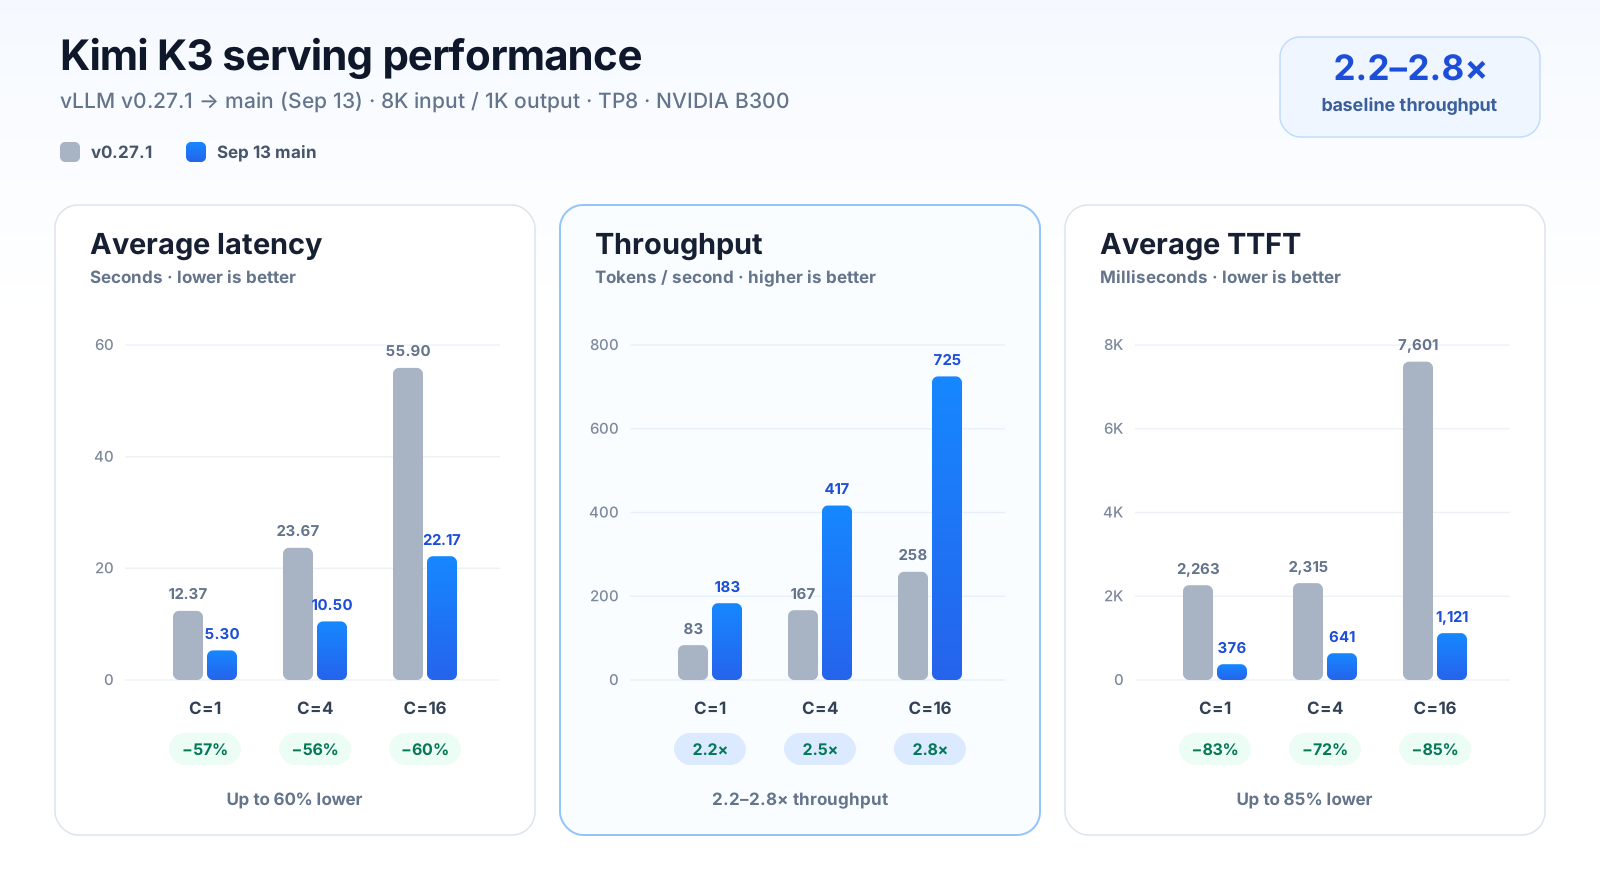
Kimi K3 Performance Optimizations in vLLM: The Road to 2.8× Throughput
介紹 Kimi K3 在 vLLM 中的效能最佳化,透過排程、KDA 字首快取、零複製批次與延遲化計算等技術,將吞吐量提升 2.8 倍。讀者可了解如何解決 Mamba 架構的瓶頸並提升推理效率。
部落格 ・ 國際 ・ 英文 ・ A 級 ・ 30 筆內容 ・ 最近更新 2026/10/07
開源推論引擎的工程部落格:新模型的部署調校、分離式服務架構、吞吐量最佳化
依人氣
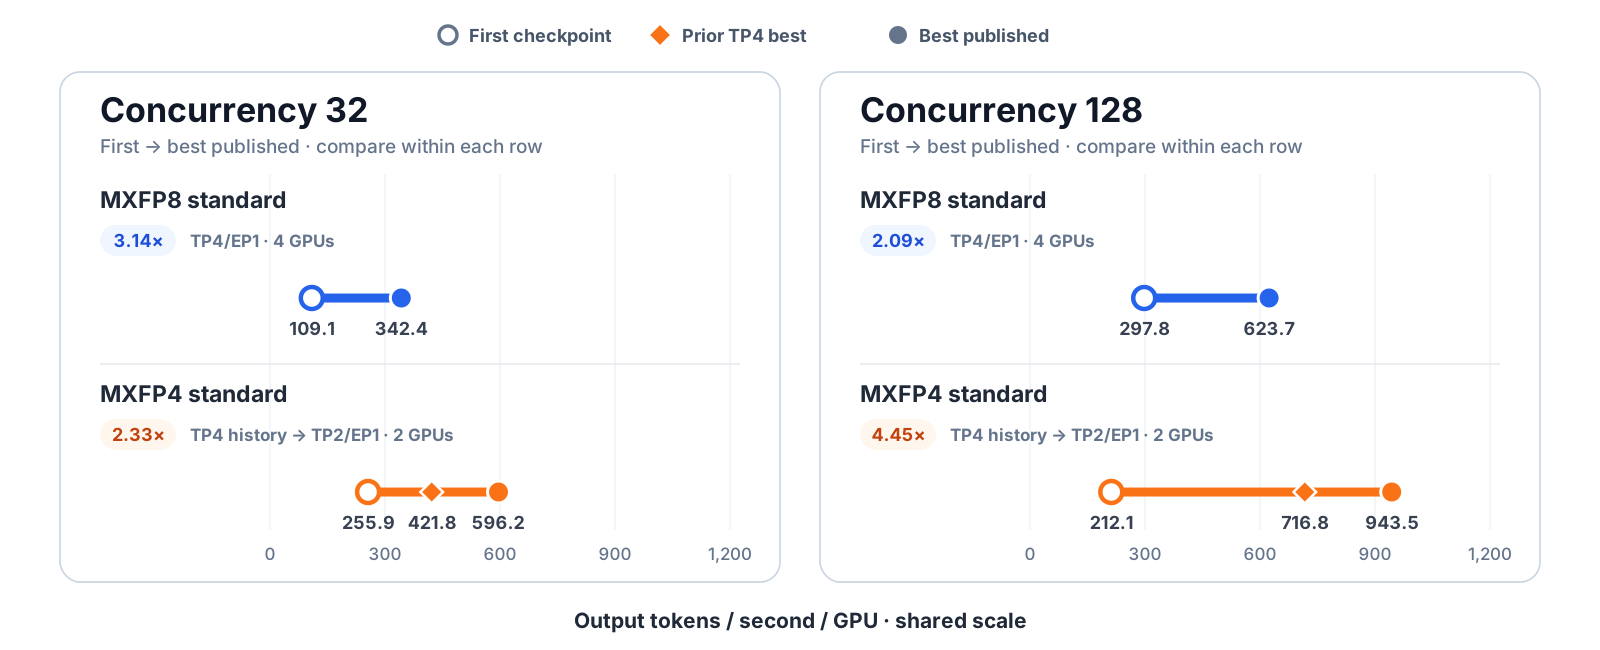
介紹 Kimi K3 在 vLLM 中的效能最佳化,透過排程、KDA 字首快取、零複製批次與延遲化計算等技術,將吞吐量提升 2.8 倍。讀者可了解如何解決 Mamba 架構的瓶頸並提升推理效率。
介紹如何透過 PyNvVideoCodec 利用 NVIDIA GPU 硬體解碼功能,解決 vLLM 處理影片描述任務時 CPU 成為瓶頸的問題。
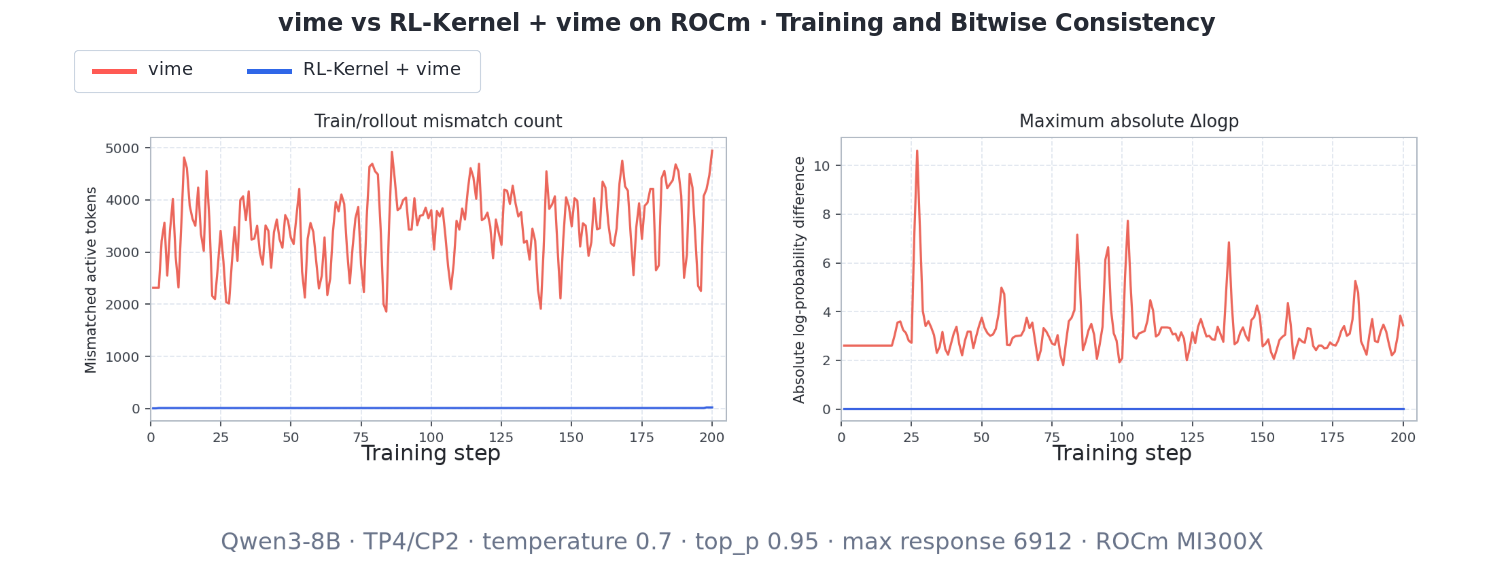
介紹如何在 AMD Instinct MI300X 上實現 Megatron 訓練與 vLLM 推論的位元級一致性。透過 vime 與 RL-Kernel 解決因浮點運算差異導致的對齊問題,驗證了 200 個步驟內無誤差。
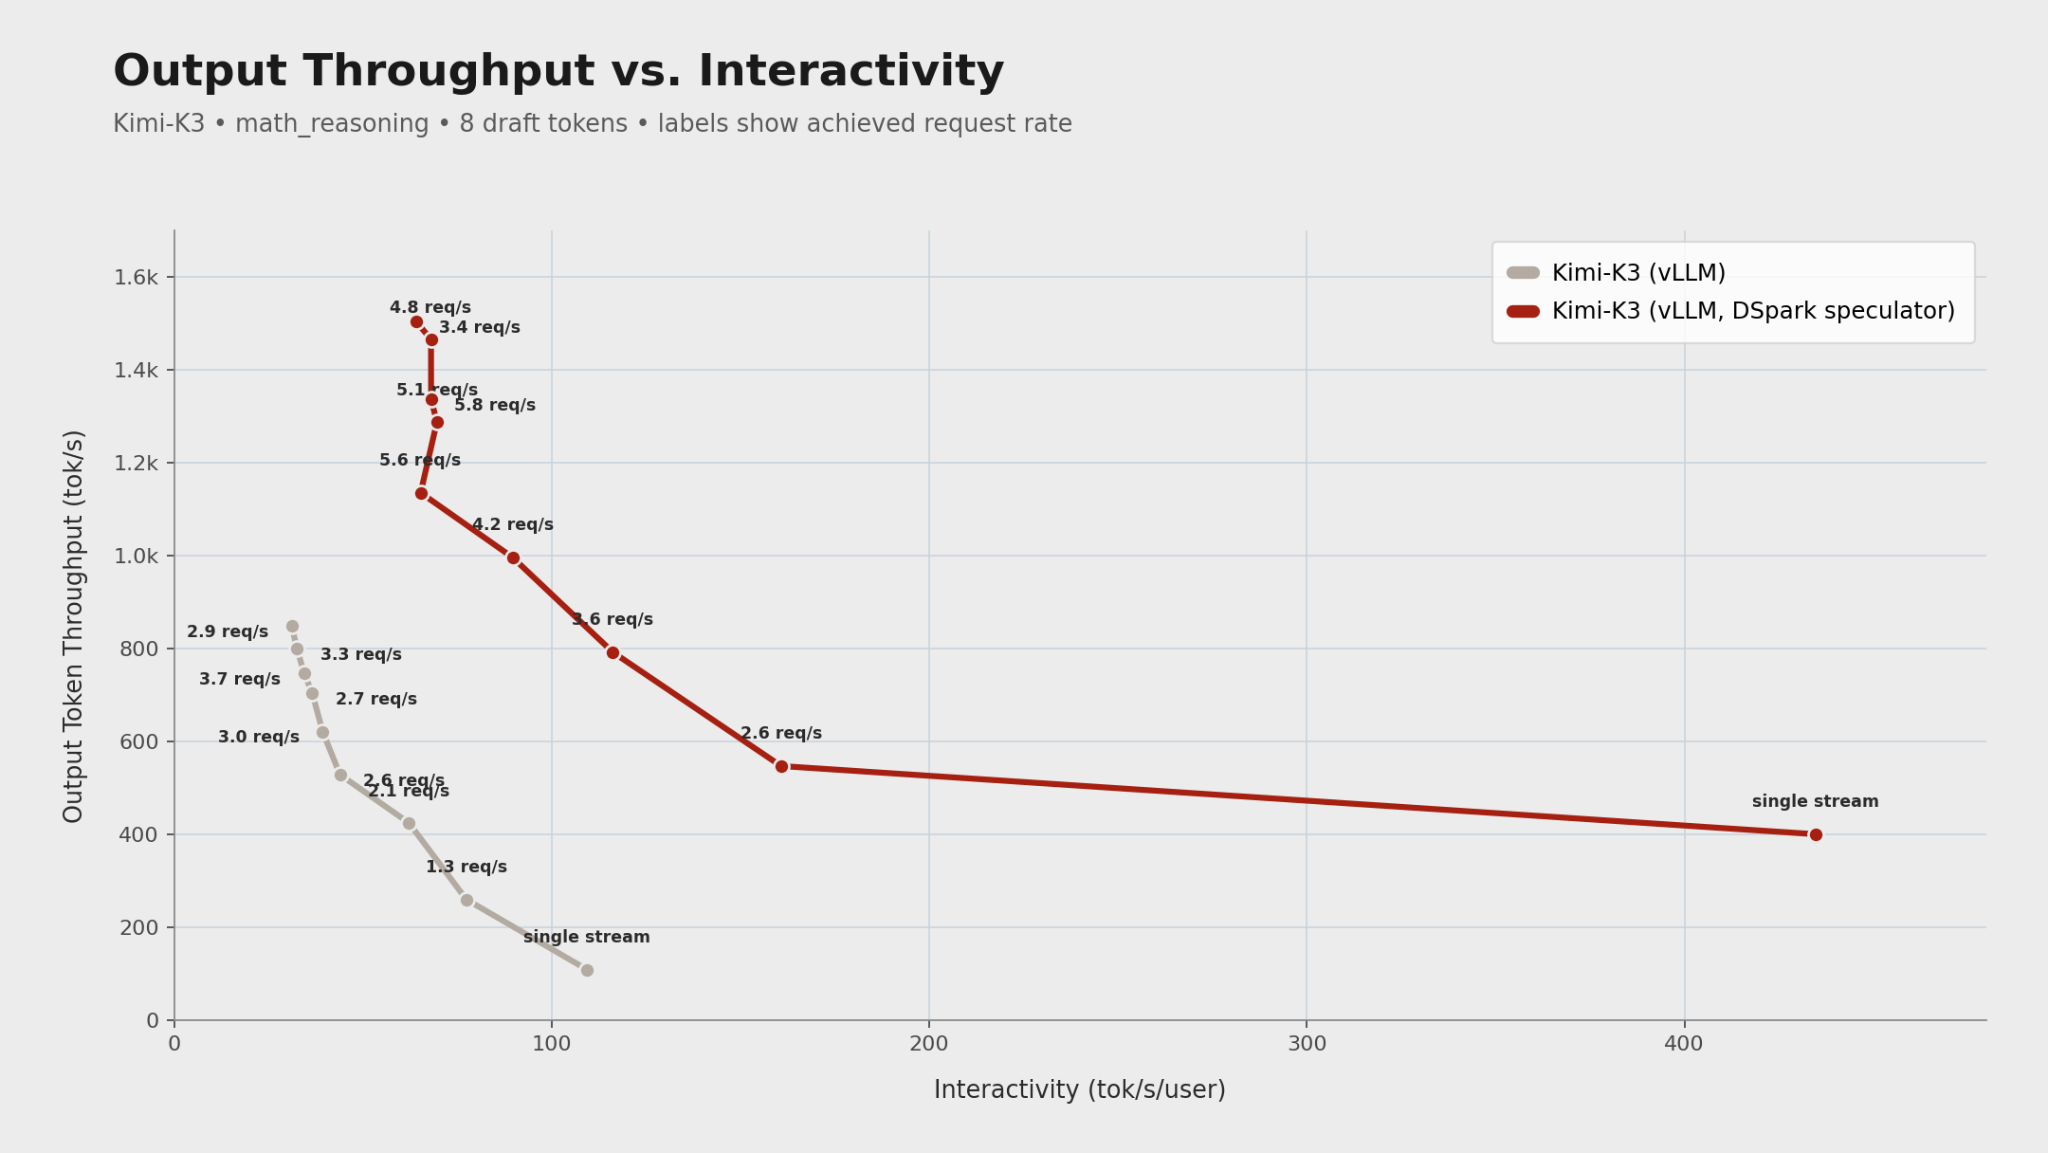
vLLM 正式支援 Kimi K3 模型,提供 Day-0 的高效部署方案,整合 KDA 混合注意力、DSpark 猜測解碼與分散式架構。
vLLM 正式支援 NVIDIA Nemotron 3.5 Lightning 模型,提供 OpenAI 相容 API 與推測解碼功能。文章介紹了該混合專家架構模型的規格、部署方式及效能最佳化技術,幫助開發者將模型整合進生產環境。
介紹 vLLM TT Plugin 如何將 Tenstorrent 加速卡整合進 vLLM,透過標準外掛機制支援多模型架構與異構網格。讀者可了解其基於網格架構的階段式排程、單一程序資料並行與裝置端取樣設計,無需修改現有客戶端程式碼即可部署。
介紹 vLLM 的階層化 KV Cache 離線架構,說明如何將資料移至主機記憶體、檔案系統或遠端節點以減少重計算。讀者可了解其主機中心設計原理、不同離線層級運作方式及效能提升機制。
詳細介紹如何在 AMD Instinct MI355X 上最佳化 MiniMax M3 模型的服務效能,透過分析區域性形狀、重複運算、資料搬移與快取策略,實現吞吐量大幅提升。
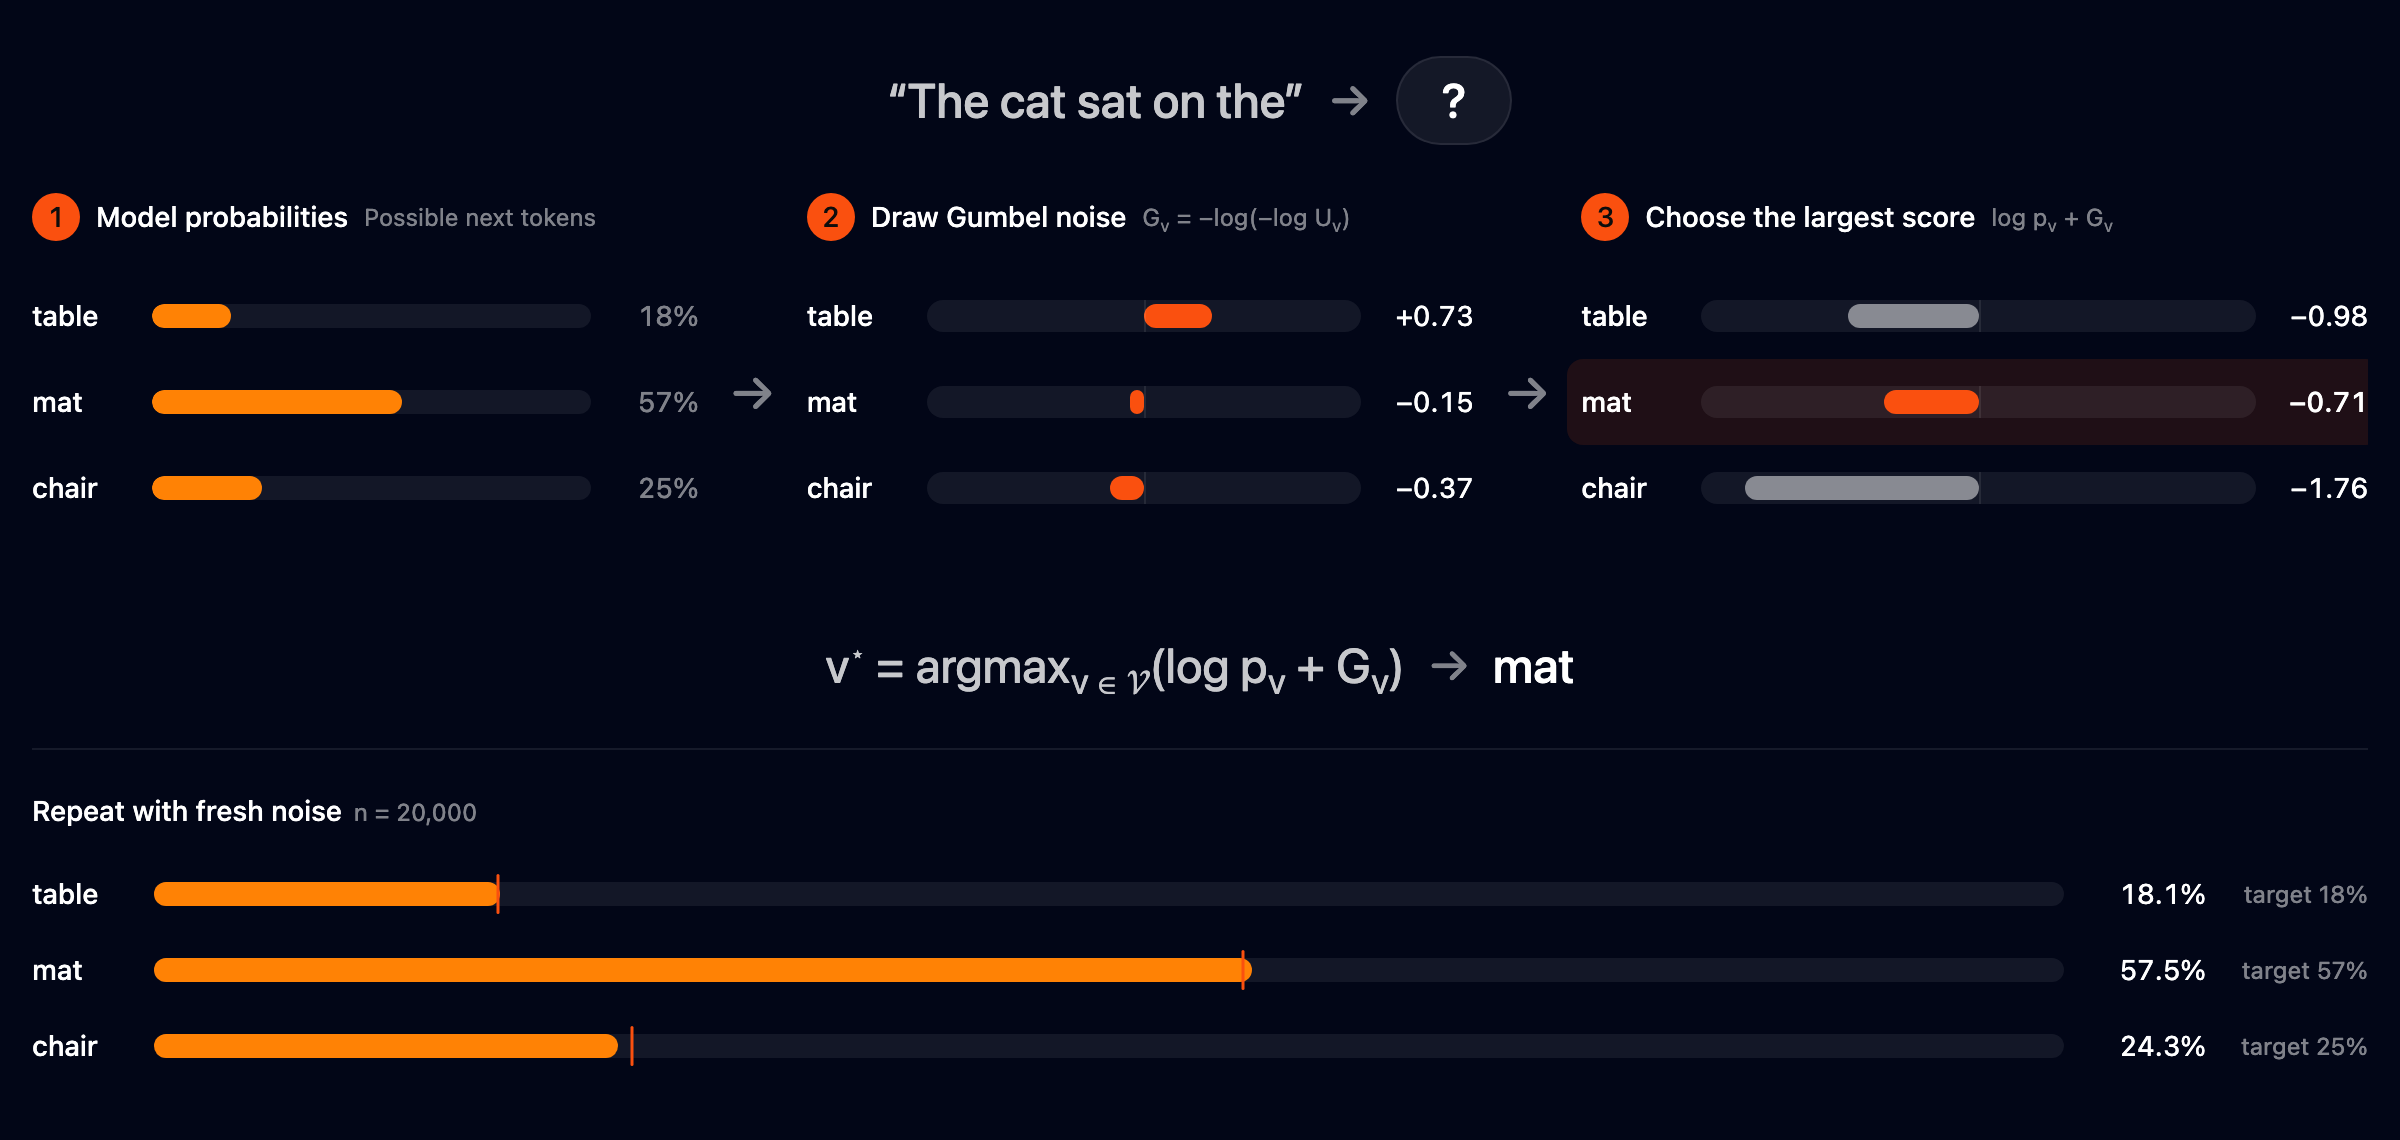
介紹 vLLM 如何透過 Gumbel-max 技巧與高效 GPU 核,在不改變模型輸出分佈的前提下實現文字水印。讀者可了解其原理、檢測機制及與推測解碼的整合方式,並掌握效能影響與挑戰的解決方案。
vLLM 推出 DSpark 的適應性驗證功能,不再固定驗證所有草稿 token,而是根據每個 token 的置信度動態分配驗證預算。
依發布時間
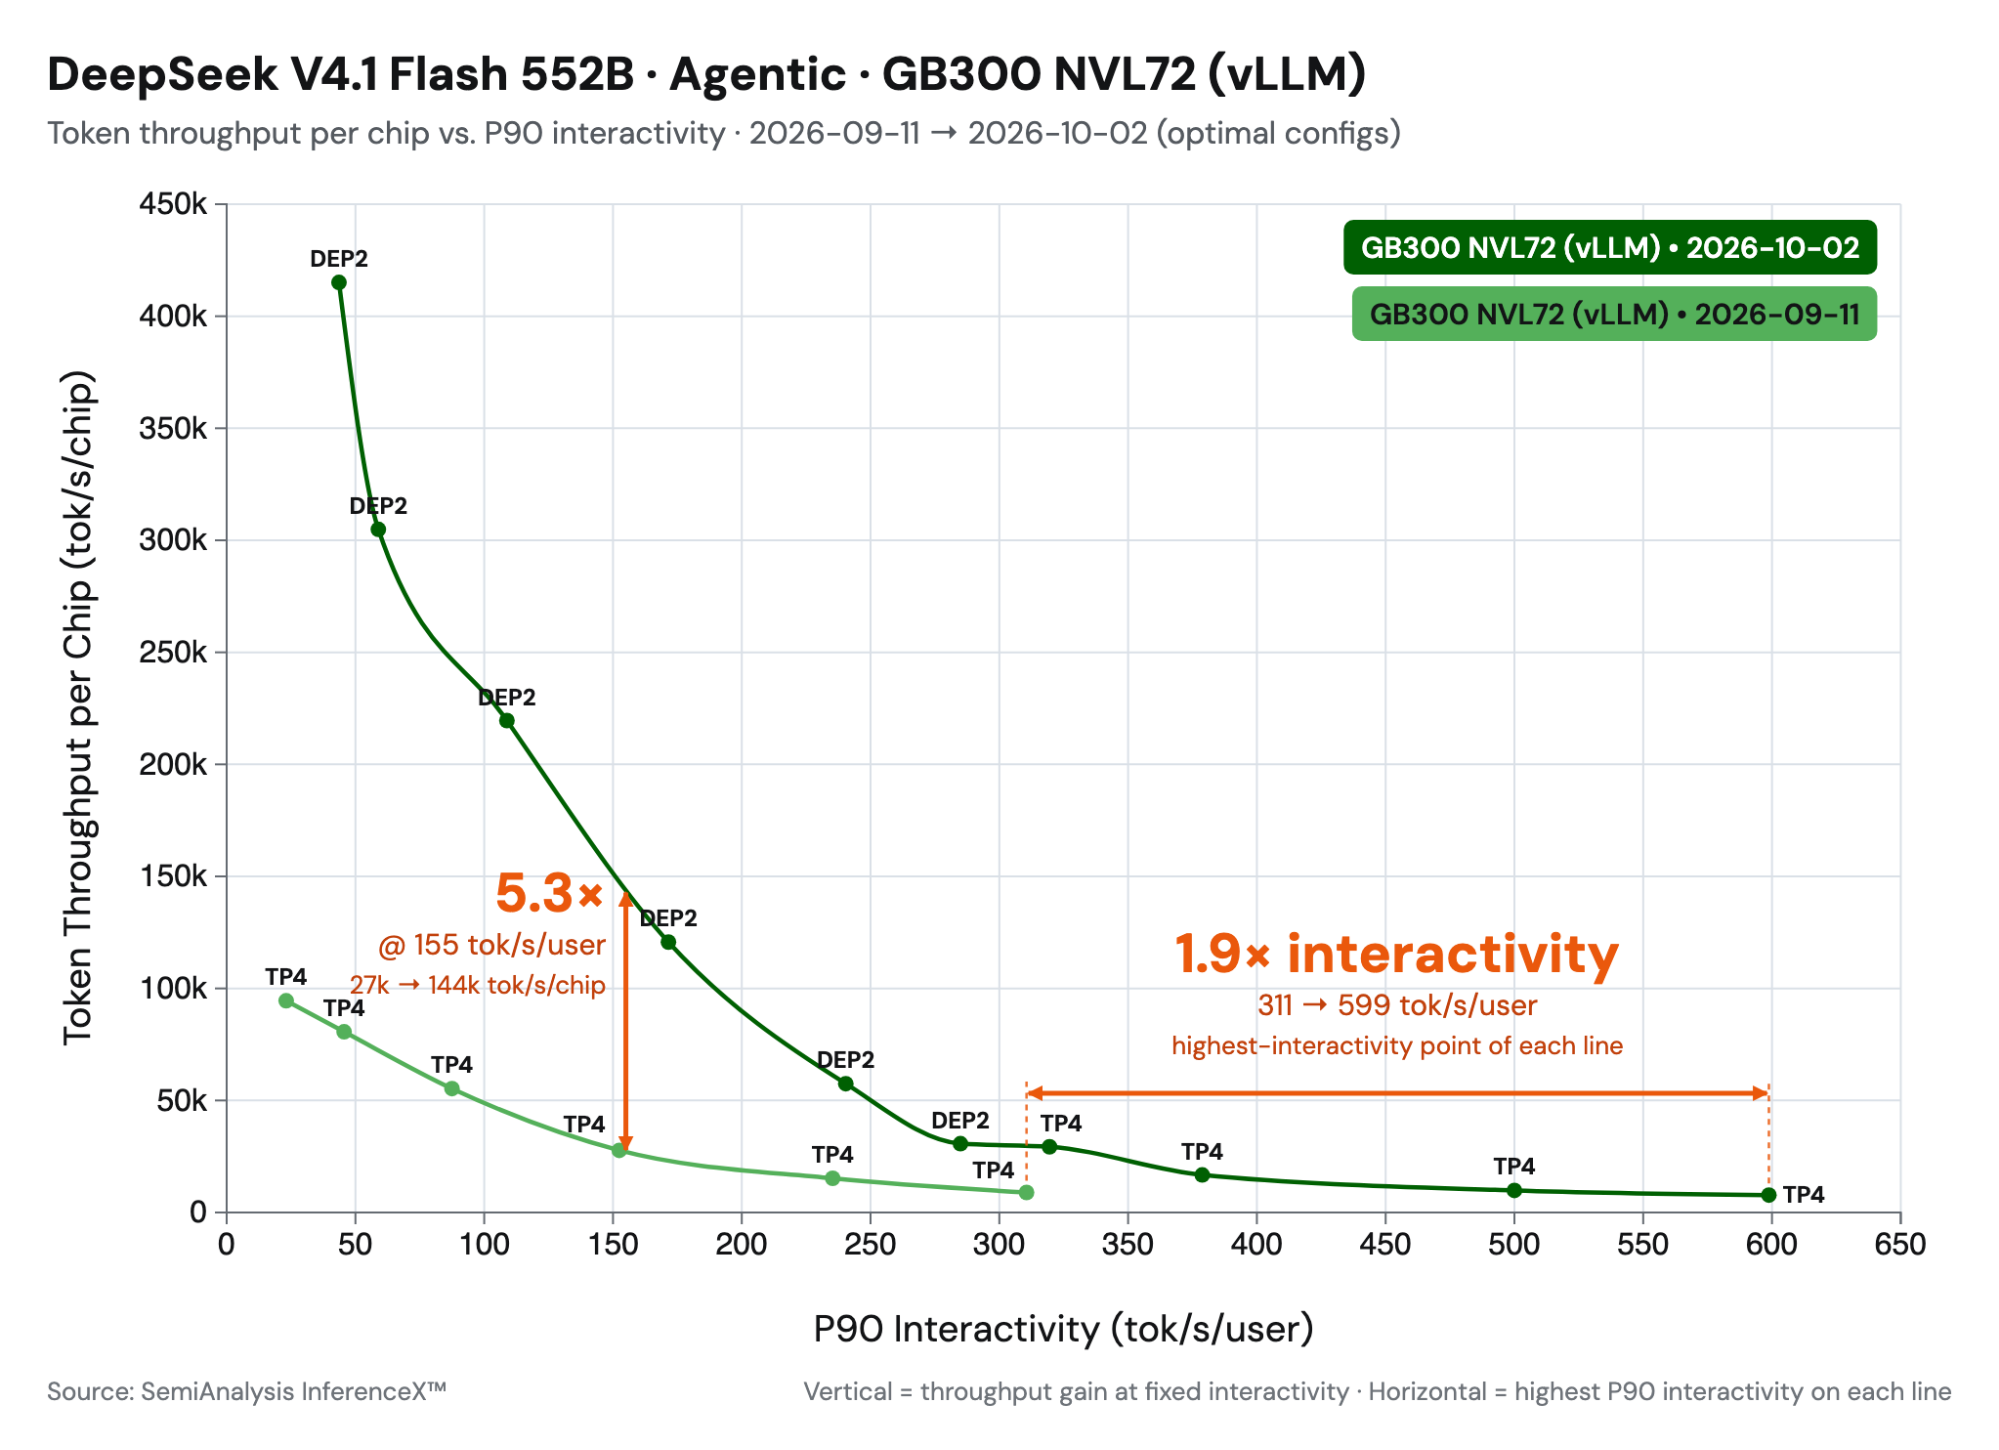
介紹 vLLM 團隊如何結合 DeepSeek-V4.1-Flash 的新架構與系統最佳化,將代理服務吞吐量提升 5 倍。內容涵蓋 SWA 有界重播、CUDA 圖表技術及多項新核函式整合,並驗證了模型精度與效能的顯著改善。
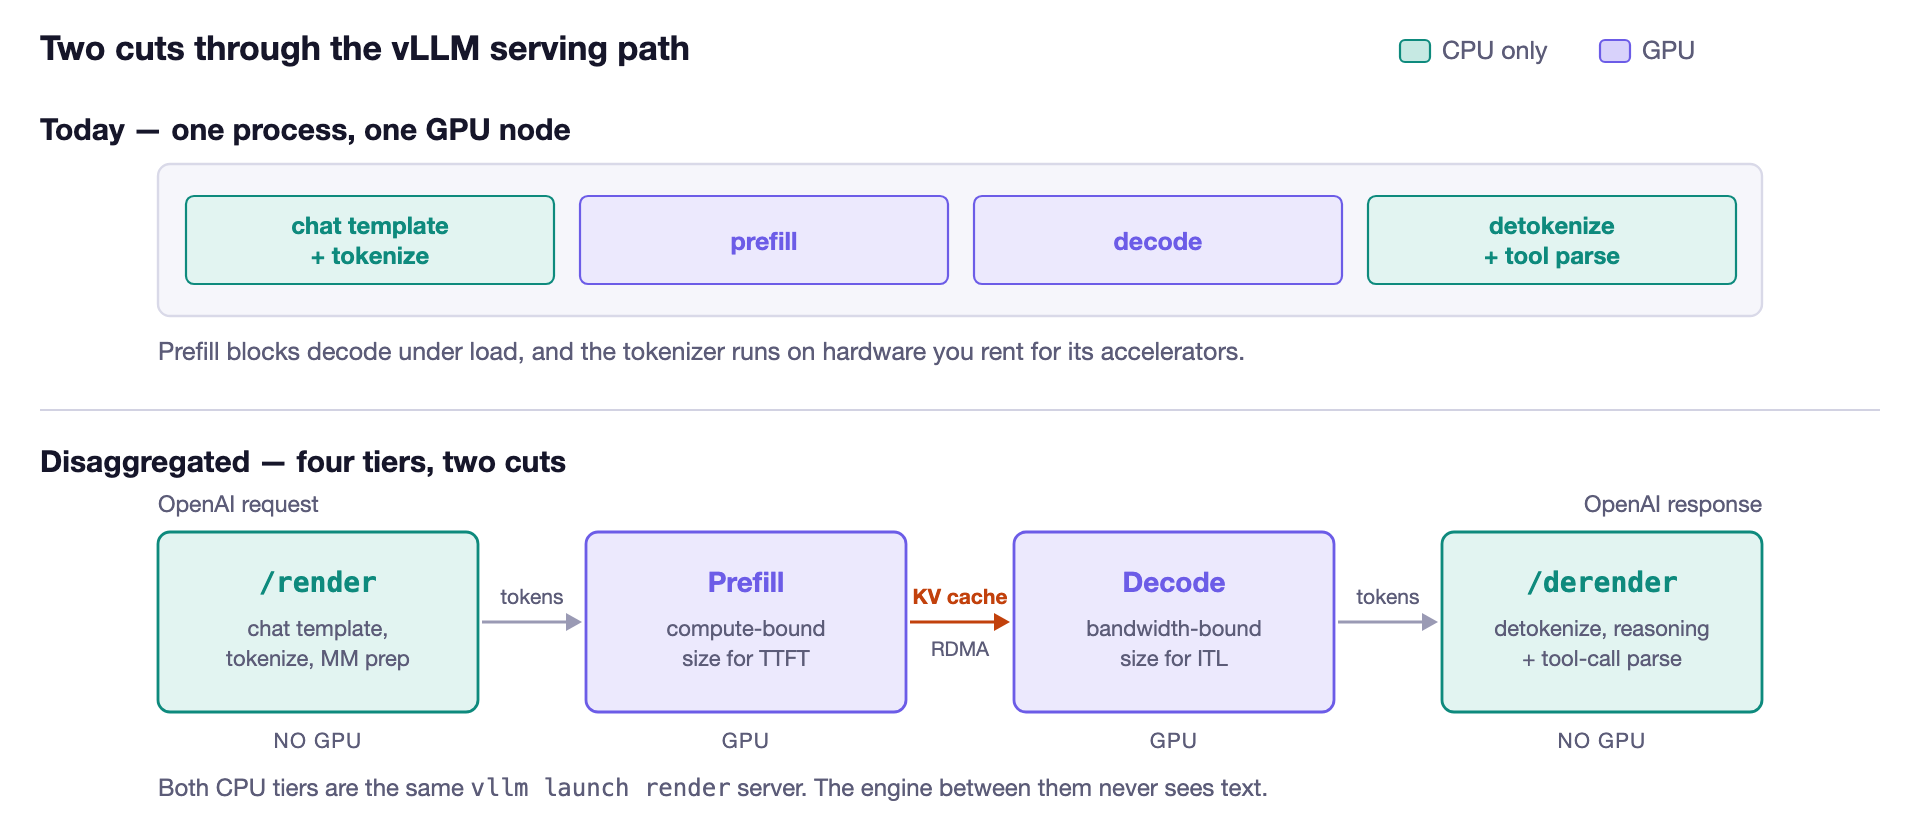
詳細介紹如何在 vLLM 中實作解耦式服務,將提示處理(prefill)與生成(decode)分開,並將前端處理移至 CPU。透過分離這些階段,可以有效降低長提示造成的延遲,提升系統在生產環境下的有效吞吐量與延遲表現。
介紹 vLLM 如何透過 Gumbel-max 技巧與高效 GPU 核,在不改變模型輸出分佈的前提下實現文字水印。讀者可了解其原理、檢測機制及與推測解碼的整合方式,並掌握效能影響與挑戰的解決方案。
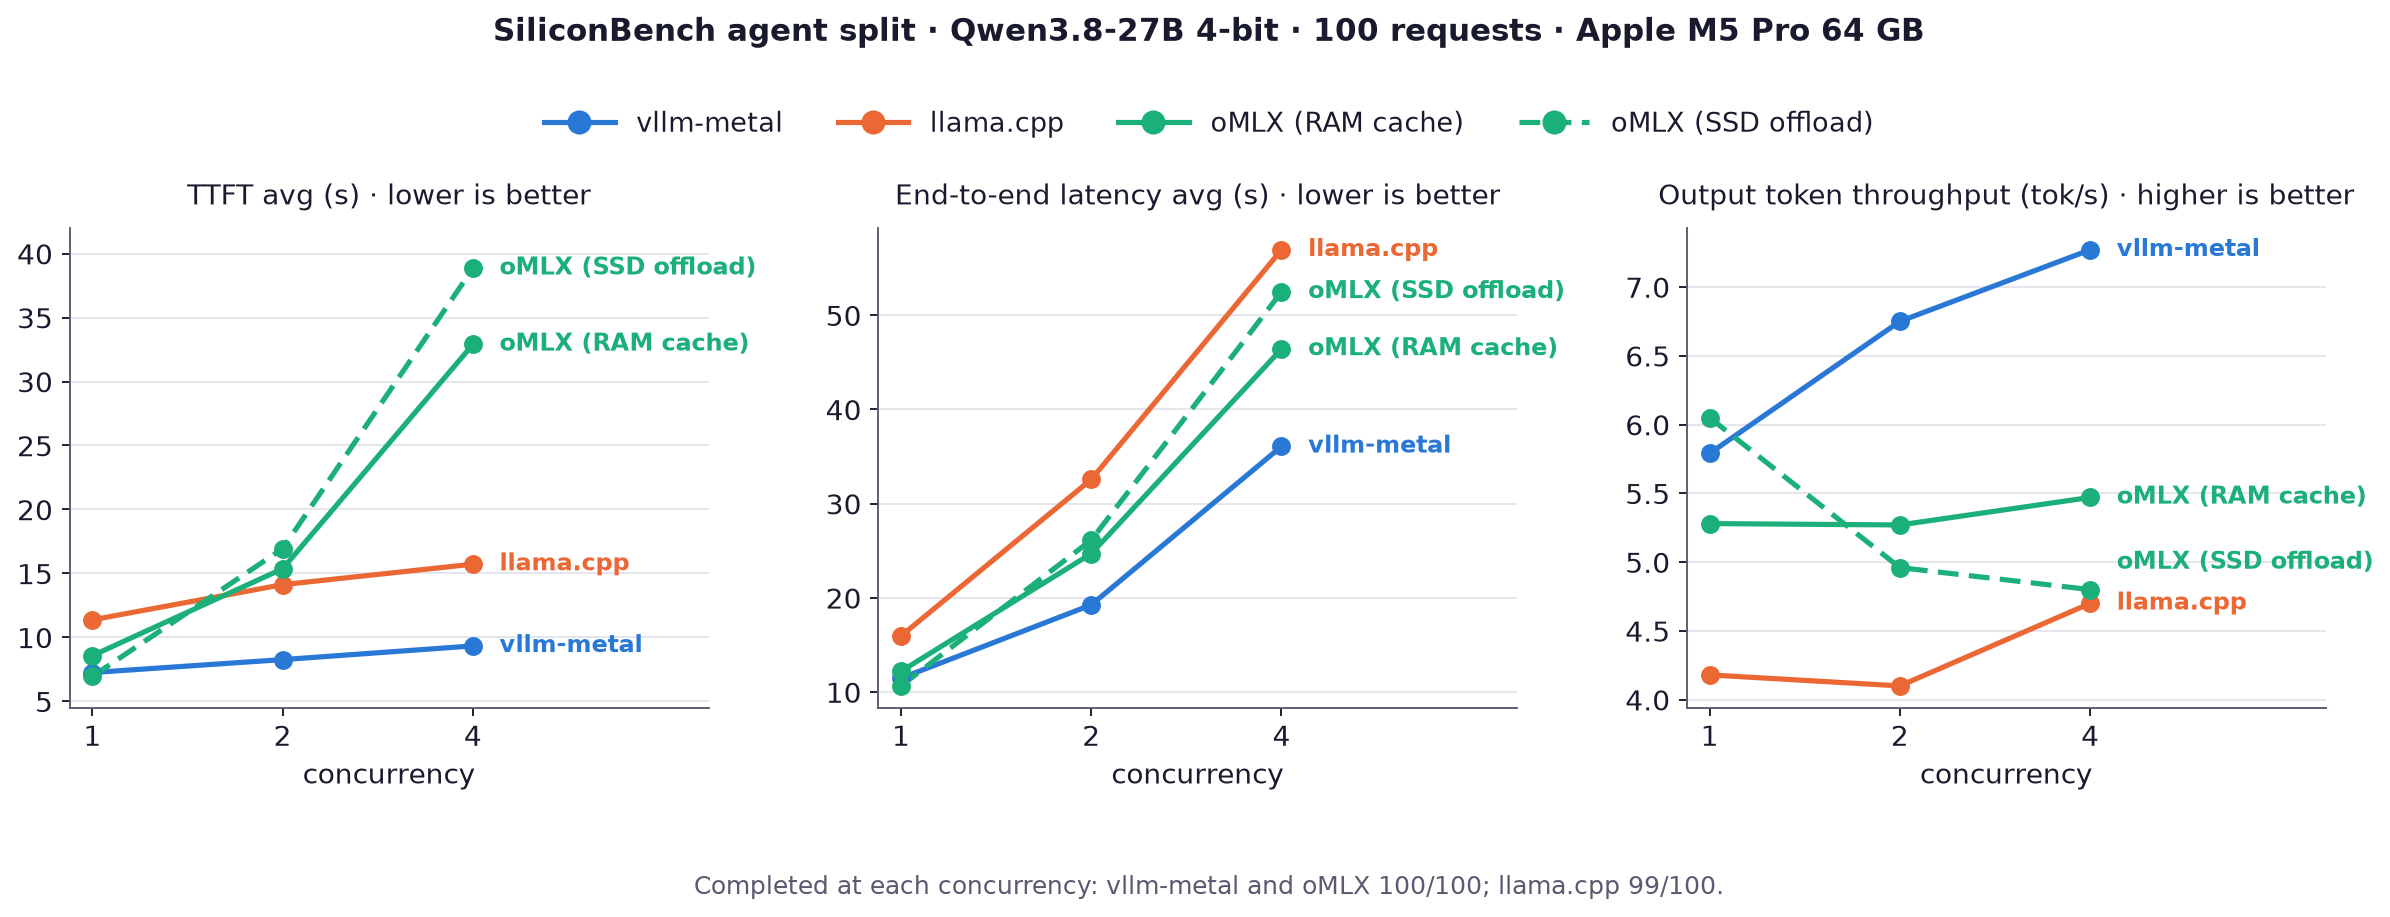
vLLM 官方宣佈推出 vllm-metal,將 vLLM 的並行服務架構移植到 Apple Silicon,支援 M5 晶片加速預填與批次多 token 預測。
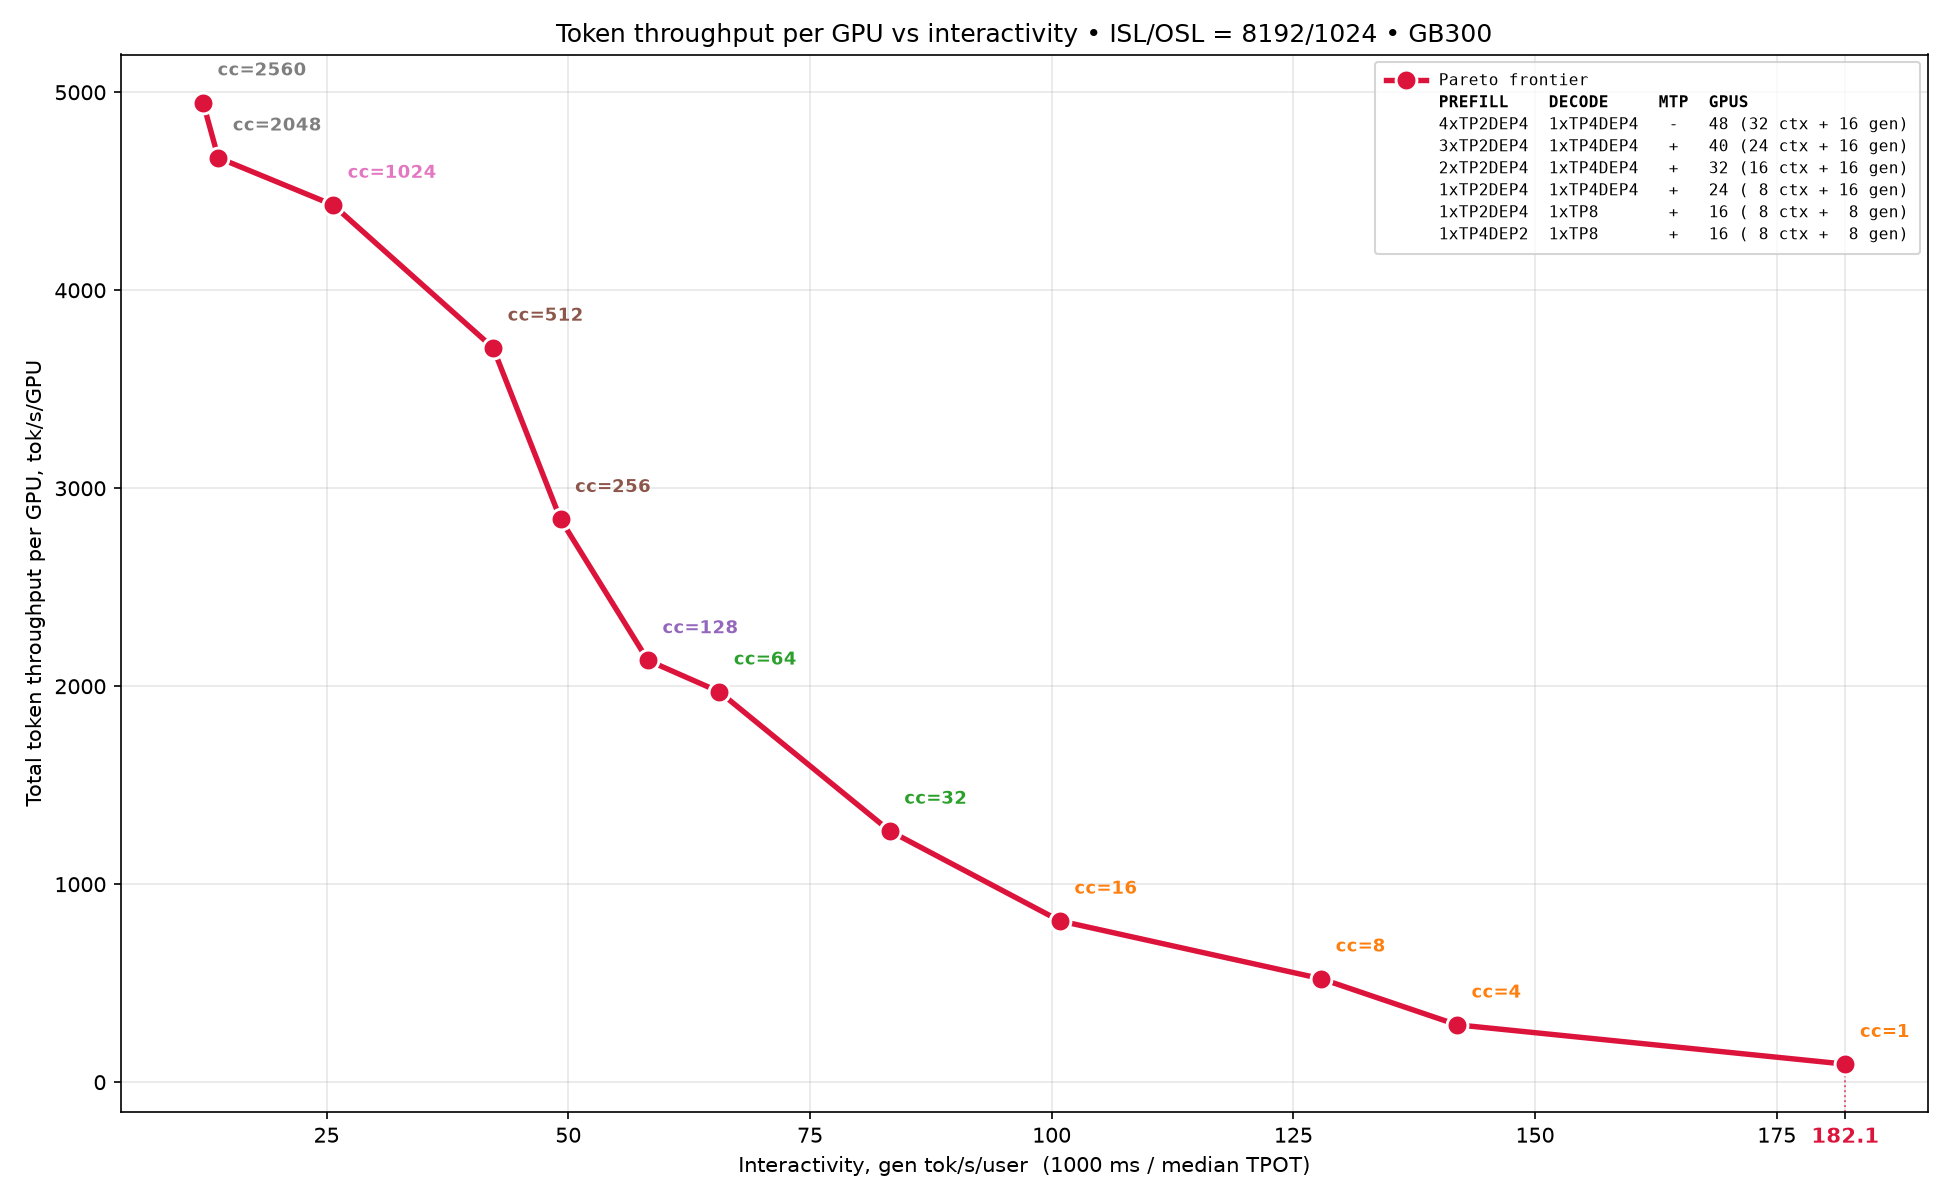
介紹如何在 GB300 NVL72 叢集上,使用 vLLM 對 Qwen3.8-2.4T 模型進行 PD 服務最佳化,達成每秒 5000 總 token 吞吐與 180 生成 token 使用者互動。
介紹如何透過 PyNvVideoCodec 利用 NVIDIA GPU 硬體解碼功能,解決 vLLM 處理影片描述任務時 CPU 成為瓶頸的問題。
介紹如何使用 Speculators 庫與 Mooncake 傳輸引擎,在 GB300 NVL72 硬體上訓練 Kimi-K3 的 DSpark 推測解碼模型。讀者可學習如何整合開源工具進行大規模模型訓練,並提升推理效能與吞吐量。
Novita AI 公開 Chord,這是針對 Kimi K2.x 架構的高效能 W4A16 MoE CUDA 運算元,整合於 vLLM Humming 後端。
介紹如何在 AMD Instinct MI300X 上實現 Megatron 訓練與 vLLM 推論的位元級一致性。透過 vime 與 RL-Kernel 解決因浮點運算差異導致的對齊問題,驗證了 200 個步驟內無誤差。
介紹 Kimi K3 在 vLLM 中的效能最佳化,透過排程、KDA 字首快取、零複製批次與延遲化計算等技術,將吞吐量提升 2.8 倍。讀者可了解如何解決 Mamba 架構的瓶頸並提升推理效率。
介紹 vLLM 的階層化 KV Cache 離線架構,說明如何將資料移至主機記憶體、檔案系統或遠端節點以減少重計算。讀者可了解其主機中心設計原理、不同離線層級運作方式及效能提升機制。
詳細介紹如何在 AMD Instinct MI355X 上最佳化 MiniMax M3 模型的服務效能,透過分析區域性形狀、重複運算、資料搬移與快取策略,實現吞吐量大幅提升。
vLLM 團隊介紹 Hybrid HiSparse 技術,透過將稀疏注意力模型的 KV Cache 部分移至 CPU,解決大模型推理時記憶體不足的問題。此最佳化讓 GLM 5.3 能在單一節點上支援更長上下文與更高併發量,同時保持推理流暢。
介紹 vLLM 如何針對 AgentX 等真實世界代理工作負載進行最佳化,涵蓋 KV 快取管理、並行架構調整與 P/D 分離策略。
介紹 vLLM TT Plugin 如何將 Tenstorrent 加速卡整合進 vLLM,透過標準外掛機制支援多模型架構與異構網格。讀者可了解其基於網格架構的階段式排程、單一程序資料並行與裝置端取樣設計,無需修改現有客戶端程式碼即可部署。
介紹如何透過 vLLM-Omni 最佳化 MiniMax H3 的完整服務架構,並整合 FastVideo 的 FastH3 技術,將生成速度提升至快於播放。
深入探討 vLLM 在 AMD GPU 上實現預解碼(Speculative Decoding)的技術細節,涵蓋 MTP、EAGLE-3、DFlash 等草案機制與驗證流程。
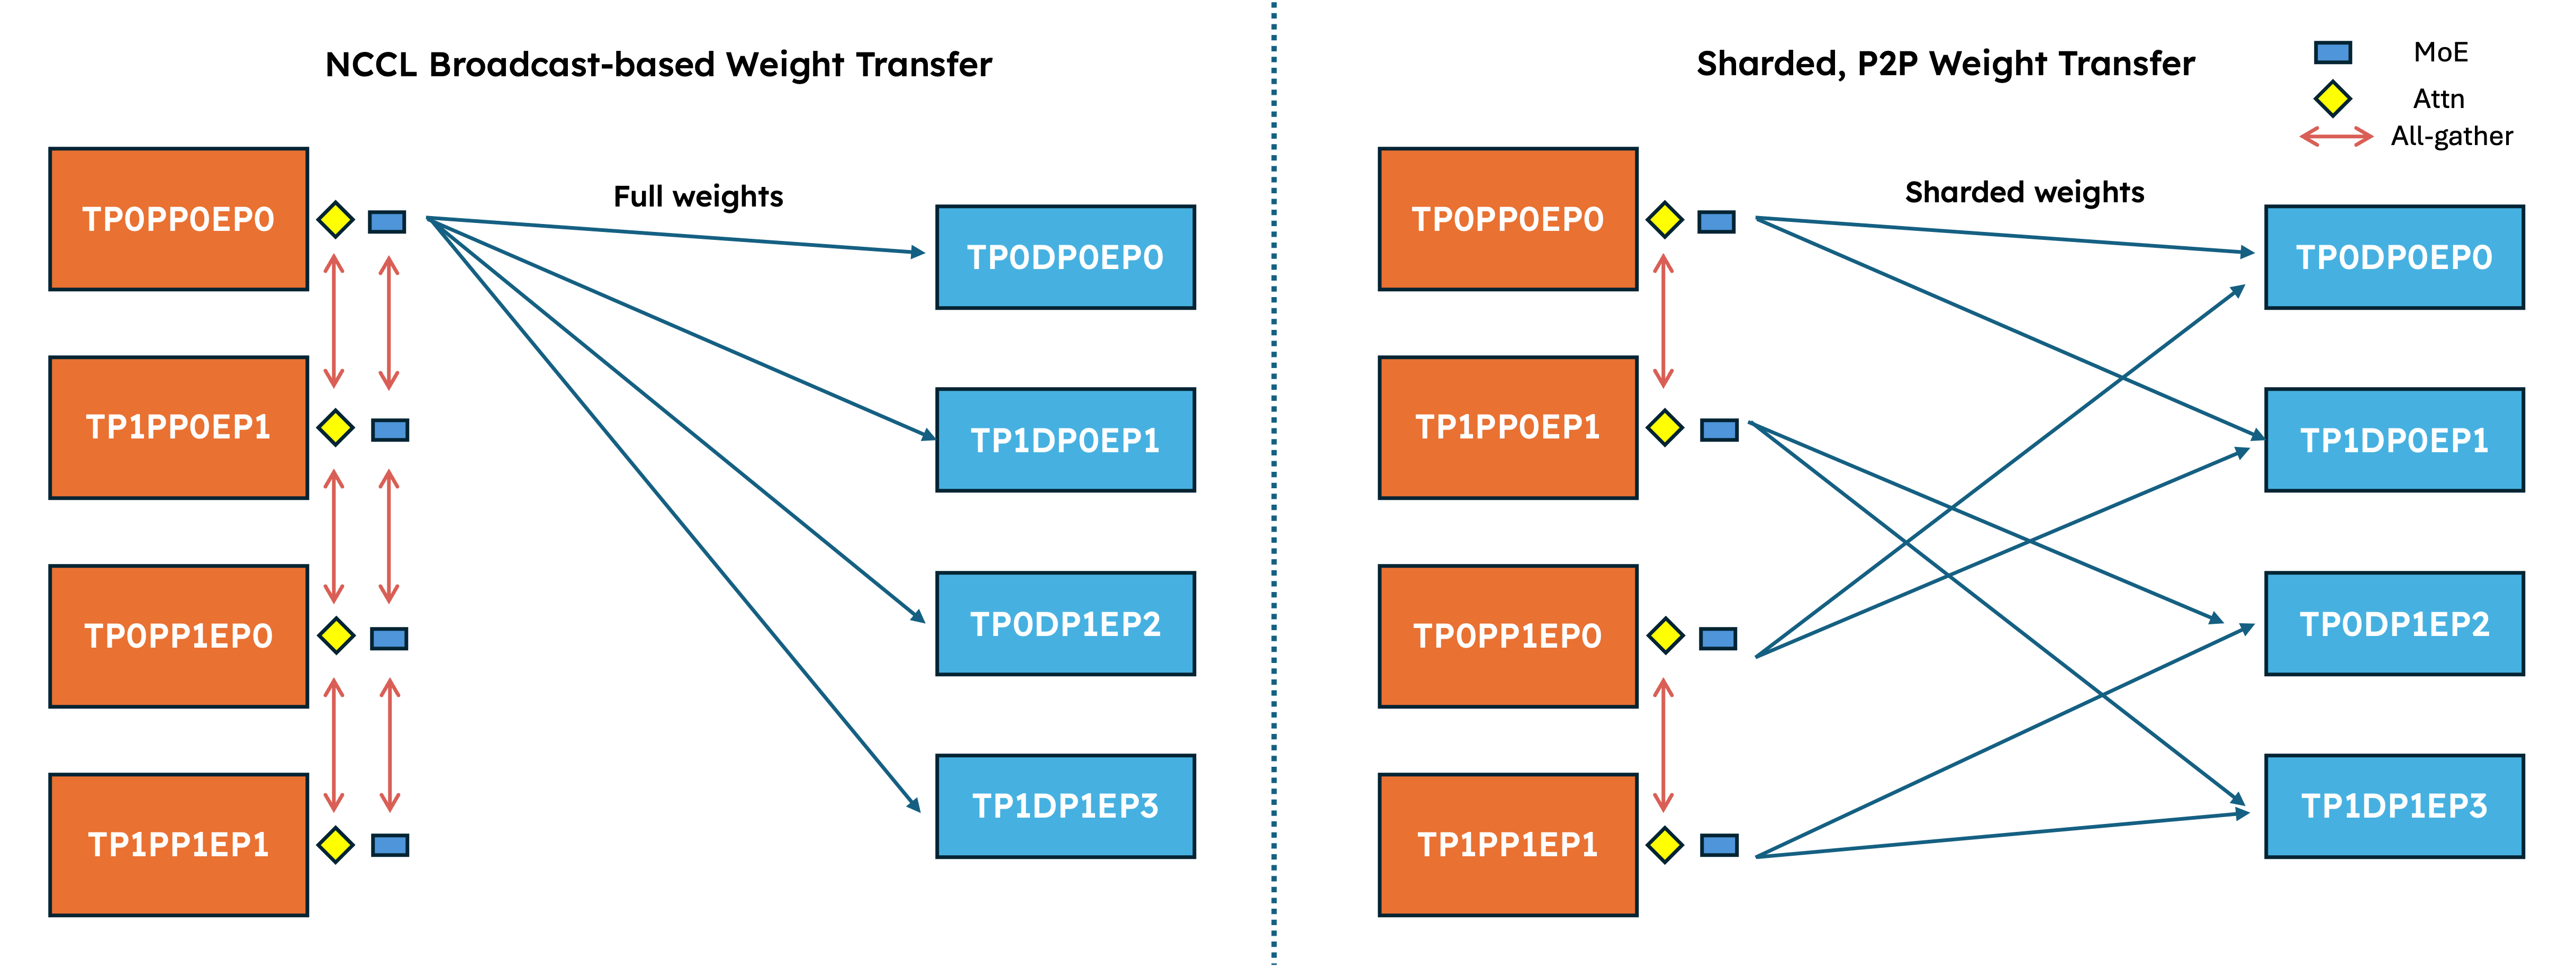
vLLM 團隊介紹如何利用 Ray Direct Transport (RDT) 與 NIXL 實現大規模分塊權重傳輸,解決大模型訓練中權重同步慢與記憶體消耗高的問題。
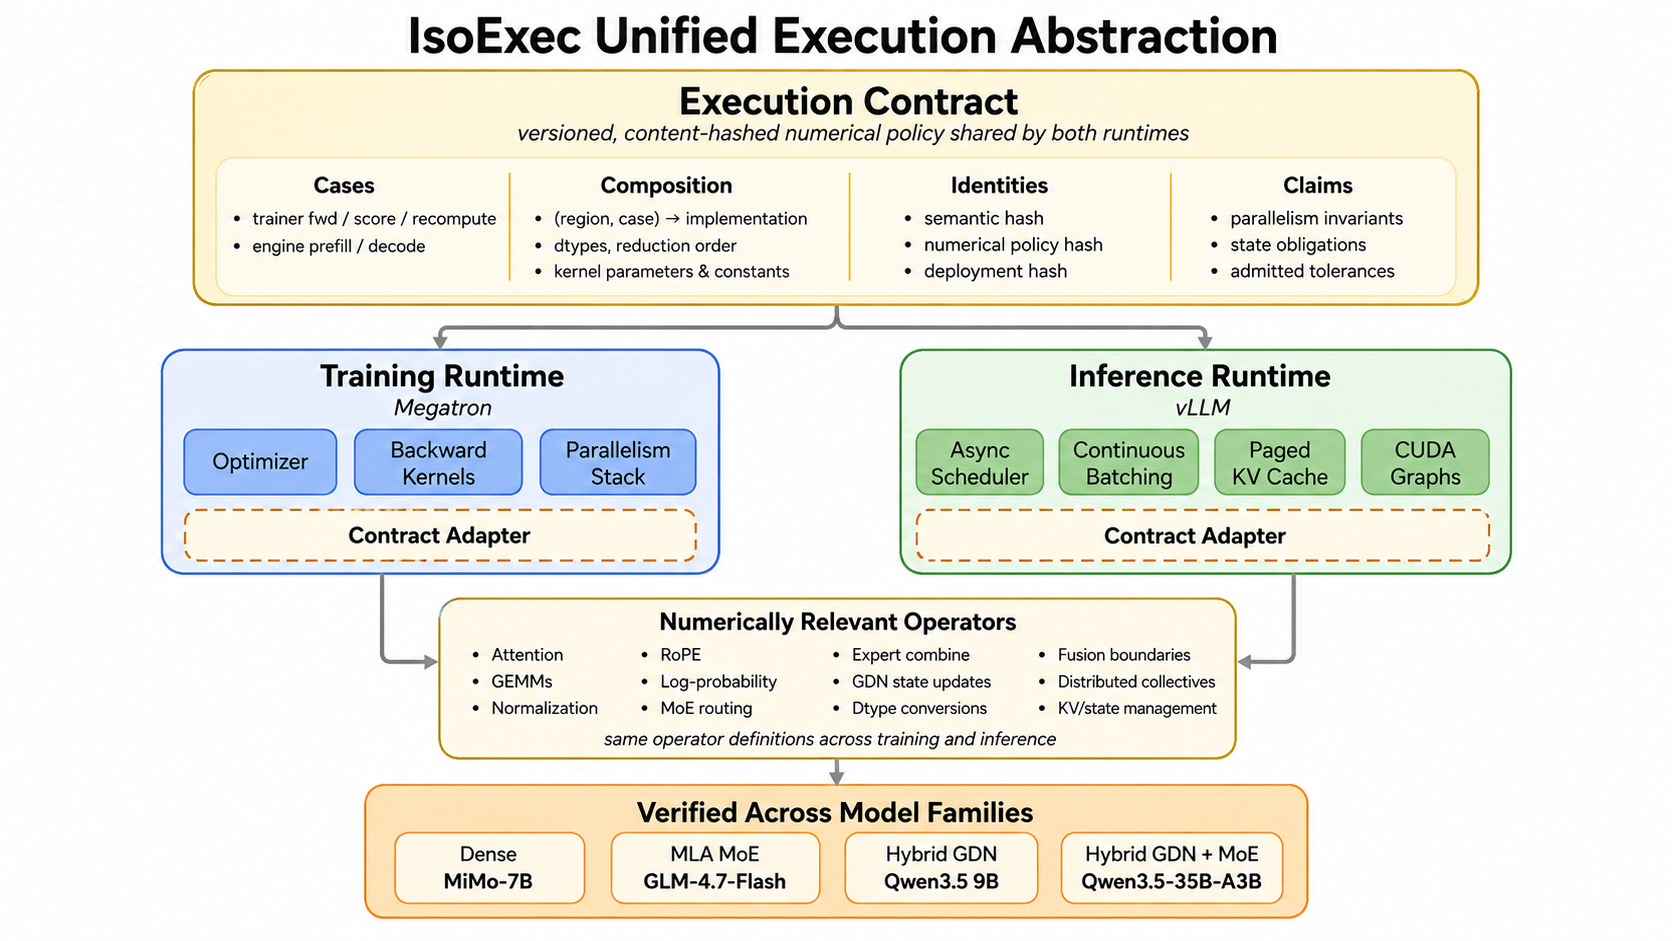
介紹 IsoExec,一種統一執行抽象,用於消除訓練與推論引擎間的浮點數不匹配問題。透過執行合約與位元一致的核心,確保 RL 訓練與推論使用相同策略時結果一致,降低除錯成本並提升系統穩定性。
介紹 VeRL-Omni v0.2.0 版本,透過請求級批處理與可重用的全模態訓練架構,大幅提升擴散模型強化學習的訓練效率與穩定性。讀者可了解如何最佳化 GPU 利用率、減少生成延遲,以及使用新支援的模型與演算法進行訓練。
介紹 vLLM-Omni 的分散式層級解除安裝技術,解決大規模 DiT 模型(如 124GB Cosmos3)無法單一裝置執行的問題。透過記憶體共享與並行請求處理,讓模型能高效跨多卡執行,並提供具體的程式碼快速開始範例。
vLLM 推出 DSpark 的適應性驗證功能,不再固定驗證所有草稿 token,而是根據每個 token 的置信度動態分配驗證預算。
vLLM 宣佈對 Qwen3.8-2.4T-A95B 模型實現 Day 0 支援,提供 FP8、BF16 及 NVFP4、MXFP4 量化權重。
vLLM 正式支援 NVIDIA Nemotron 3.5 Lightning 模型,提供 OpenAI 相容 API 與推測解碼功能。文章介紹了該混合專家架構模型的規格、部署方式及效能最佳化技術,幫助開發者將模型整合進生產環境。
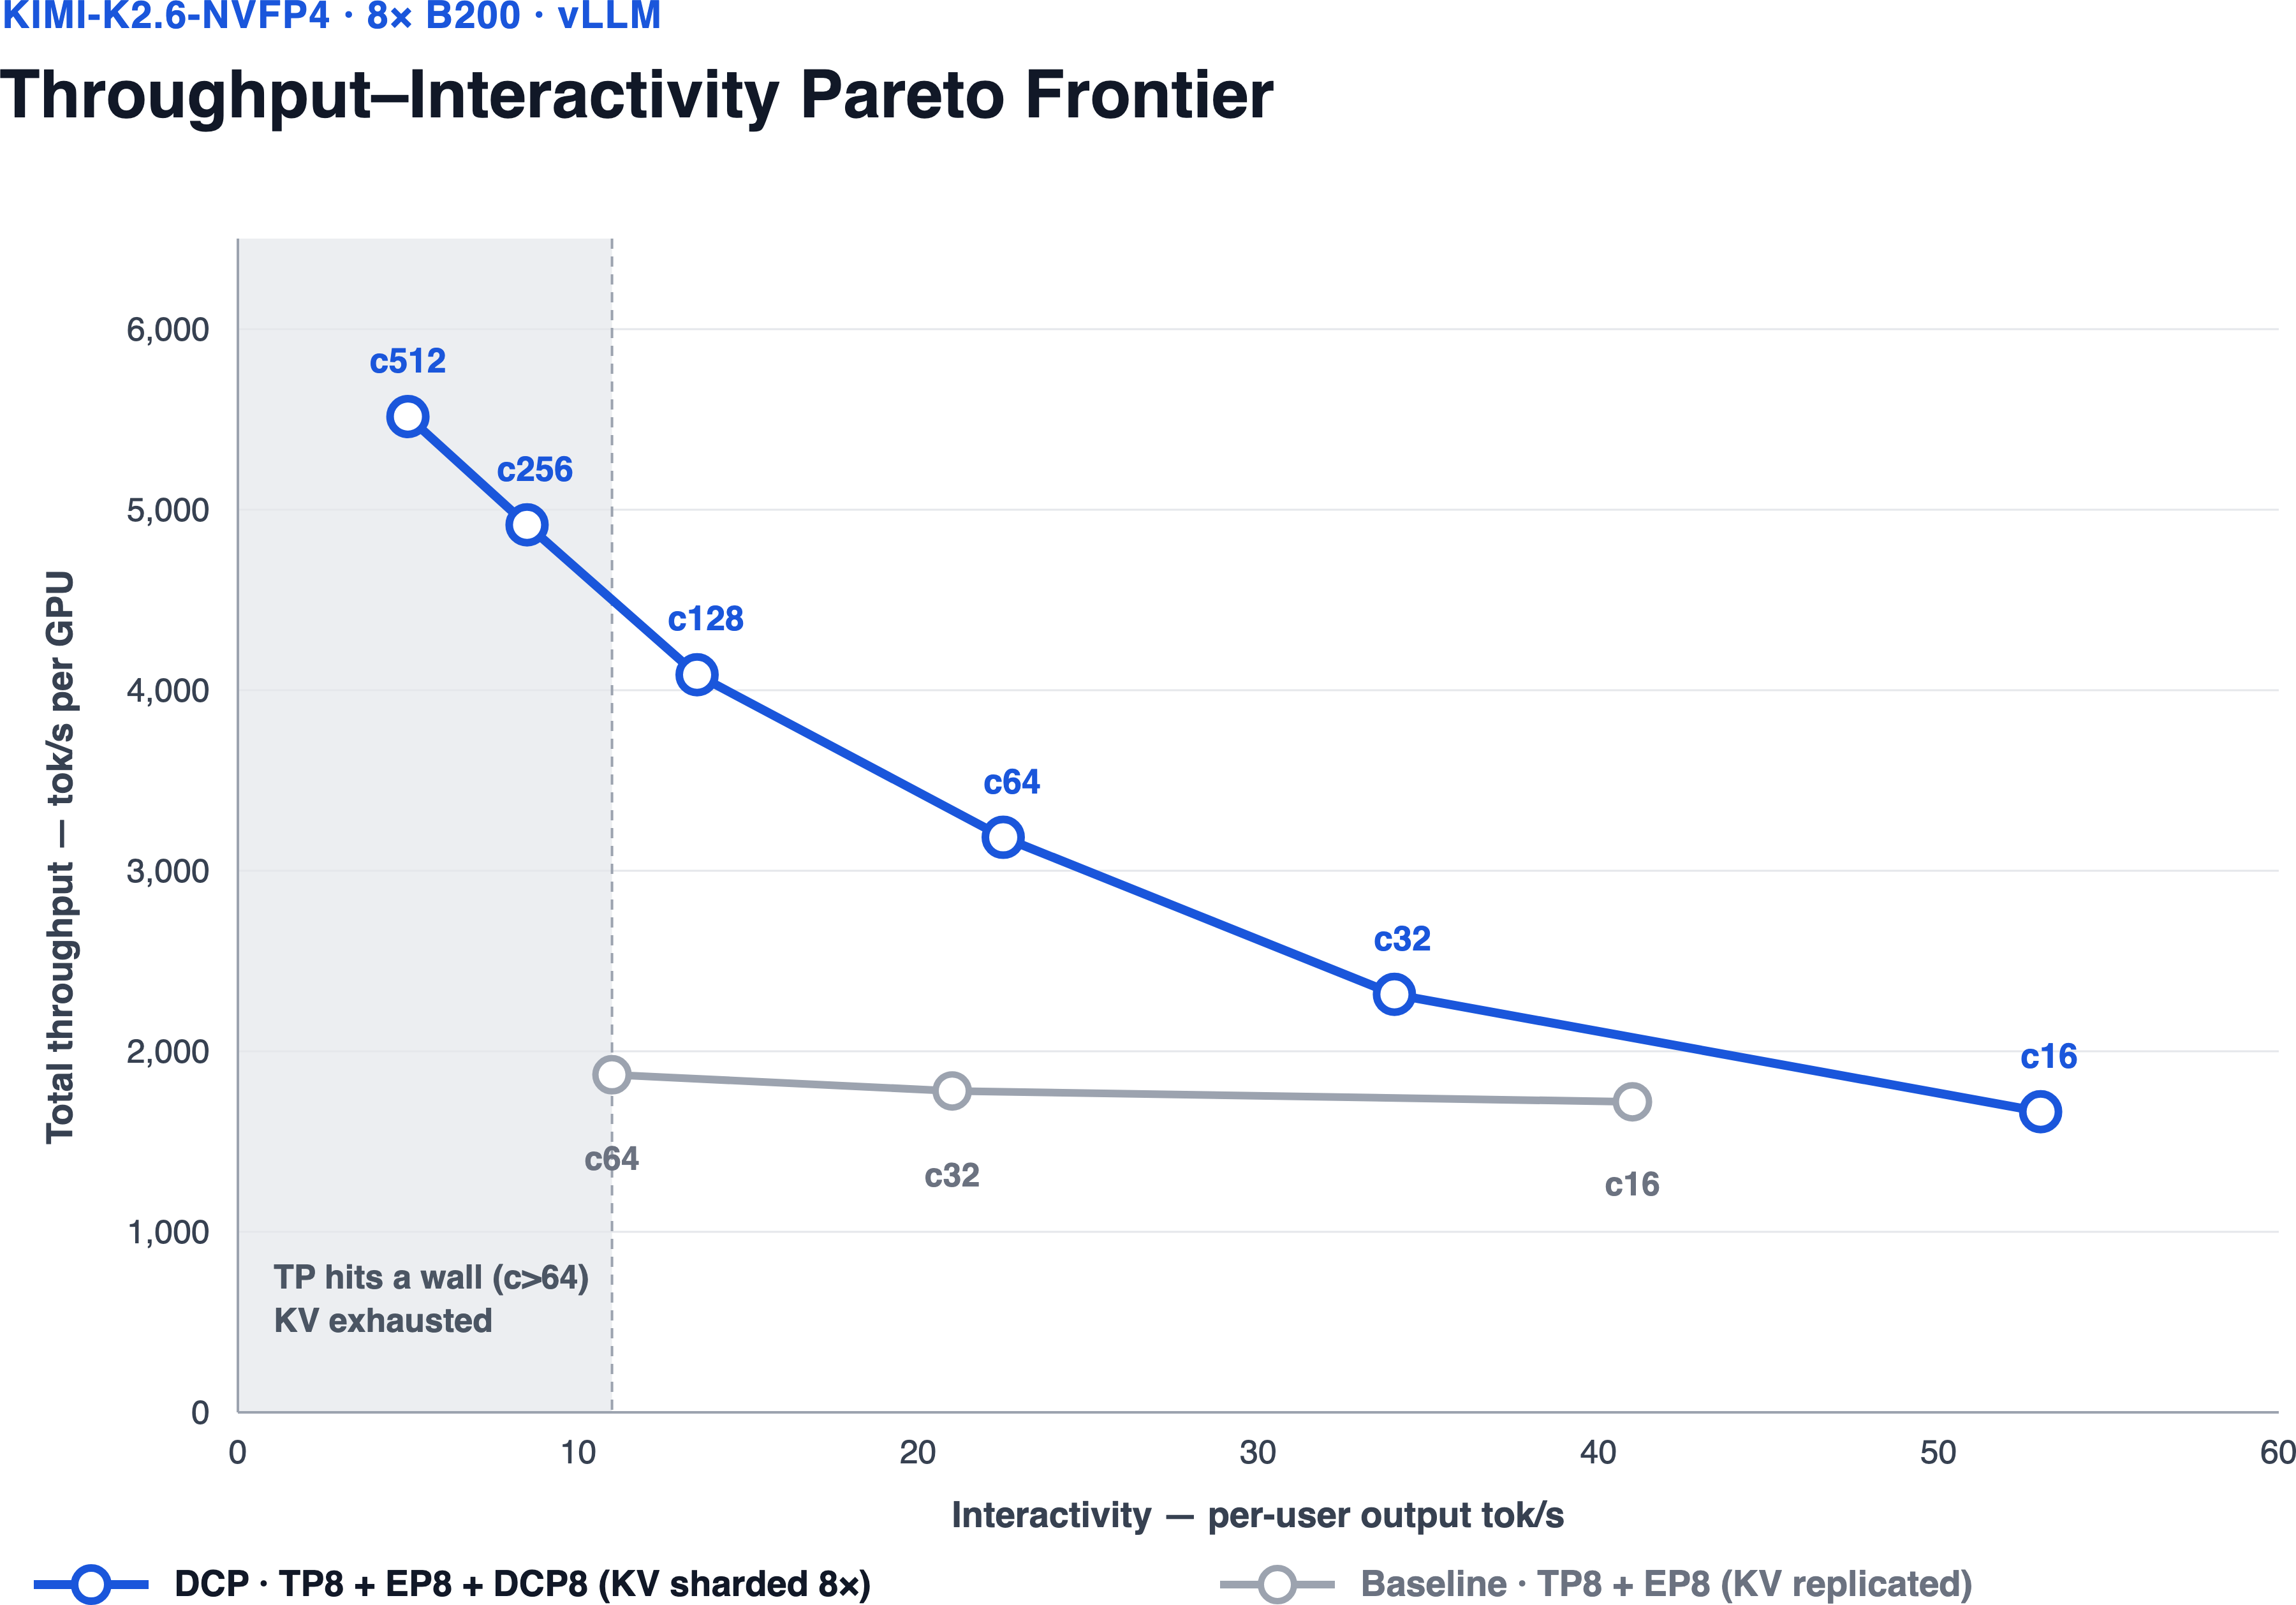
vLLM 推出 Decode Context Parallelism (DCP),透過將 KV Cache 按序列維度分片,解決長上下文推理時記憶體不足的問題。
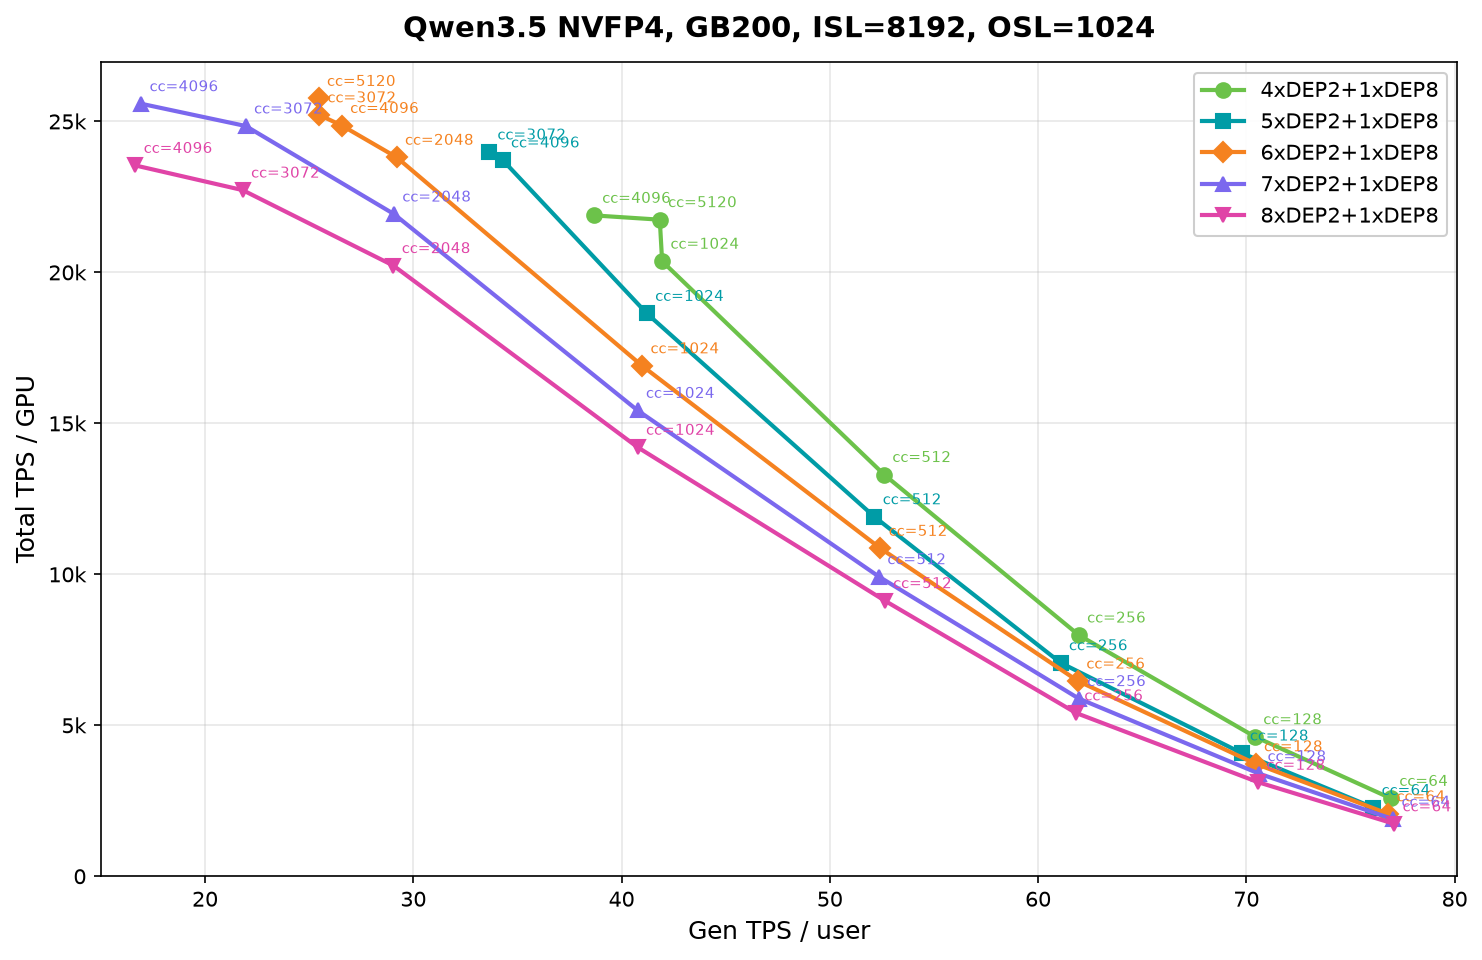
vLLM 團隊分享在 GB200 NVL72 系統上,利用 Blackwell GDN 核、混合快取轉移與無競態非同步排程等最佳化,讓 Qwen3.5-397B 模型達到每 GPU 每秒 25,000 字元的服務效能。
介紹 vLLM 在 Arm CPU 上的效能最佳化與功能擴充,涵蓋記憶體分配器、同步機制、權重預打包及量化加速等技術細節。讀者可了解如何提升大型語言模型在 Arm 伺服器上的推論速度與穩定性。
介紹 P-EAGLE、DFlash 和 DSpark 三種並行草稿演算法,取代傳統逐字產生方式,大幅提升大型語言模型推論速度。讀者能了解並行草稿如何解決記憶體與運算瓶頸,並掌握在 vLLM 環境中整合這些技術的具體方法。
vLLM 正式支援 Kimi K3 模型,提供 Day-0 的高效部署方案,整合 KDA 混合注意力、DSpark 猜測解碼與分散式架構。
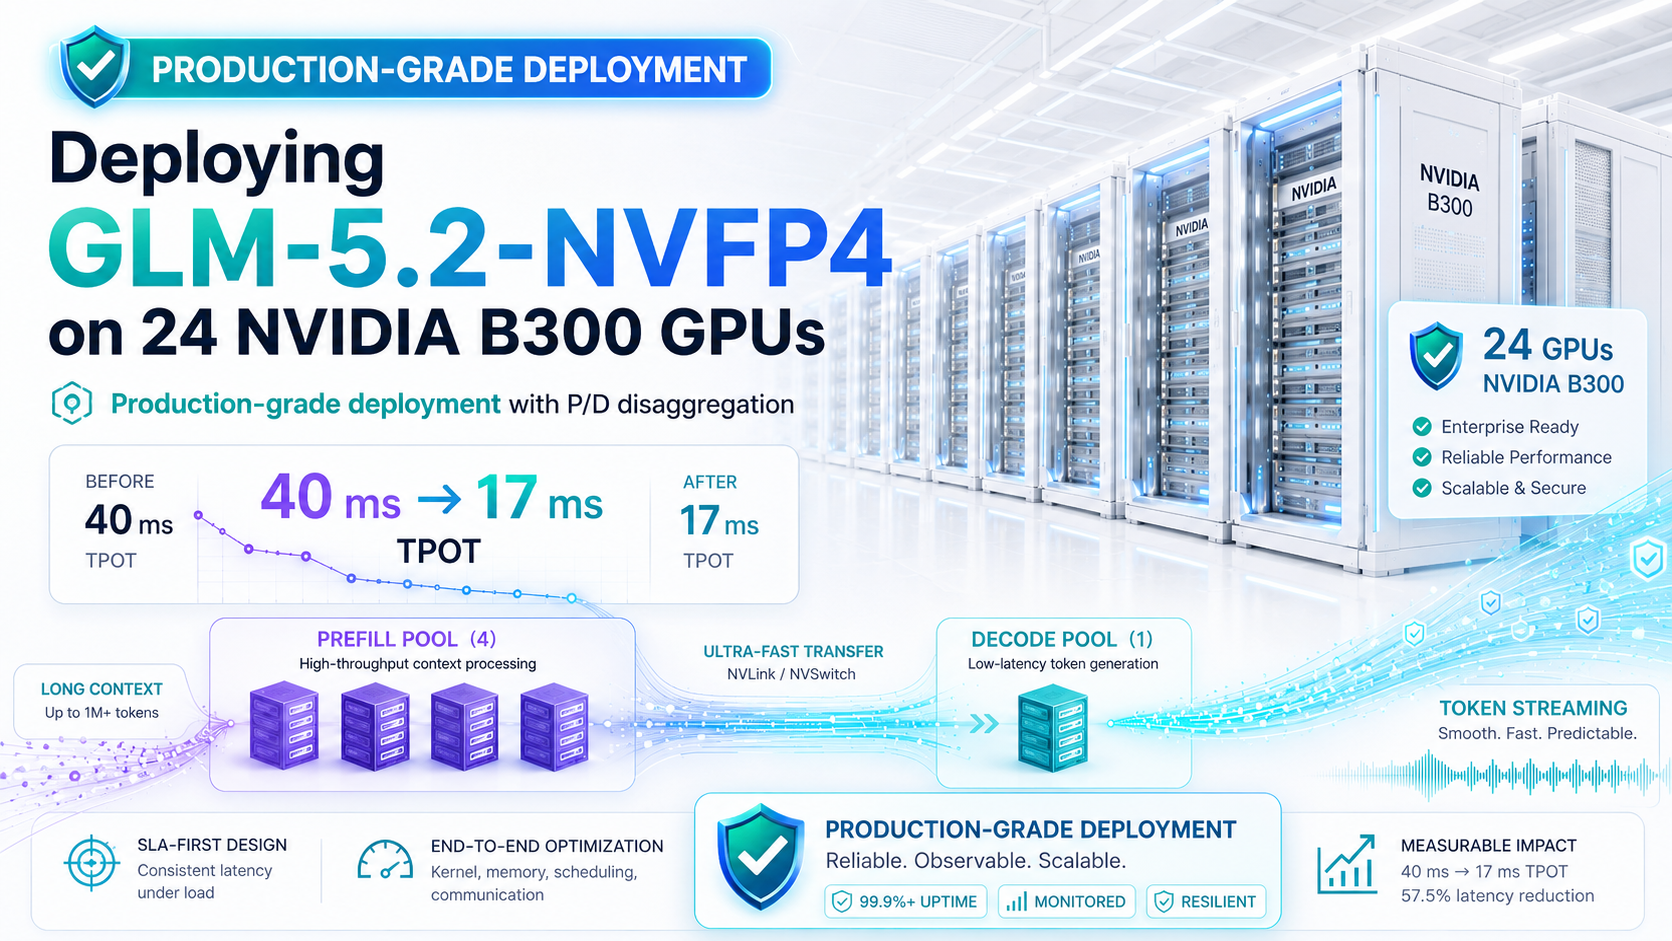
詳細記錄團隊如何將 GLM-5.2 模型在 24 張 NVIDIA B300 顯示卡上的平均 TPOT 從 40 毫秒最佳化至 17 毫秒,以符合生產環境的嚴格延遲指標。