文章高階EN
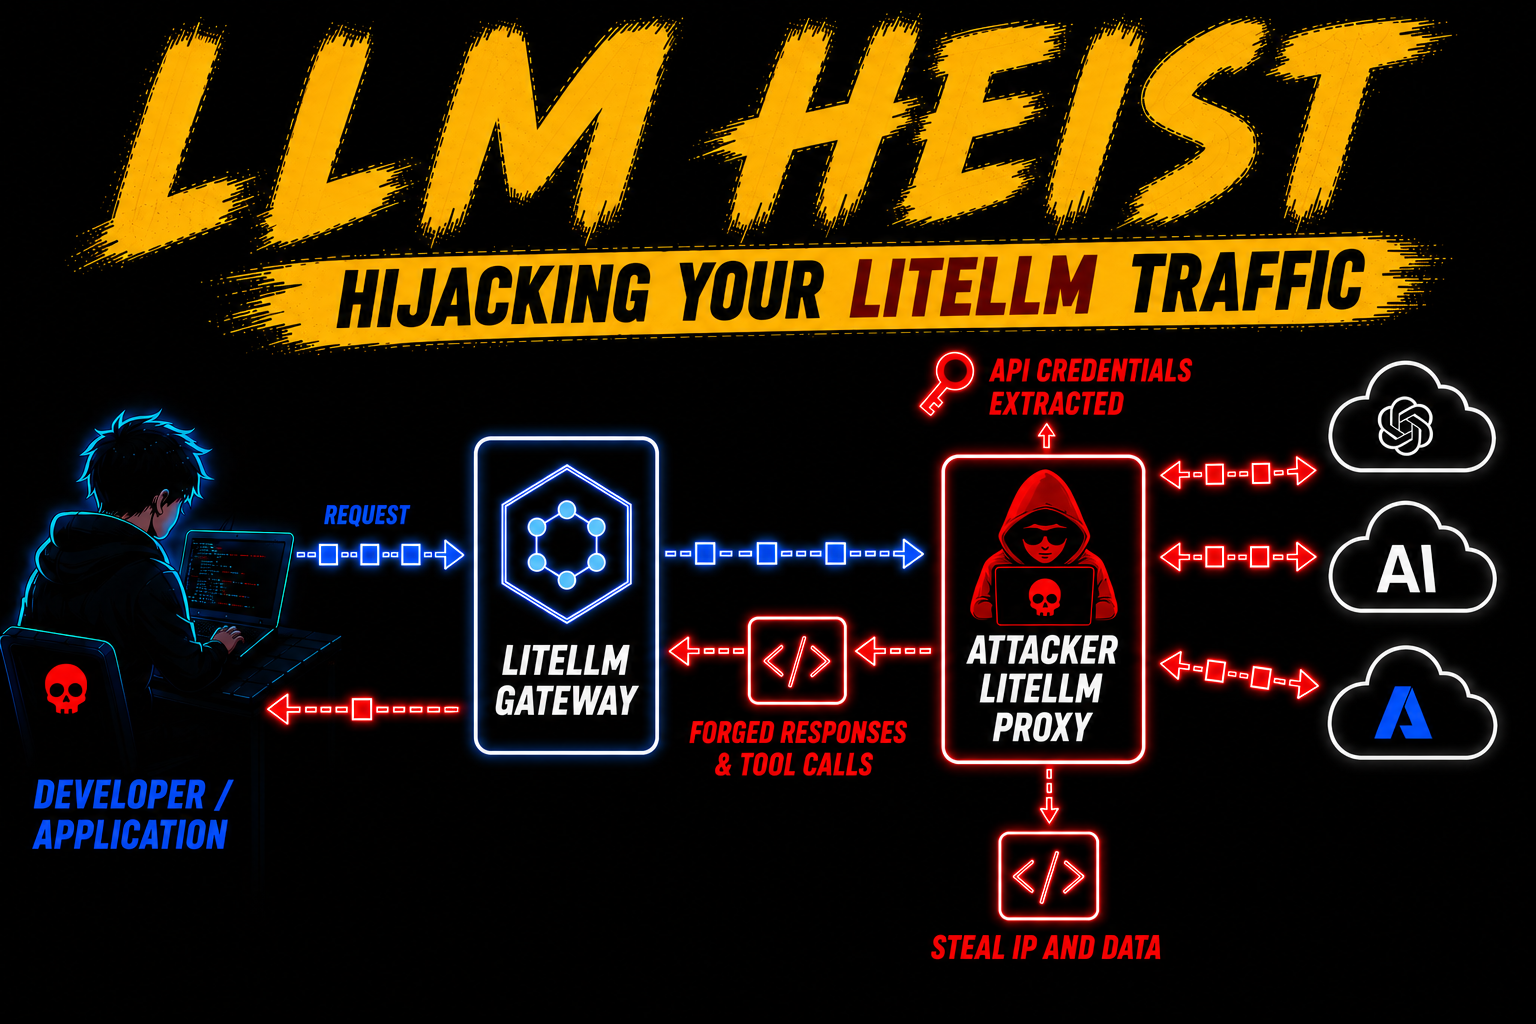
LLM Heist: Hijacking LiteLLM for Traffic Interception, Key Theft, and Tool-Call Injection
讀原文(在新分頁開啟原站)連到 Embrace The Red(Johann Rehberger)
摘要
揭露 LiteLLM 作為 AI 閘道器的潛在風險,展示攻擊者如何利用管理權限重導向流量、竊取後端 API 金鑰並注入惡意指令。讀者可學習紅隊如何模擬此類攻擊,以及藍隊應如何監控配置變更與金鑰洩漏以進行防禦。
This article details how to hijack the LiteLLM gateway to steal API keys, intercept traffic, and inject malicious tool calls into AI responses.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 攻擊者利用未修復漏洞或弱權限金鑰竊取 LiteLLM 管理權限。
- 透過重導向流量,攻擊者可竊取後端 AI 服務的金鑰與對話記錄。
- 在響應層注入惡意文字或工具呼叫,繞過提示詞防禦機制。
提到的工具與公司
- LiteLLM
- Claude Code
適合誰看
負責 AI 基礎設施安全、紅隊測試或需要強化閘道器防護的開發人員與安全專家。
摘要依據
- 講者
- Johann Rehberger
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.78
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Stealing Reasoning Traces from Proprietary LLM APIs — Ilia Shumailov & Alexander PanfilovPodcast ・ Machine Learning Street Talk ・ 49 分鐘
- 如何从专有LLM API中窃取推理痕迹 | LLM安全 | 推理痕迹 | 大语言模型 | AI安全 | 越狱攻击 | 模型蒸馏 | 推理模型 | 加密推理 | 隐私泄露 | 提示注入影片 ・ Best Partners TV ・ 16 分鐘
- Prompt Injections in the Wild - Exploiting Vulnerabilities in LLM Agents | HITCON CMT 2023影片 ・ HITCON ・ 42 分鐘
- They Found a Way to Steal Frontier LLM’s Reasoning影片 ・ bycloud ・ 16 分鐘
- Claude Pirate: Abusing Anthropic's File API For Data Exfiltration文章 ・ Embrace The Red(Johann Rehberger)
- 【生成式AI導論 2024】第14講:淺談大型語言模型相關的安全性議題 (下) — 欺騙大型語言模型影片 ・ Hung-yi Lee ・ 16 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)