1文章進階EN
Antigravity Grounded! Security Vulnerabilities in Google's Latest IDE
分析 Google 新推出的 Antigravity IDE 繼承自 Windsurf,發現其存在五項安全漏洞,包括遠端命令執行、隱藏指令、缺乏人工介入機制及資料洩漏風險。
部落格 ・ 國際 ・ 英文 ・ A 級 ・ 18 筆內容 ・ 最近更新 2026/10/01
AI agent 安全的第一手研究:對 Claude Code、Copilot 等工具的 prompt injection 與資料外洩實測,附 CVE 與修補過程
依人氣
分析 Google 新推出的 Antigravity IDE 繼承自 Windsurf,發現其存在五項安全漏洞,包括遠端命令執行、隱藏指令、缺乏人工介入機制及資料洩漏風險。
探討利用提示注入技術將 AI 代理轉化為受控命令與控制(C2)節點的攻擊方式,並透過 OpenClaw、Kimi Claw 等工具示範實作。讀者可了解如何將代理用於惡意任務、建立永續性連線,以及相關的防禦建議與風險評估。
探討 AI 代理如何極速發現並利用安全漏洞,指出當 AI 能力足夠強時,所有漏洞都會變得淺顯易見。作者分析 Anthropic 的 Mythos 模型在漏洞挖掘上的突破,並提醒組織面臨的補丁部署挑戰與攻擊者門檻降低的風險。
作者揭露利用模組遮蔽技術繞過 Claude Code Opus 5 Auto Mode 模式執行惡意程式碼,攻擊成功率達 60-80%,並指出該模式非安全保證。
分析 Microsoft SQL Copilot 在 SSMS 中的嚴重漏洞,揭示其可被用於提權與資料外洩。讀者將了解如何利用提示詞注入與系統提示缺陷,讓低權限使用者操控高權限 AI 執行危險指令。
探討 macOS Terminal 透過 ANSI 轉義碼進行 DNS 資料洩漏的漏洞,並介紹 Apple 在 macOS Tahoe 26.1 中的修復。讀者可了解如何利用 LLM 劫持終端機執行惡意指令,以及開發者如何安全編碼控制字元。
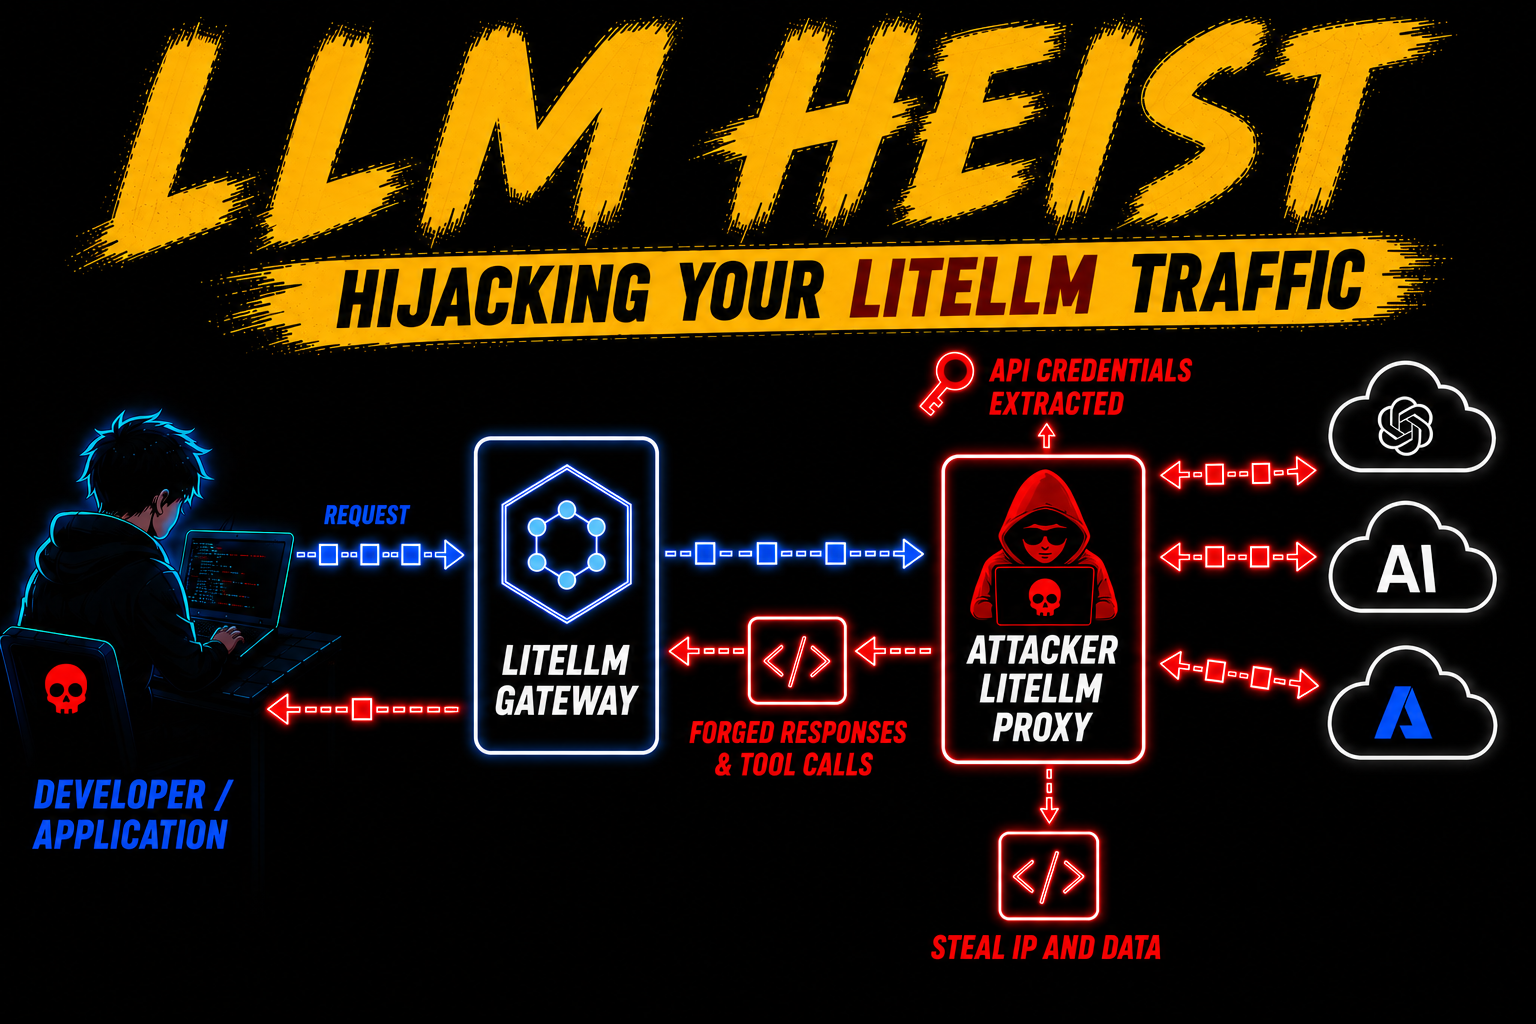
揭露 LiteLLM 作為 AI 閘道器的潛在風險,展示攻擊者如何利用管理權限重導向流量、竊取後端 API 金鑰並注入惡意指令。讀者可學習紅隊如何模擬此類攻擊,以及藍隊應如何監控配置變更與金鑰洩漏以進行防禦。
揭露 ChatGPT 生成的惡意圖片能繞過 Claude Opus 4.7 的防禦,誘導其儲存虛假記憶。雖然 Opus 4.6+ 對基礎攻擊較強,但透過謎題與社會工程學仍可能成功。讀者可了解對抗推理型 AI 的攻擊手法與防禦挑戰。
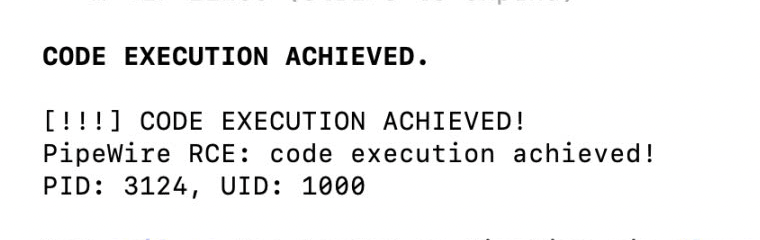
揭露利用 PipeWire 與 Flatpak 音訊權限繞過 Linux 沙箱的漏洞,講者透過 AI 工具發現並驗證此問題。文章詳細說明驗證失敗、模組載入與路徑檢查缺失的三個弱點,並提供修復建議與實作範例。
探討 AI 電腦操作代理在執行任務時,因螢幕內容在推理期間發生變化而導致的 TOCTOU 漏洞。作者實作攻擊範例,展示如何誘導 AI 點選錯誤連結傳送郵件,並提供修復建議。
依發布時間
分析 Microsoft SQL Copilot 在 SSMS 中的嚴重漏洞,揭示其可被用於提權與資料外洩。讀者將了解如何利用提示詞注入與系統提示缺陷,讓低權限使用者操控高權限 AI 執行危險指令。
作者揭露利用模組遮蔽技術繞過 Claude Code Opus 5 Auto Mode 模式執行惡意程式碼,攻擊成功率達 60-80%,並指出該模式非安全保證。
作者實作並演示如何從加密的 LLM 推理記錄中恢復敏感資訊,包括密碼與 API 金鑰。文章指出共享會話檔案可能洩漏大量資料,並提供具體的攻擊工具與步驟。
揭露 LiteLLM 作為 AI 閘道器的潛在風險,展示攻擊者如何利用管理權限重導向流量、竊取後端 API 金鑰並注入惡意指令。讀者可學習紅隊如何模擬此類攻擊,以及藍隊應如何監控配置變更與金鑰洩漏以進行防禦。
揭露利用 PipeWire 與 Flatpak 音訊權限繞過 Linux 沙箱的漏洞,講者透過 AI 工具發現並驗證此問題。文章詳細說明驗證失敗、模組載入與路徑檢查缺失的三個弱點,並提供修復建議與實作範例。
分析 Hugging Face 遭自主 AI 代理系統入侵事件,指出商業 API 安全防護可能阻礙調查,建議預先準備本地開源模型作為應變方案。讀者可了解自主攻擊的運作模式與防禦對稱性缺失的挑戰。
探討 macOS Terminal 透過 ANSI 轉義碼進行 DNS 資料洩漏的漏洞,並介紹 Apple 在 macOS Tahoe 26.1 中的修復。讀者可了解如何利用 LLM 劫持終端機執行惡意指令,以及開發者如何安全編碼控制字元。
探討 AI 電腦操作代理在執行任務時,因螢幕內容在推理期間發生變化而導致的 TOCTOU 漏洞。作者實作攻擊範例,展示如何誘導 AI 點選錯誤連結傳送郵件,並提供修復建議。
詳細拆解 Microsoft Copilot 系列軟體中的多個安全漏洞,包括透過 HTML 預覽與字型載入進行資料洩漏、利用延遲工具呼叫與長期記憶功能建立持久後門。讀者可了解如何繞過內容安全策略(CSP)以及這些漏洞的修復狀況。
揭露 ChatGPT 生成的惡意圖片能繞過 Claude Opus 4.7 的防禦,誘導其儲存虛假記憶。雖然 Opus 4.6+ 對基礎攻擊較強,但透過謎題與社會工程學仍可能成功。讀者可了解對抗推理型 AI 的攻擊手法與防禦挑戰。
探討 AI 代理如何極速發現並利用安全漏洞,指出當 AI 能力足夠強時,所有漏洞都會變得淺顯易見。作者分析 Anthropic 的 Mythos 模型在漏洞挖掘上的突破,並提醒組織面臨的補丁部署挑戰與攻擊者門檻降低的風險。
探討利用提示注入技術將 AI 代理轉化為受控命令與控制(C2)節點的攻擊方式,並透過 OpenClaw、Kimi Claw 等工具示範實作。讀者可了解如何將代理用於惡意任務、建立永續性連線,以及相關的防禦建議與風險評估。
揭露 AI Agent 技能(Skills)中隱藏的 Unicode 指令注入漏洞,展示如何透過無形程式碼點後門惡意技能,並提供掃描工具與防禦建議。讀者可學習識別與檢測此類攻擊,提升 Agent 環境安全性。
OpenAI 發表新論文說明如何防止基於 URL 的資料洩漏,並詳細列出新增的防護機制與潛在繞過方法。文章回顧了過去三年的漏洞報告歷程,分析當前技術限制與未來風險,適合關注 AI 安全與系統設計的讀者。
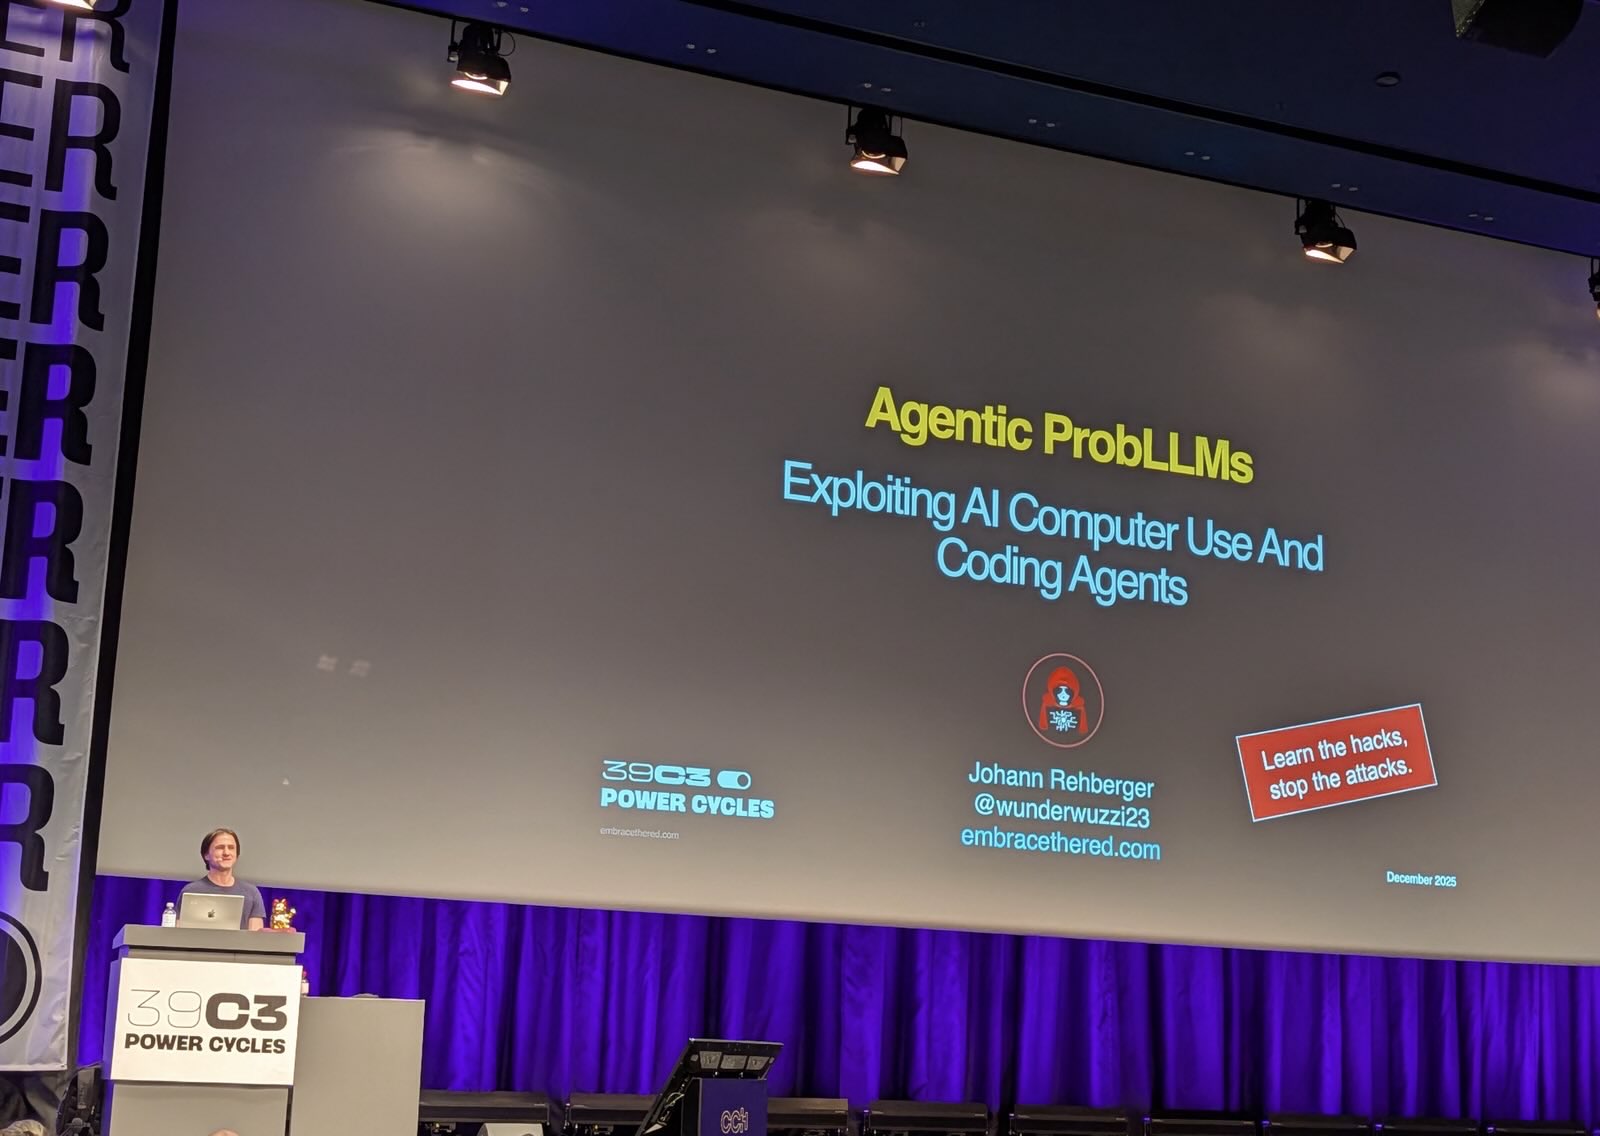
這篇內容介紹了 Johann Rehberger 在 39C3 研討會上的演講,探討自動代理系統(Agentic Systems)的漏洞。透過實作演示,展示如何利用 AI 電腦使用與編碼代理來發現安全缺陷,並分享相關研究成果。
探討 AI 產業如何像挑戰者號災難一樣,逐漸將安全警告視為無足輕重,導致過度信任大型語言模型輸出。作者指出,在代理系統中,若忽略提示注入等風險,組織會因短期成功而降低防護,最終引發嚴重安全事件。
分析 Google 新推出的 Antigravity IDE 繼承自 Windsurf,發現其存在五項安全漏洞,包括遠端命令執行、隱藏指令、缺乏人工介入機制及資料洩漏風險。
揭露利用 Claude Code Interpreter 的網路請求功能,透過惡意提示注入與偽造 API 金鑰,將使用者檔案上傳至攻擊者帳戶的資料洩漏攻擊鏈。