讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
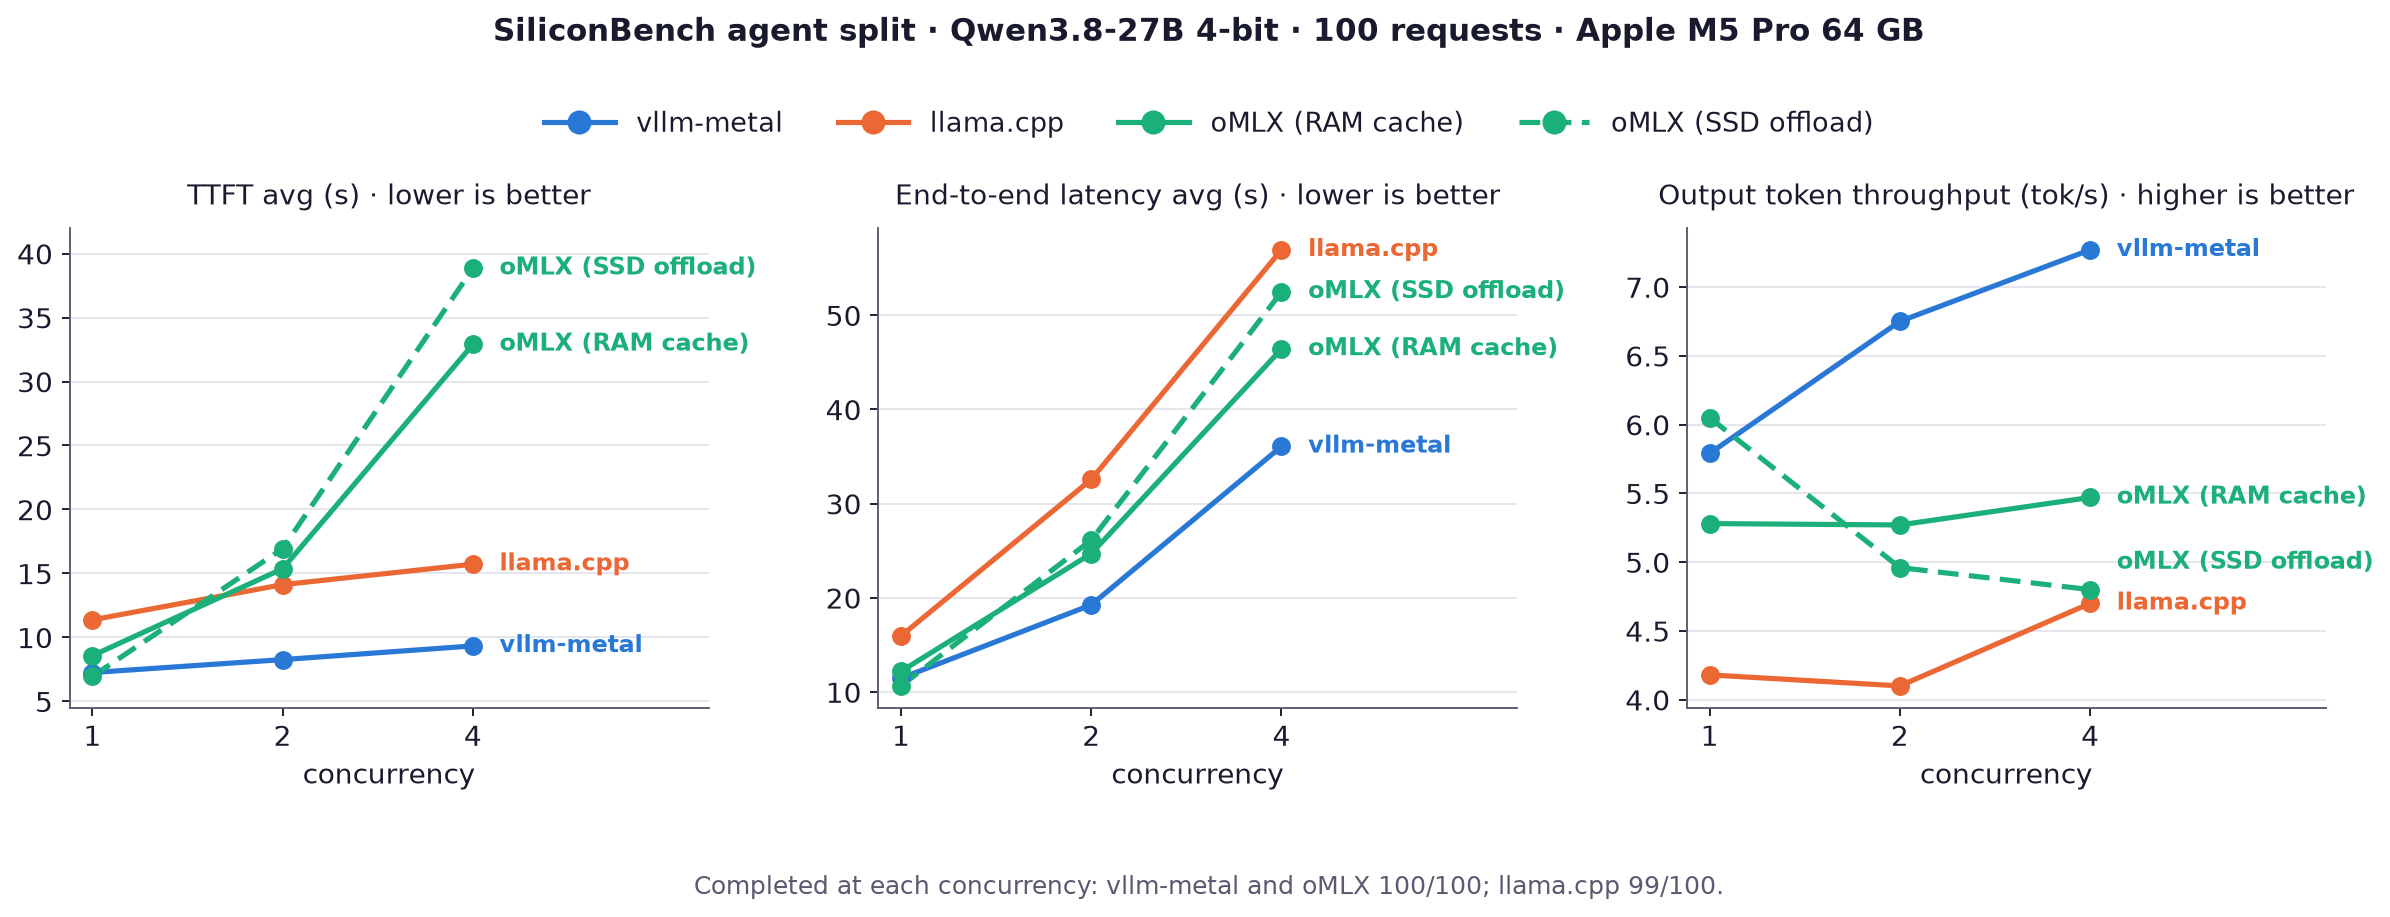
vLLM 官方宣佈推出 vllm-metal,將 vLLM 的並行服務架構移植到 Apple Silicon,支援 M5 晶片加速預填與批次多 token 預測。此工具能降低高併發下的首字延遲並最佳化記憶體管理,適合在 Mac 上進行本地大模型推理開發。
vLLM announces vllm-metal, porting its concurrent serving stack to Apple Silicon with M5 acceleration and batched multi-token prediction for optimized local inference on Macs.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- vllm-metal 將 vLLM 的並行服務架構移植到 Apple Silicon。
- 支援 M5 晶片自動加速預填與批次多 token 預測功能。
- 在高併發與多代理場景下顯著降低首字延遲與總延遲。
提到的工具與公司
- vLLM
- MLX
- Homebrew
- Qwen3.6-35B-A3B
- Gemma 4 E4B
- SiliconBench
適合誰看
在 Mac 上開發或部署本地大型語言模型、需要高效能推理服務的工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.94
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Distributing LLM inference in DwarfStar文章 ・ antirez(部落格)
- My M5 Max, Gemma 4, MLX LOCAL Stack. (This KILLS MODEL PROVIDERS)影片 ・ IndyDevDan ・ 39 分鐘
- Optimizing vLLM on Arm CPUs文章 ・ vLLM Blog
- Announcing Day-0 Support for NVIDIA Nemotron 3.5 Lightning on vLLM文章 ・ vLLM Blog
- Transformers now runs llama.cpp quants文章 ・ Hugging Face Blog
- Intel Arc Pro B70 (32GB) for Local LLMs: llama.cpp (SYCL/Vulkan), vLLM (Intel LLM Scaler) Benchmarks影片 ・ Donato Capitella
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)