I'm Obsessed With Local AI. Here's Why(在新分頁開啟原站)
Greg Isenberg 解釋本地 AI 的架構,涵蓋模型、儲存、軟體與工作流四要素,並詳述 Google Gemma 系列、LM Studio 與 Ollama 等工具,提供三種實作路徑與三個可複製的本地 AI 創業想法。
39.2 萬次觀看
※ 摘要僅根據標題與說明
Running Models Locally ・ 44 筆內容
在自己的電腦或伺服器上跑開源模型。
也叫做:本機模型、本地模型、本地部署、本地大模型、local LLM、local LLMs、local model、Ollama、llama.cpp、LM Studio、MLX
由淺入深:入門 → 進階 → 高階
Model provider | AI Coding Dictionary
AI Hero(Matt Pocock)● 有原文
一个人、两周、数百美元,如何训出登顶 Hugging Face 的模型 | 对谈研究员逯雨鑫
42章经47 分鐘● 有原文
AINews(Latent Space/smol.ai)● 有原文
I'm Obsessed With Local AI. Here's Why(在新分頁開啟原站)
Greg Isenberg39 分鐘○ 無原文
Sebastian Raschka(部落格)● 有原文
Welcome to Open Source AI: Run Your Own Models Locally(在新分頁開啟原站)
Hugging Face1 小時 10 分○ 無原文
Ep 92: xAI Co-Founder Unpacks the Future of Model Development(在新分頁開啟原站)
Unsupervised Learning1 小時 4 分○ 無原文
Inside the Model Factory — Eiso Kant, Poolside AI(在新分頁開啟原站)
Latent Space1 小時 55 分○ 無原文
依相關、人氣、新鮮度綜合排序;站長推薦的加成
Greg Isenberg 解釋本地 AI 的架構,涵蓋模型、儲存、軟體與工作流四要素,並詳述 Google Gemma 系列、LM Studio 與 Ollama 等工具,提供三種實作路徑與三個可複製的本地 AI 創業想法。
※ 摘要僅根據標題與說明
本文解釋了 AI 開發中「模型提供者」的概念,即負責模型推理的遠端服務或本地工具。使用者需透過這些提供者獲取預判結果,並需了解其限額、價格與可用性。
※ 摘要僅根據標題與說明
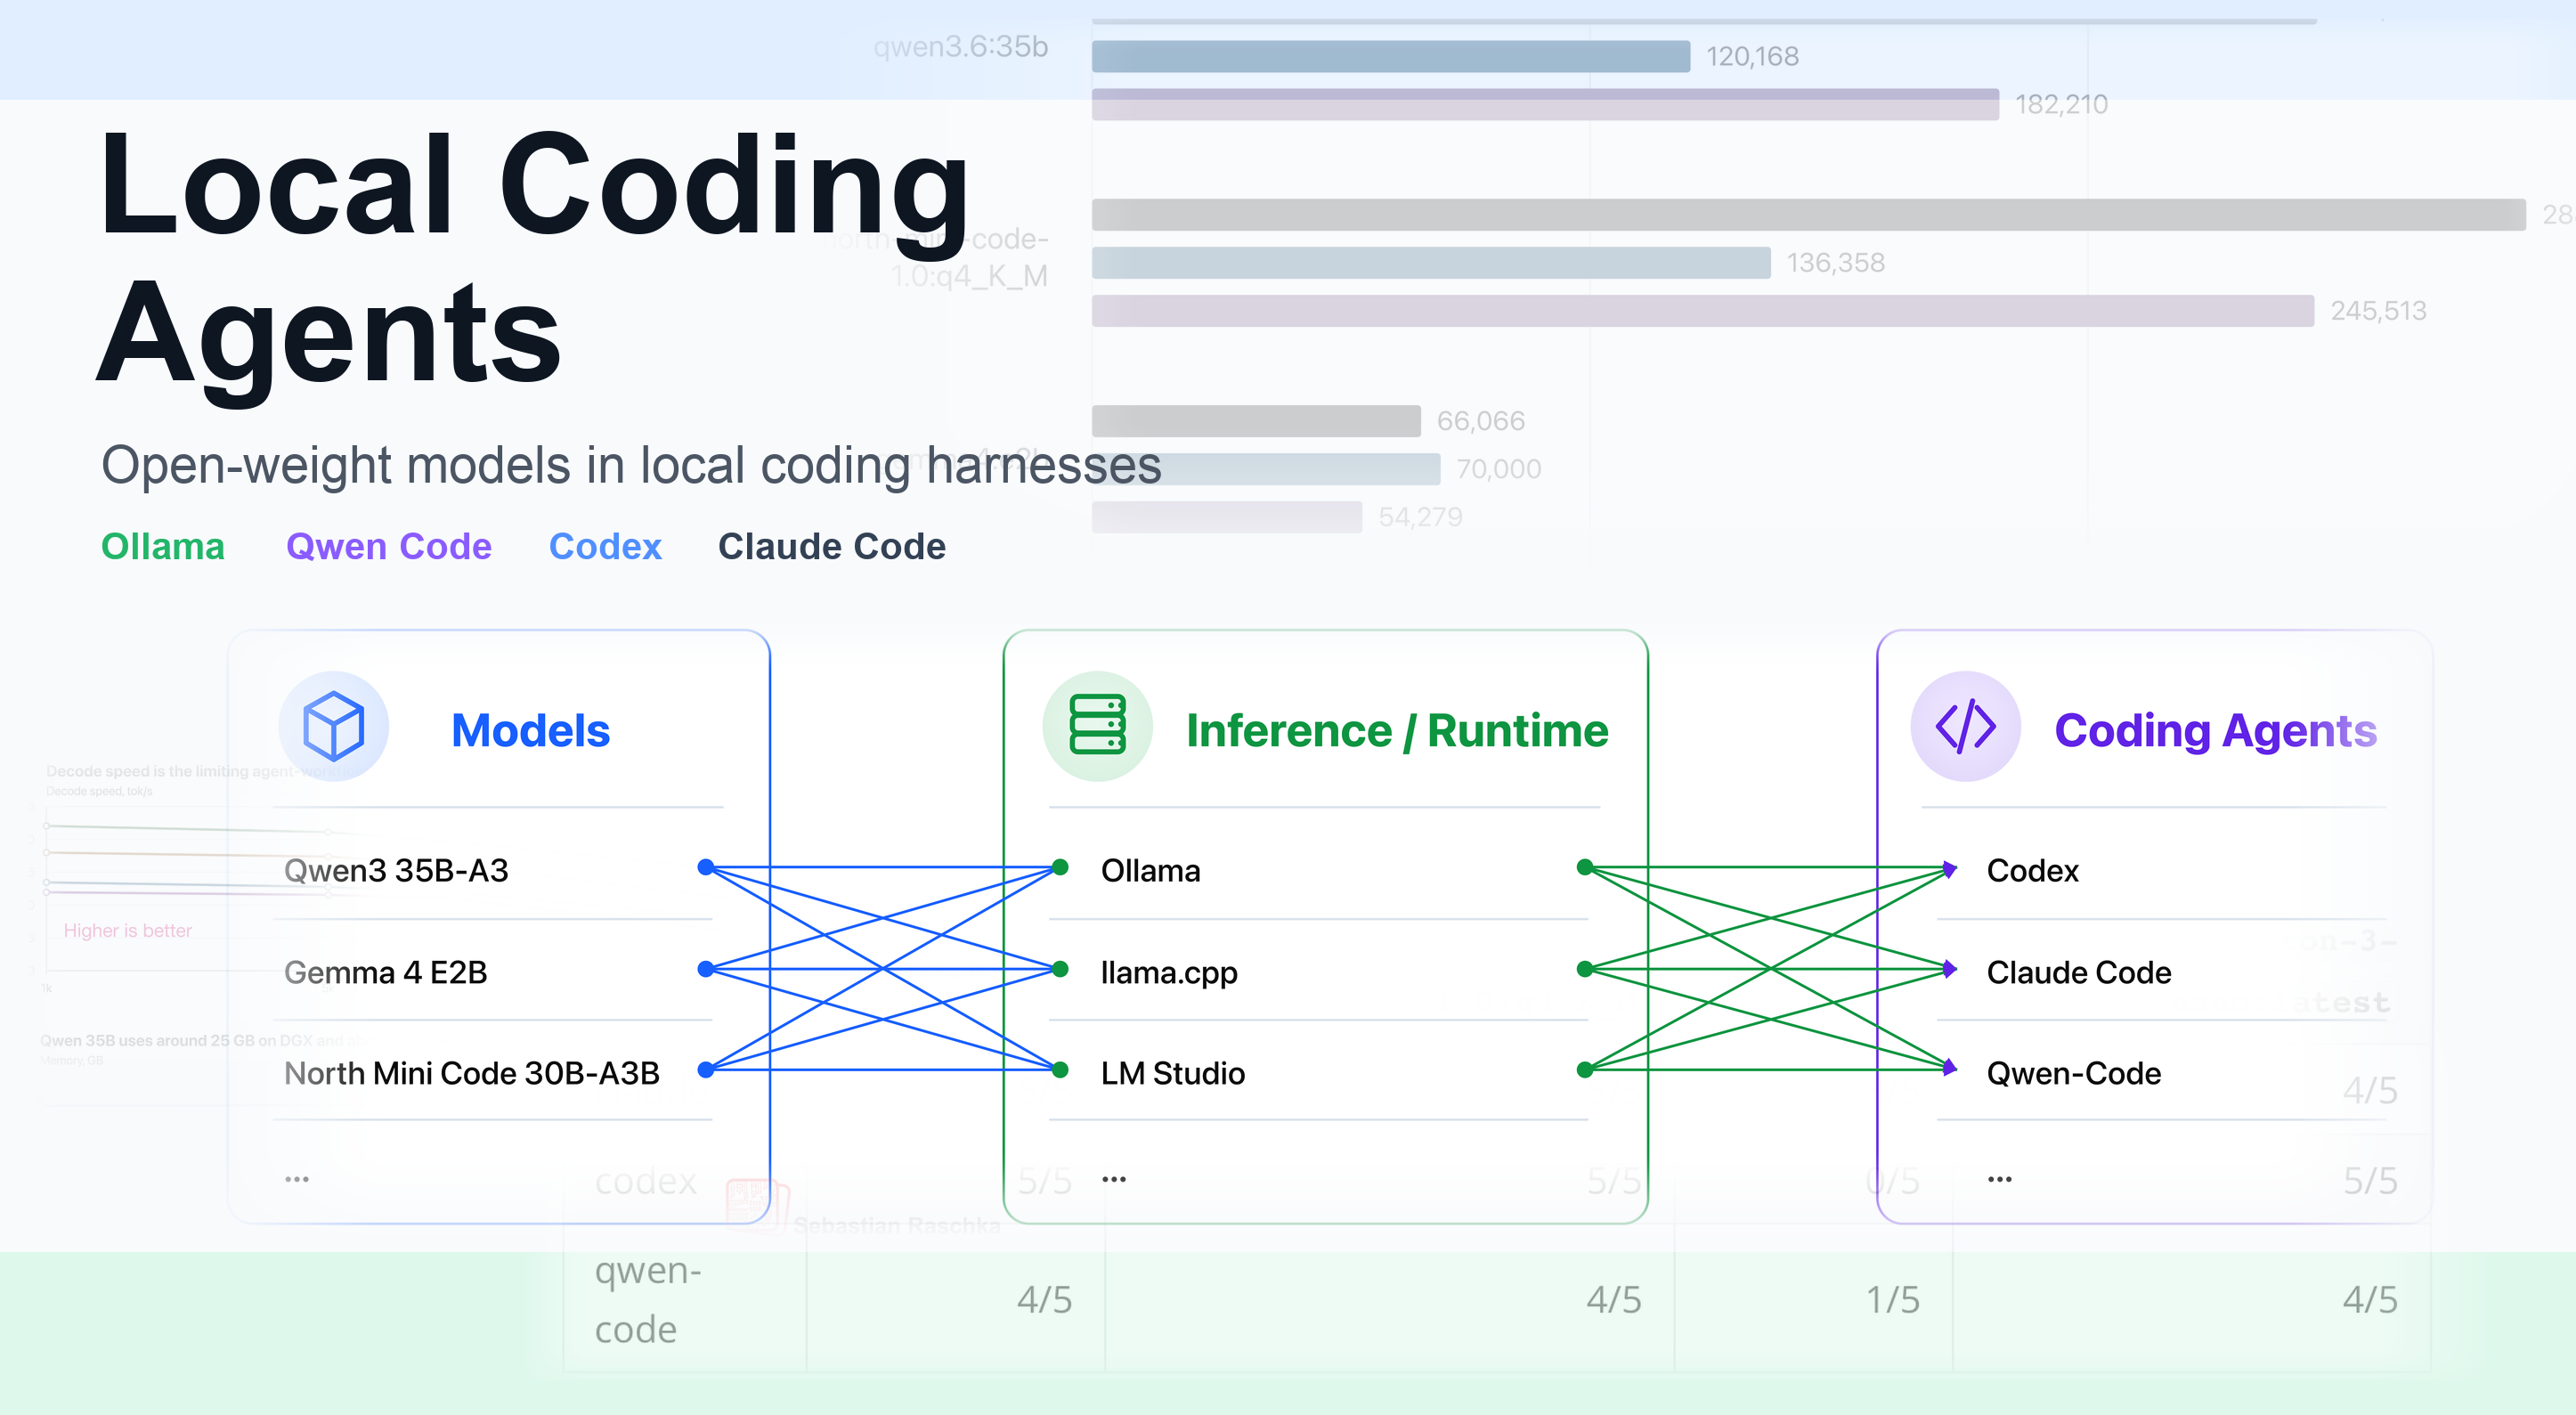
介紹如何透過本地推理伺服器執行開源權重大語言模型,並搭配本地編寫代理工具(如 Qwen-Code)來替代雲端服務。文章詳述了從安裝 Ollama 到配置隱私設定(禁用追蹤)的完整流程,並探討了透過 SSH 隧道將本地模型部署至遠端硬體(如…
介紹如何將 AI 模型從雲端運算移至本地裝置,讓使用者能自主執行並掌控自己的 AI 模型。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
教導讀者如何透過 llama.cpp 在 Pi 裝置上執行本地模型,實現完全私密且零成本的本地化 AI 體驗。
※ 摘要僅根據標題與說明
介紹如何在家使用 Mac Studio 與 GPU 執行本地 AI 模型,內容涵蓋基礎設定與實際操作步驟。
※ 摘要僅根據標題與說明
介紹使用 M5 Max 與 Gemma 4 的本地部署方案,強調其效能足以取代傳統雲端服務。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
探討 AI 如何透過區域性推理最佳化模型,並指出最接近的模型將改變此過程。
※ 摘要僅根據標題與說明
逯雨鑫以非 AI Lab 背景,僅用 2 周與數百美元成本,透過自學基礎、合成資料與 SFT 技術,成功在 Hugging Face 頂部模型榜上取得突破。
介紹了 Hugging Face 的 Transformers 現在支援從預訓練檔直接執行 llama.cpp 的量化模型。透過重新利用 ggml 的金屬核,使用者可以在 Mac 上輕鬆執行 Qwen3.5 等模型。
OpenAI 暫停前沿 RL 訓練以強化安全與對齊,並加強監控與隔離措施。Qwen3.8-27B 成為本地可執行的熱門模型,GLM-5.3 透過後訓練提升取得顯著效能。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
介紹如何運用 DeepSeek R1 與 AnythingLLM 建立本地化知識庫,幫助使用者將資料存入本地並進行高效管理。
※ 摘要僅根據標題與說明
依發布時間
探討 AI 如何透過區域性推理最佳化模型,並指出最接近的模型將改變此過程。
※ 摘要僅根據標題與說明
LFM2.5-VL-DSpark 是一款專為加速視覺語言模型推理設計的擴充模型,僅增加 8.9% 引數即可提升 2.6 倍至 3.1 倍的推理速度。該模型支援 Llama.cpp、MLX-VLM 及 SGLang 等工具,並提供即時支援。
本文解釋了 AI 開發中「模型提供者」的概念,即負責模型推理的遠端服務或本地工具。使用者需透過這些提供者獲取預判結果,並需了解其限額、價格與可用性。
本課程由 Qdrant 與 Dylan Couzon 合作製作,教導讀者如何在本地裝置上儲存、搜尋與遺忘 AI 記憶。透過建立本地記憶系統,使用者可實現無感知的離線 AI 助手,並能即時識別新物件而無需重新訓練模型。
※ 摘要僅根據標題與說明
介紹了 Hugging Face 的 Transformers 現在支援從預訓練檔直接執行 llama.cpp 的量化模型。透過重新利用 ggml 的金屬核,使用者可以在 Mac 上輕鬆執行 Qwen3.5 等模型。
oMLX 創作者兼維護者 Jun Kim 加入 Hugging Face,將致力於支援 MLX 社群。oMLX 是 Apple 本地 AI 框架,目前由 Hugging Face 作為模型庫與貢獻者平台。
示範如何透過 API 原始 Jev 與 Semif 兩種方式,建構一個模型路由器。內容涵蓋本地與雲端模型的使用、AutoJev 執行方式,以及透過 SemIf 進行架構設計與效能統計。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
Greg Isenberg 解釋本地 AI 的架構,涵蓋模型、儲存、軟體與工作流四要素,並詳述 Google Gemma 系列、LM Studio 與 Ollama 等工具,提供三種實作路徑與三個可複製的本地 AI 創業想法。
※ 摘要僅根據標題與說明
教導讀者如何透過 llama.cpp 在 Pi 裝置上執行本地模型,實現完全私密且零成本的本地化 AI 體驗。
※ 摘要僅根據標題與說明
介紹五款免費且開源的 AI 工具,可協助使用者大幅降低 Token 成本。內容涵蓋 Ollama、9router、Headroom、Diffy 與 OpenHands 等實用軟體。
※ 摘要僅根據標題與說明
專訪 Ollama 執行長 Jeffrey Morgan,探討開源 AI 如何從省成本轉向企業掌控權。內容涵蓋程式設計代理如何推高 Token 使用量、本地與雲端模型的混合策略,以及 Ollama 從創業到產品爆發的歷程。
※ 摘要僅根據標題與說明