讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
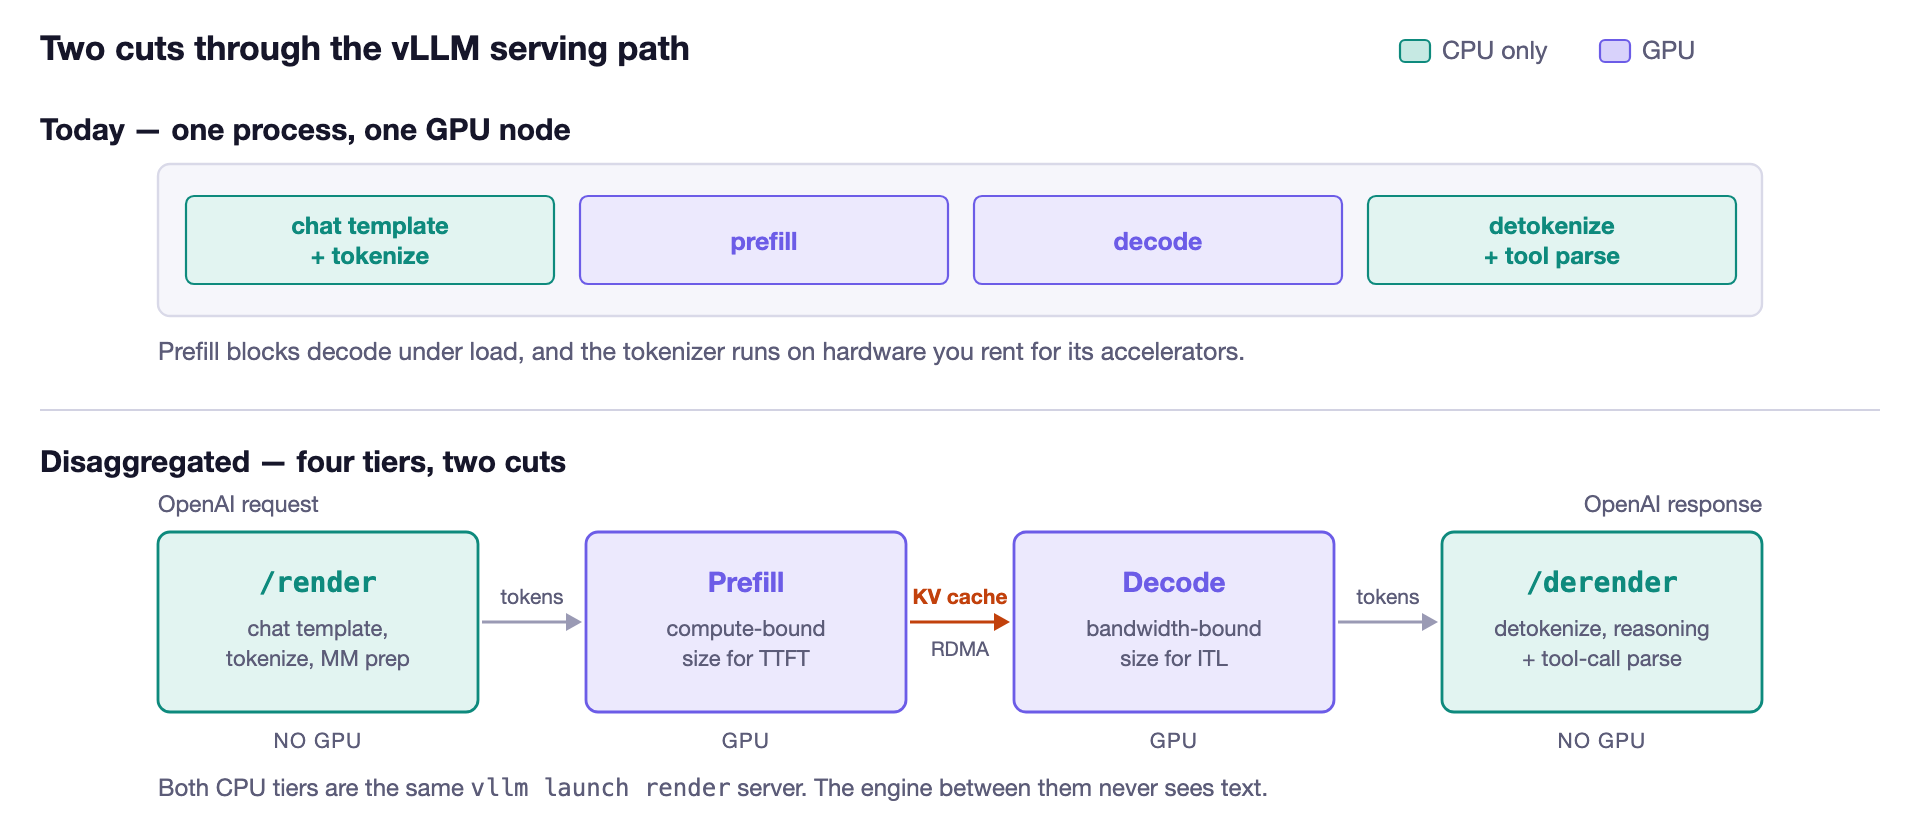
詳細介紹如何在 vLLM 中實作解耦式服務,將提示處理(prefill)與生成(decode)分開,並將前端處理移至 CPU。透過分離這些階段,可以有效降低長提示造成的延遲,提升系統在生產環境下的有效吞吐量與延遲表現。
This article explains how to implement disaggregated serving in vLLM by separating prefill and decode stages and moving frontend tasks to CPU nodes to improve latency and throughput.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 將提示處理與生成階段分離,可避免長提示阻塞其他請求。
- 將前端處理移至 CPU 節點,釋放 GPU 資源專注於推理。
- 透過快速 KV 快取傳輸(如 RDMA)可顯著提升整體延遲表現。
提到的工具與公司
- vLLM
- NIXL
- Dynamo
- Mooncake
- LMCache
- MoRI-IO
- TileRT
適合誰看
負責部署或最佳化大型語言模型推理服務、需要處理長提示詞或高併發場景的開發人員與系統工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.96
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- [LLM Architect] 09 深入理解和对比 prefill与decode | kv-cache | 并行-串行 | GEMM-GEMV | 算力-带宽影片 ・ 五道口纳什 ・ 34 分鐘
- vLLM x AgentX: Optimizing for Real-World Agentic Serving文章 ・ vLLM Blog
- Exploring Speculative Decoding in vLLM on AMD GPUs文章 ・ vLLM Blog
- Jongryool Kim - Disaggregated LLM Serving with Shared Memory KV Cache at Rack Scale影片 ・ Berkeley RDI ・ 5 分鐘
- 理解 KV Cache 与 Prompt Caching:LLM 推理加速的核心机制文章 ・ chaofa用代码打点酱油(袁朝发)
- How AI Models Scale Beyond a Single GPU Across LLM Workloads影片 ・ IBM Technology ・ 9 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)