讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
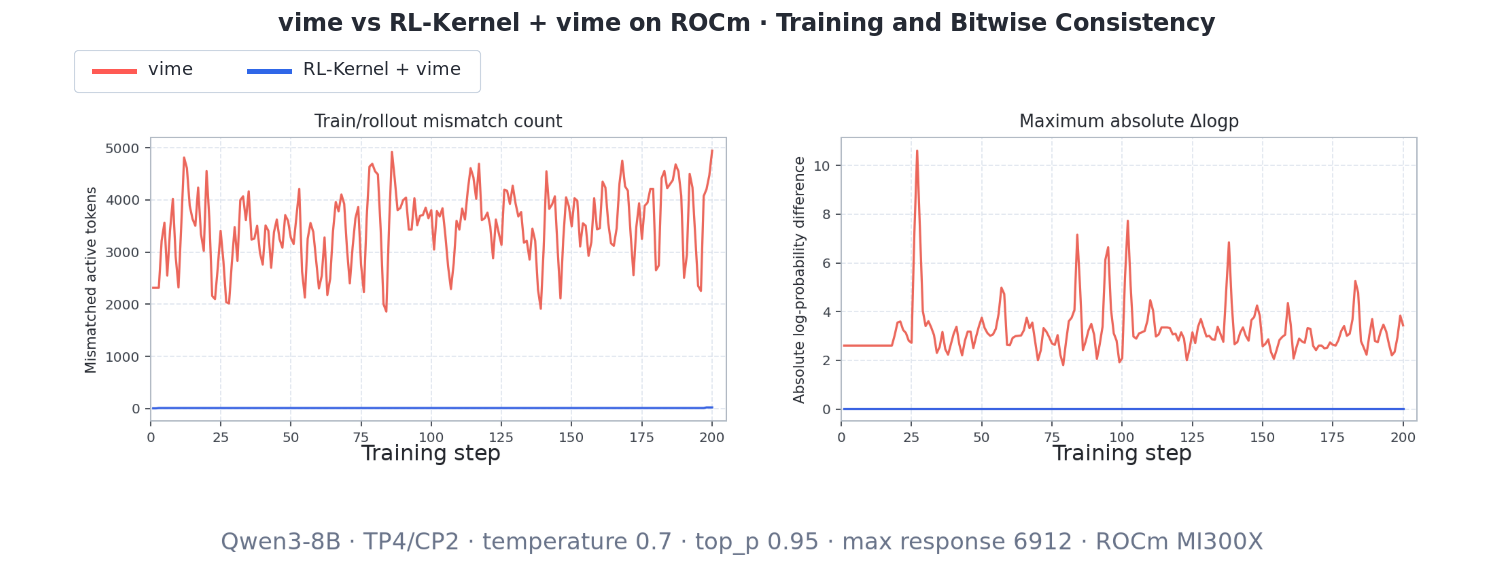
介紹如何在 AMD Instinct MI300X 上實現 Megatron 訓練與 vLLM 推論的位元級一致性。透過 vime 與 RL-Kernel 解決因浮點運算差異導致的對齊問題,驗證了 200 個步驟內無誤差。讀者可了解大模型 RL 訓練中數值一致性的挑戰與解決方案。
This article explains how to achieve bitwise consistency between Megatron training and vLLM rollout on AMD ROCm using vime and RL-Kernel.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- vime 與 RL-Kernel 在 AMD ROCm 上實現訓練與推論的位元級一致。
- 驗證 Qwen3-8B 模型在 200 個步驟中對齊無誤差。
- 解決了不同執行引擎導致浮點數對齊困難的問題。
提到的工具與公司
- Megatron-LM
- vLLM
- AMD Instinct MI300X
- ROCm
- Qwen3-8B
- GRPO
適合誰看
從事大模型訓練、RL 後訓練或 AMD GPU 開發的工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.91
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- IsoExec: Unified Execution to Eliminate Trainer-Inference Mismatch in SkyRL文章 ・ vLLM Blog
- Exploring Speculative Decoding in vLLM on AMD GPUs文章 ・ vLLM Blog
- Tuning GPU Performance with AI Agents | AMD’s Anush Elangovan on ROCm 10Podcast ・ Chain of Thought ・ 53 分鐘
- Haters think AI agents can't write GPU code? This'll ROCmPodcast ・ The Stack Overflow Podcast ・ 27 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)