讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
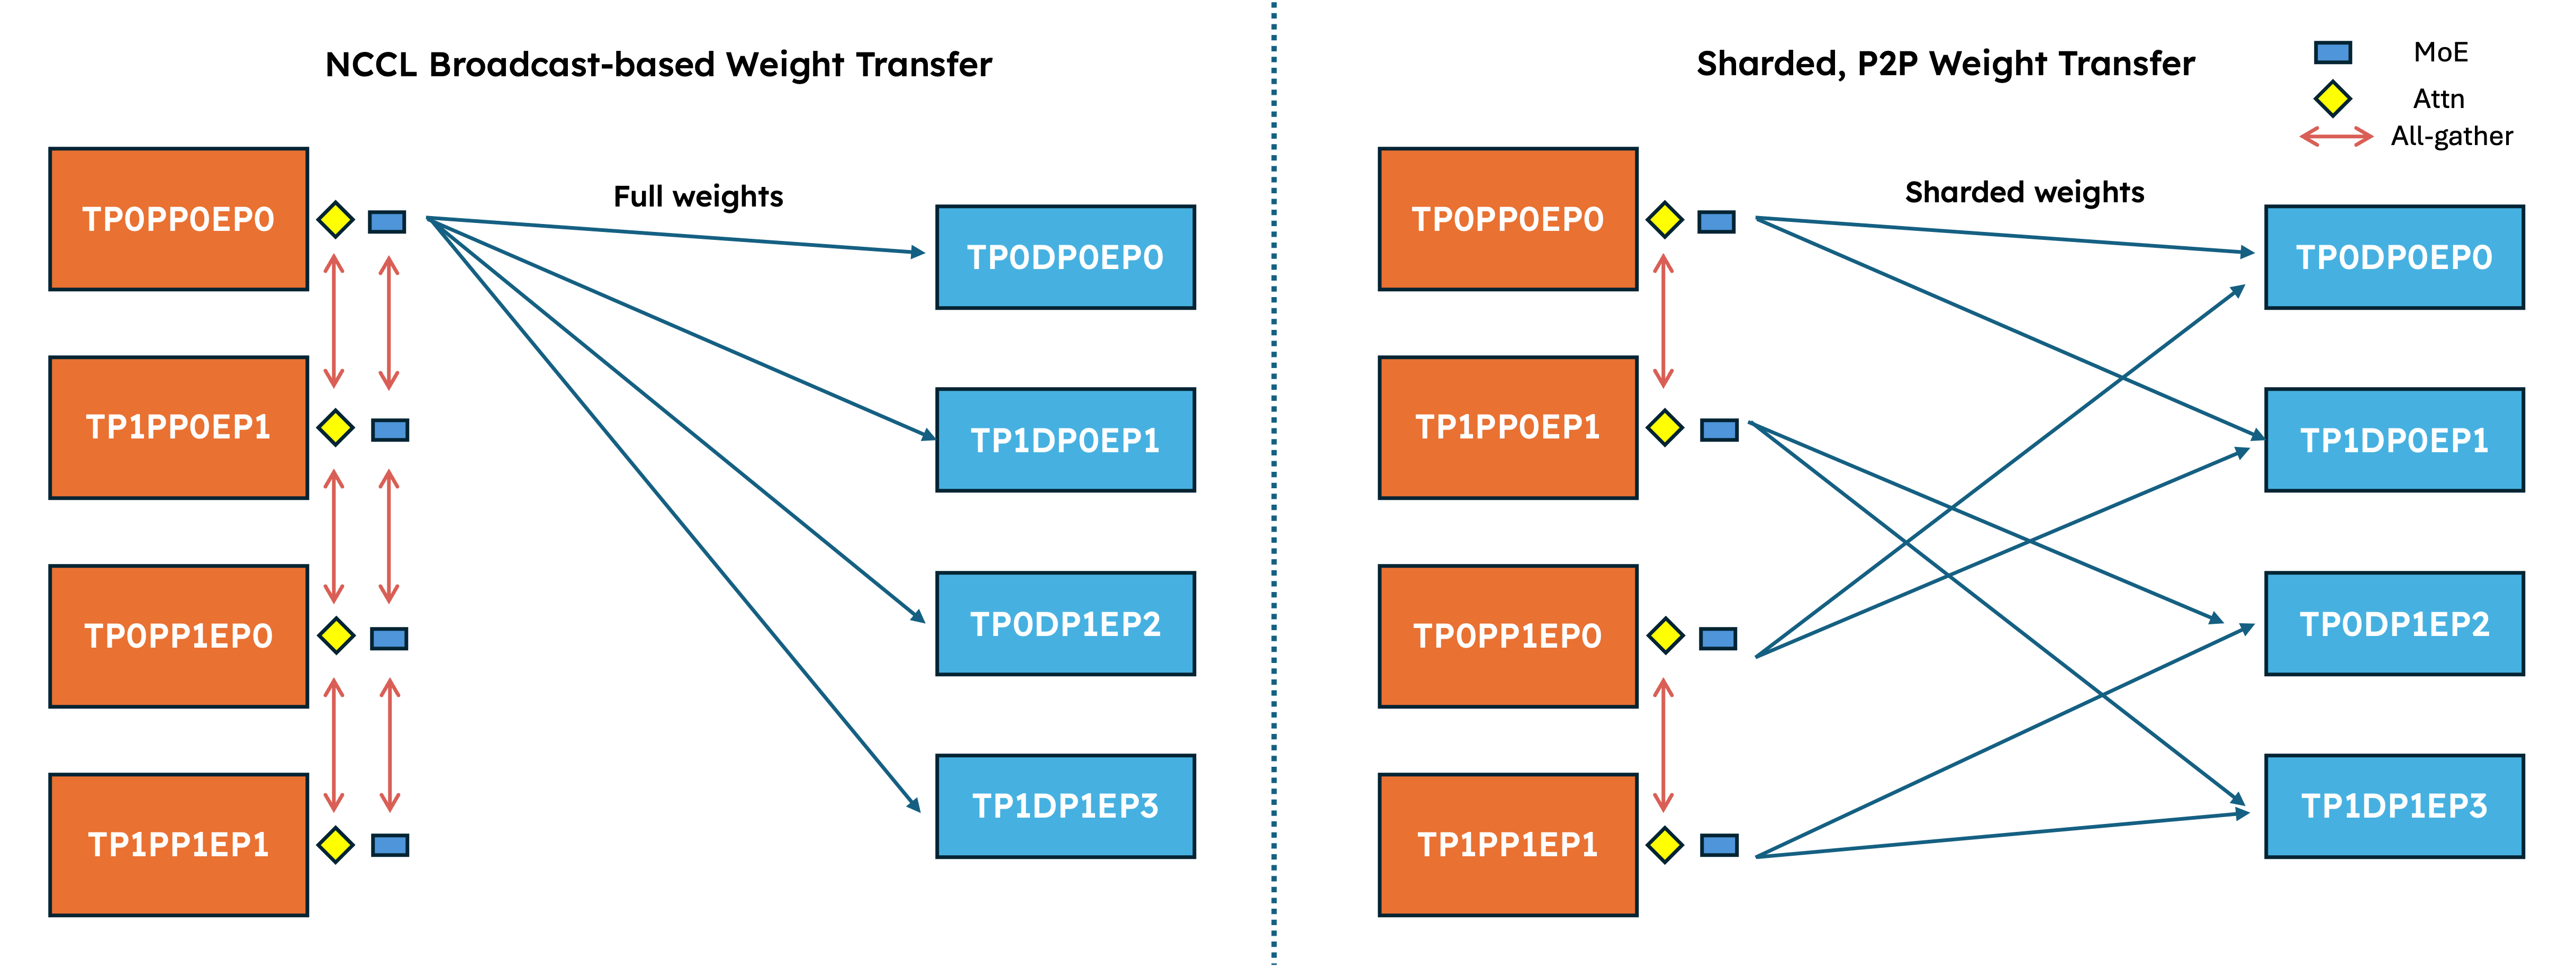
vLLM 團隊介紹如何利用 Ray Direct Transport (RDT) 與 NIXL 實現大規模分塊權重傳輸,解決大模型訓練中權重同步慢與記憶體消耗高的問題。文章詳述了從簡單迭代器到管道化執行的最佳化過程,並展示在 Kimi K2 模型上於 48 節點叢集中僅用 7.53 秒完成傳輸的實測結果。
vLLM details a native sharded weight transfer engine using Ray Direct Transport to achieve ultra-fast model weight syncing for large-scale training and inference workloads.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 利用 Ray Direct Transport (RDT) 實現 GPU 間直接傳輸,避免資料複製。
- 透過分塊傳輸與管道化執行,將權重同步時間大幅縮短。
- 支援多模型架構與 RL 框架,並具備故障容錯能力。
提到的工具與公司
- vLLM
- Ray
- NIXL
- SkyRL
- Kimi K2
- Qwen3-235B-A22B
- NCCL
適合誰看
正在開發或最佳化大規模語言模型訓練與推理系統、需要處理大模型權重同步的機器學習工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.83
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Distributed Layerwise Offload: Scaling Toward 200B+ DiT Models Efficiently in vLLM-Omni文章 ・ vLLM Blog
- Kimi K3 Is Here: Efficient Day-0 Support on vLLM文章 ・ vLLM Blog
- How is hardware reshaping LLM design?影片 ・ Julia Turc
- Jongryool Kim - Disaggregated LLM Serving with Shared Memory KV Cache at Rack Scale影片 ・ Berkeley RDI ・ 5 分鐘
- How AI Models Scale Beyond a Single GPU Across LLM Workloads影片 ・ IBM Technology ・ 9 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)