讀原文(在新分頁開啟原站)連到 Ethan Mollick(部落格)
摘要
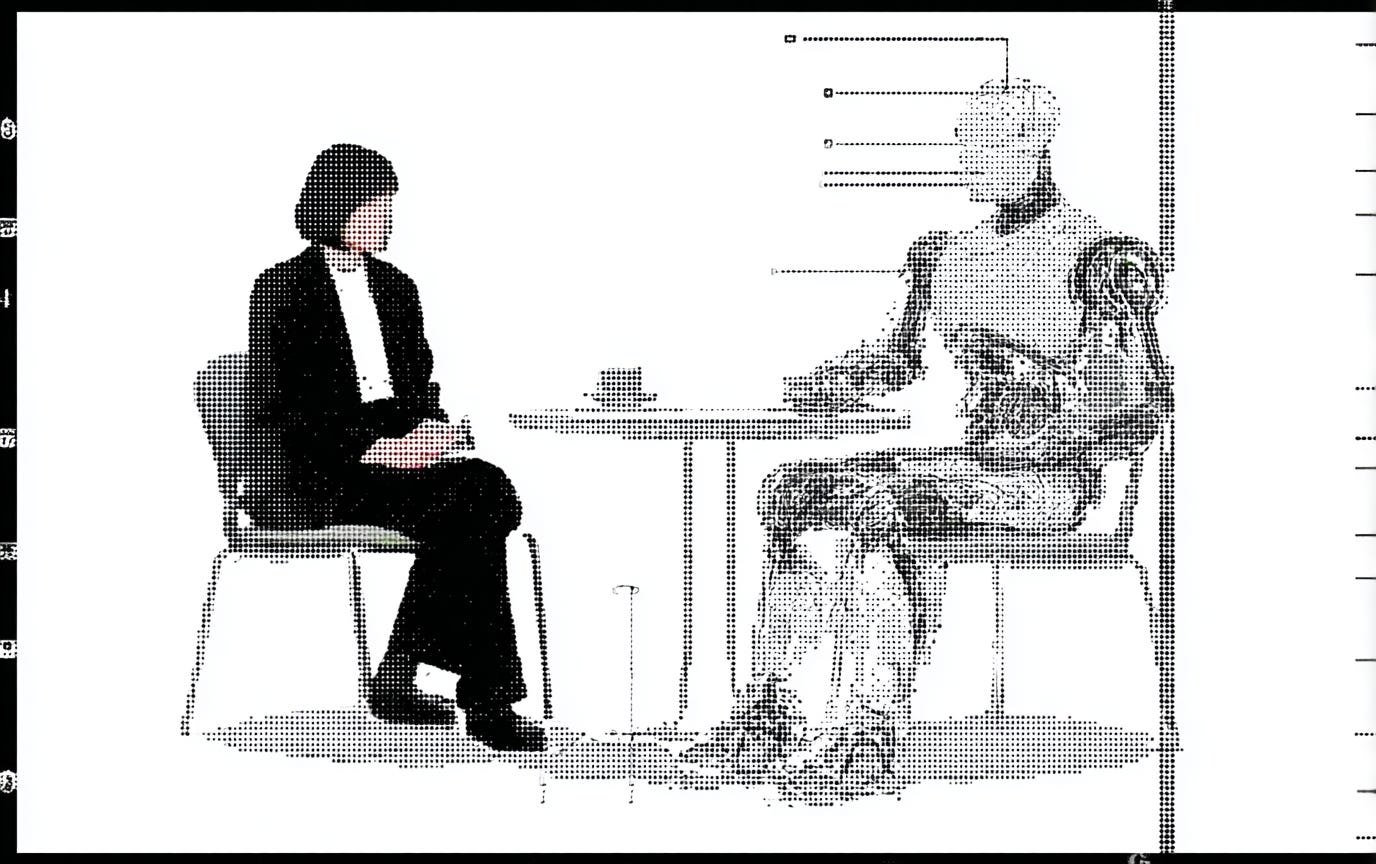
探討如何評估 AI 的真實能力,指出傳統基於測試的基準測試存在誤導風險,建議透過「模擬面試」的方式,讓 AI 回答具體問題來觀察其思維模式與判斷力。
This article discusses how to evaluate AI's true capabilities, pointing out the pitfalls of traditional benchmarking and suggesting a 'mock interview' approach to observe AI reasoning and judgment.
重點
- 傳統基準測試常因題目設計缺陷或無法衡量特定能力而失效。
- 建議透過「模擬面試」,讓 AI 回答具體問題以觀察其思維模式與判斷力。
- 不同模型對同一個模糊問題的建議可能差異巨大,需系統性測試。
適合誰看
AI 使用者、企業決策者、科技業人士。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.29
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Really Big Test-Time Compute in AI Changes Benchmarks, Safety and Research with OpenAI Research Scientist Noam BrownPodcast ・ No Priors ・ 36 分鐘(在新分頁開啟原站)
- AI incidents, audits, and the limits of benchmarksPodcast ・ Practical AI ・ 43 分鐘
- Reality: The Final Eval — Lukas Petersson and Axel Backlund of Andon LabsPodcast ・ Latent Space ・ 1 小時 16 分(在新分頁開啟原站)
- Simon Obstbaum & Rob Willoughby - Why evals are hard and how we're solving it - AI Native DevCon Jun影片 ・ AI Native Dev ・ 37 分鐘(在新分頁開啟原站)
- How to Interview and Hire ML/AI Engineers文章 ・ Eugene Yan(部落格)
- 【生成式人工智慧與機器學習導論2025】第 4 講:評估生成式人工智慧能力時可能遇到的各種坑影片 ・ Hung-yi Lee ・ 2 小時 1 分(在新分頁開啟原站)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)