A Field Guide to Rapidly Improving AI Products(在新分頁開啟原站)
指出許多 AI 團隊過度關注工具而忽視實際效果。作者分享了一套基於「錯誤分析」和「資料視窗」的成功模式,幫助團隊快速識別問題並提升回報率。
依人氣
指出許多 AI 團隊過度關注工具而忽視實際效果。作者分享了一套基於「錯誤分析」和「資料視窗」的成功模式,幫助團隊快速識別問題並提升回報率。
探討如何透過技術寫作建立讀者群體。作者分享六個關鍵策略:深入學習他人優秀作品、保持持續更新、提升寫作技巧、建立語音轉內容管道、運用獨特視角以及最佳化社交媒體卡片。透過這些方法,內容能自然產生更多內容,形成良性迴圈。
介紹了「批判影子法」(Critique Shadowing)作為使用 LLM 作為裁判的完整指南。作者指出傳統指標設計常導致資料過載和評分標準模糊,並提出透過邀請領域專家參與,建立涵蓋特徵、場景與人設的資料集,最後迭代最佳化 LLM 裁判…
探討資料科學家是否已過輝煌時代。作者指出,雖然基礎模型 API 讓 AI 整合變得容易,但核心工作仍集中在實驗設計、系統除錯與指標設計上,而非單純呼叫模型。
探討如何選擇合適的 AI 評估工具。作者透過一場課程,讓三位專家(Langsmith、Braintrust、Arize Phoenix)完成相同的評估作業,並透過直播記錄分析其流程。文章指出,沒有單一最佳工具,選擇取決於團隊技能與技術棧。
介紹了「Eval Skills」,一套專為 AI 產品評估設計的實用技能。這些技能能幫助使用者避免常見錯誤,例如過度依賴通用指標而忽略實際資料。
這篇文章是針對工程師與產品經理整理的 AI 評估(Evals)常見問題解答。內容涵蓋從基礎概念(如 Trace、評估範例)到實作工具(如人工標籤、LLM 判分)的完整流程,並針對 RAG、程式碼代理等領域提供具體評估策略。
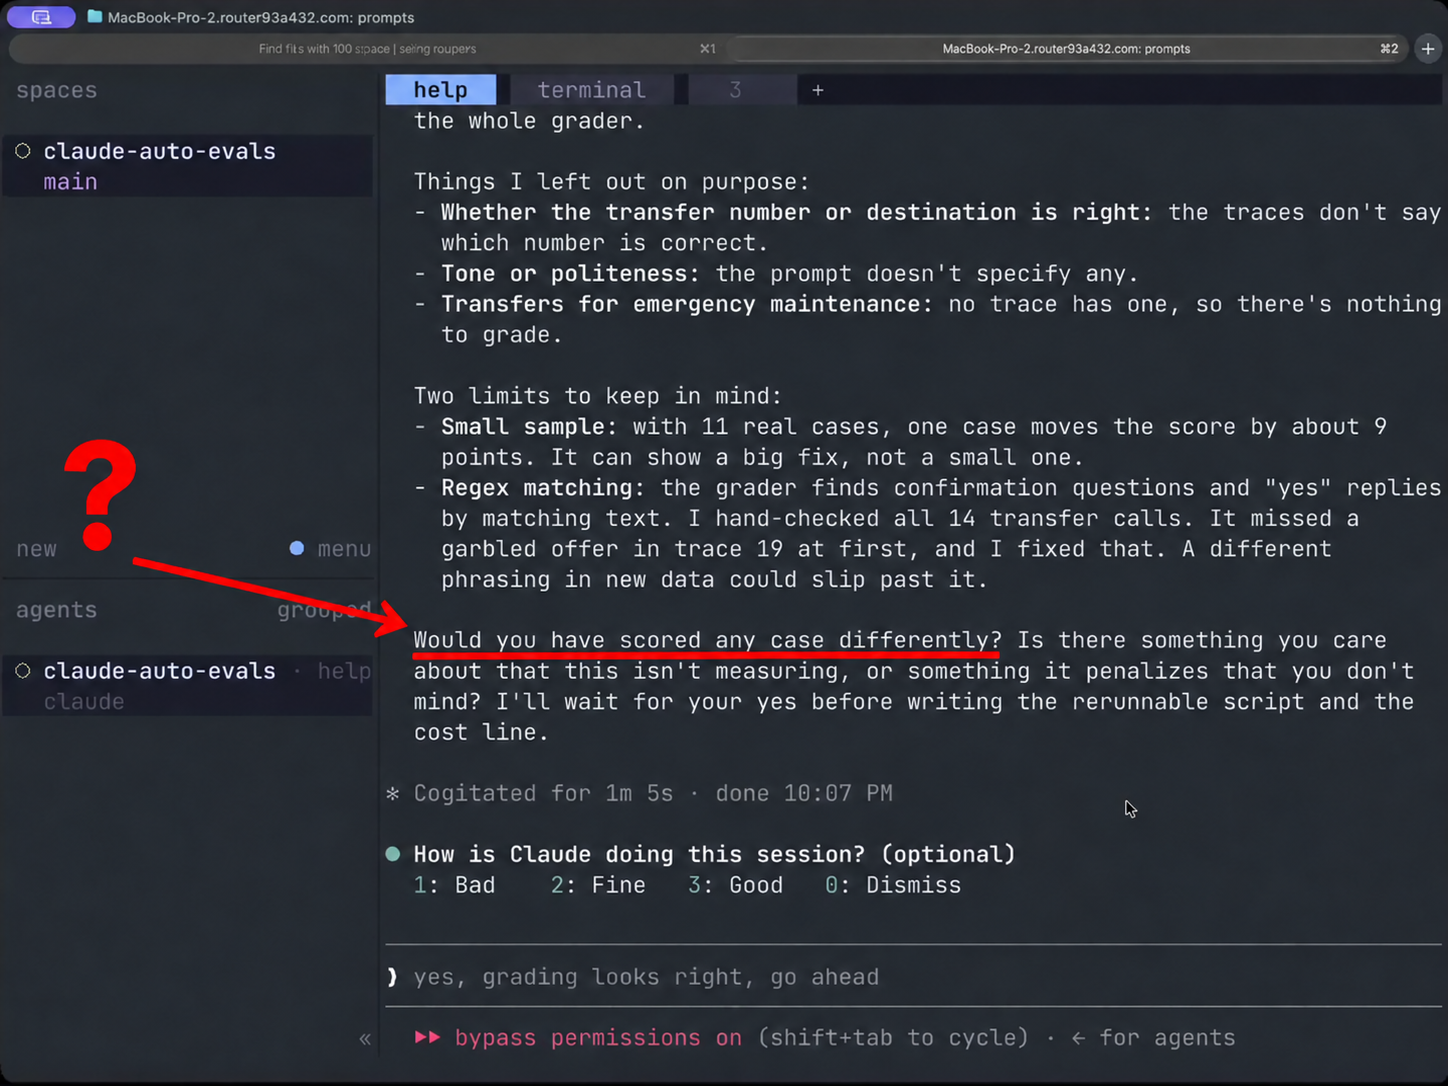
介紹了 Anthropic 為 Claude Code 開發的新自動評測工具,包含「hill-climb」命令協助使用者建立評測、檢查評分器並提升應用程式表現。作者指出工具常催促使用者先建立評測,且缺乏足夠上下文進行驗證,導致理解資料困難。
依發布時間
介紹了 Anthropic 為 Claude Code 開發的新自動評測工具,包含「hill-climb」命令協助使用者建立評測、檢查評分器並提升應用程式表現。作者指出工具常催促使用者先建立評測,且缺乏足夠上下文進行驗證,導致理解資料困難。
這篇文章是針對工程師與產品經理整理的 AI 評估(Evals)常見問題解答。內容涵蓋從基礎概念(如 Trace、評估範例)到實作工具(如人工標籤、LLM 判分)的完整流程,並針對 RAG、程式碼代理等領域提供具體評估策略。
探討資料科學家是否已過輝煌時代。作者指出,雖然基礎模型 API 讓 AI 整合變得容易,但核心工作仍集中在實驗設計、系統除錯與指標設計上,而非單純呼叫模型。
介紹了「Eval Skills」,一套專為 AI 產品評估設計的實用技能。這些技能能幫助使用者避免常見錯誤,例如過度依賴通用指標而忽略實際資料。
探討如何選擇合適的 AI 評估工具。作者透過一場課程,讓三位專家(Langsmith、Braintrust、Arize Phoenix)完成相同的評估作業,並透過直播記錄分析其流程。文章指出,沒有單一最佳工具,選擇取決於團隊技能與技術棧。
指出許多 AI 團隊過度關注工具而忽視實際效果。作者分享了一套基於「錯誤分析」和「資料視窗」的成功模式,幫助團隊快速識別問題並提升回報率。
探討如何透過技術寫作建立讀者群體。作者分享六個關鍵策略:深入學習他人優秀作品、保持持續更新、提升寫作技巧、建立語音轉內容管道、運用獨特視角以及最佳化社交媒體卡片。透過這些方法,內容能自然產生更多內容,形成良性迴圈。
介紹了「批判影子法」(Critique Shadowing)作為使用 LLM 作為裁判的完整指南。作者指出傳統指標設計常導致資料過載和評分標準模糊,並提出透過邀請領域專家參與,建立涵蓋特徵、場景與人設的資料集,最後迭代最佳化 LLM 裁判…