看影片(在新分頁開啟原站)連到 Bilibili・五道口纳什
摘要
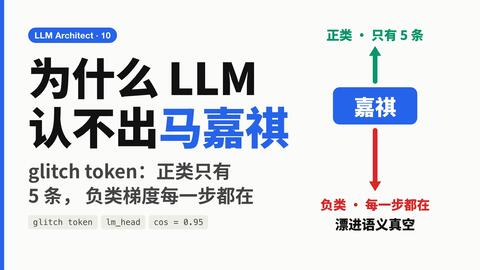
深入解析大型語言模型無法理解特定輸出(如馬嘉祺)的技術原因,涵蓋 Glitch Token、詞嵌入漂移、SFT 與 RL 等機制。觀眾可從 gradient 視角理解模型故障原理。
This video explains why LLMs fail to understand specific outputs like 'Ma Jiaqi' by analyzing Glitch Tokens, embedding drift, and gradient perspectives.
這筆內容還沒有取得字幕或內文,這段摘要只根據標題與說明欄產生,可能不夠準確;實際內容請以原站為準。
提到的工具與公司
- gpt4o
- SFT
適合誰看
具備機器學習基礎或正在研究 LLM 架構的開發者與研究者。
摘要依據
- 講者
- 五道口納什
- 依據
- 標題與說明欄(還沒有取得字幕或內文)
為什麼排在這裡
- 人氣
- 0.39
- 新鮮
- 0.56
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Never Trust An LLM影片 ・ Matt Pocock ・ 14 分鐘
- An Agent Is Just an LLM in a For-LoopPodcast ・ The Data Exchange with Ben Lorica ・ 35 分鐘
- Why Your LLM Evals Are Missing Critical Failures影片 ・ The TWIML AI Podcast with Sam Charrington
- Extrinsic Hallucinations in LLMs文章 ・ Lilian Weng(部落格)
- LLaMA explained: KV-Cache, Rotary Positional Embedding, RMS Norm, Grouped Query Attention, SwiGLU影片 ・ Umar Jamil ・ 1 小時 11 分
- 【生成式人工智慧與機器學習導論2025】第3講:解剖大型語言模型影片 ・ Hung-yi Lee ・ 2 小時 5 分
摘要由 AI 根據標題與說明欄產生(還沒有取得原文),可能有誤;完整內容請看原站。看影片(在新分頁開啟原站)