Your LLM Judge Is a Confident Liar: Building Better Verifiers — Browserbase
介紹 Miguel González Fernández 與 Corby Rosset 提出的 Universal Verifier,解決傳統 LLM 評審在電腦操作任務中誤判率高的問題。
※ 摘要僅根據標題與說明
25 筆內容提到
最近 7 天 4 筆↑3(比前一期多 3 筆)(再前 7 天 1 筆)
也寫作:GPT 4o、GPT-4-O、GPT4o
這一頁列的是「提到 GPT-4o」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「GPT-4o」。
依發布時間
介紹 Miguel González Fernández 與 Corby Rosset 提出的 Universal Verifier,解決傳統 LLM 評審在電腦操作任務中誤判率高的問題。
※ 摘要僅根據標題與說明
整理史丹佛 CS329A 課程關於多步驟任務規劃的三篇論文:LATS、SPRINT 與 SWiRL。LATS 透過樹狀搜尋與回溯讓 Agent 在執行時多條路徑比較,SPRINT 利用微調讓模型同時規劃並執行互不相干的步驟,SWiRL 則…
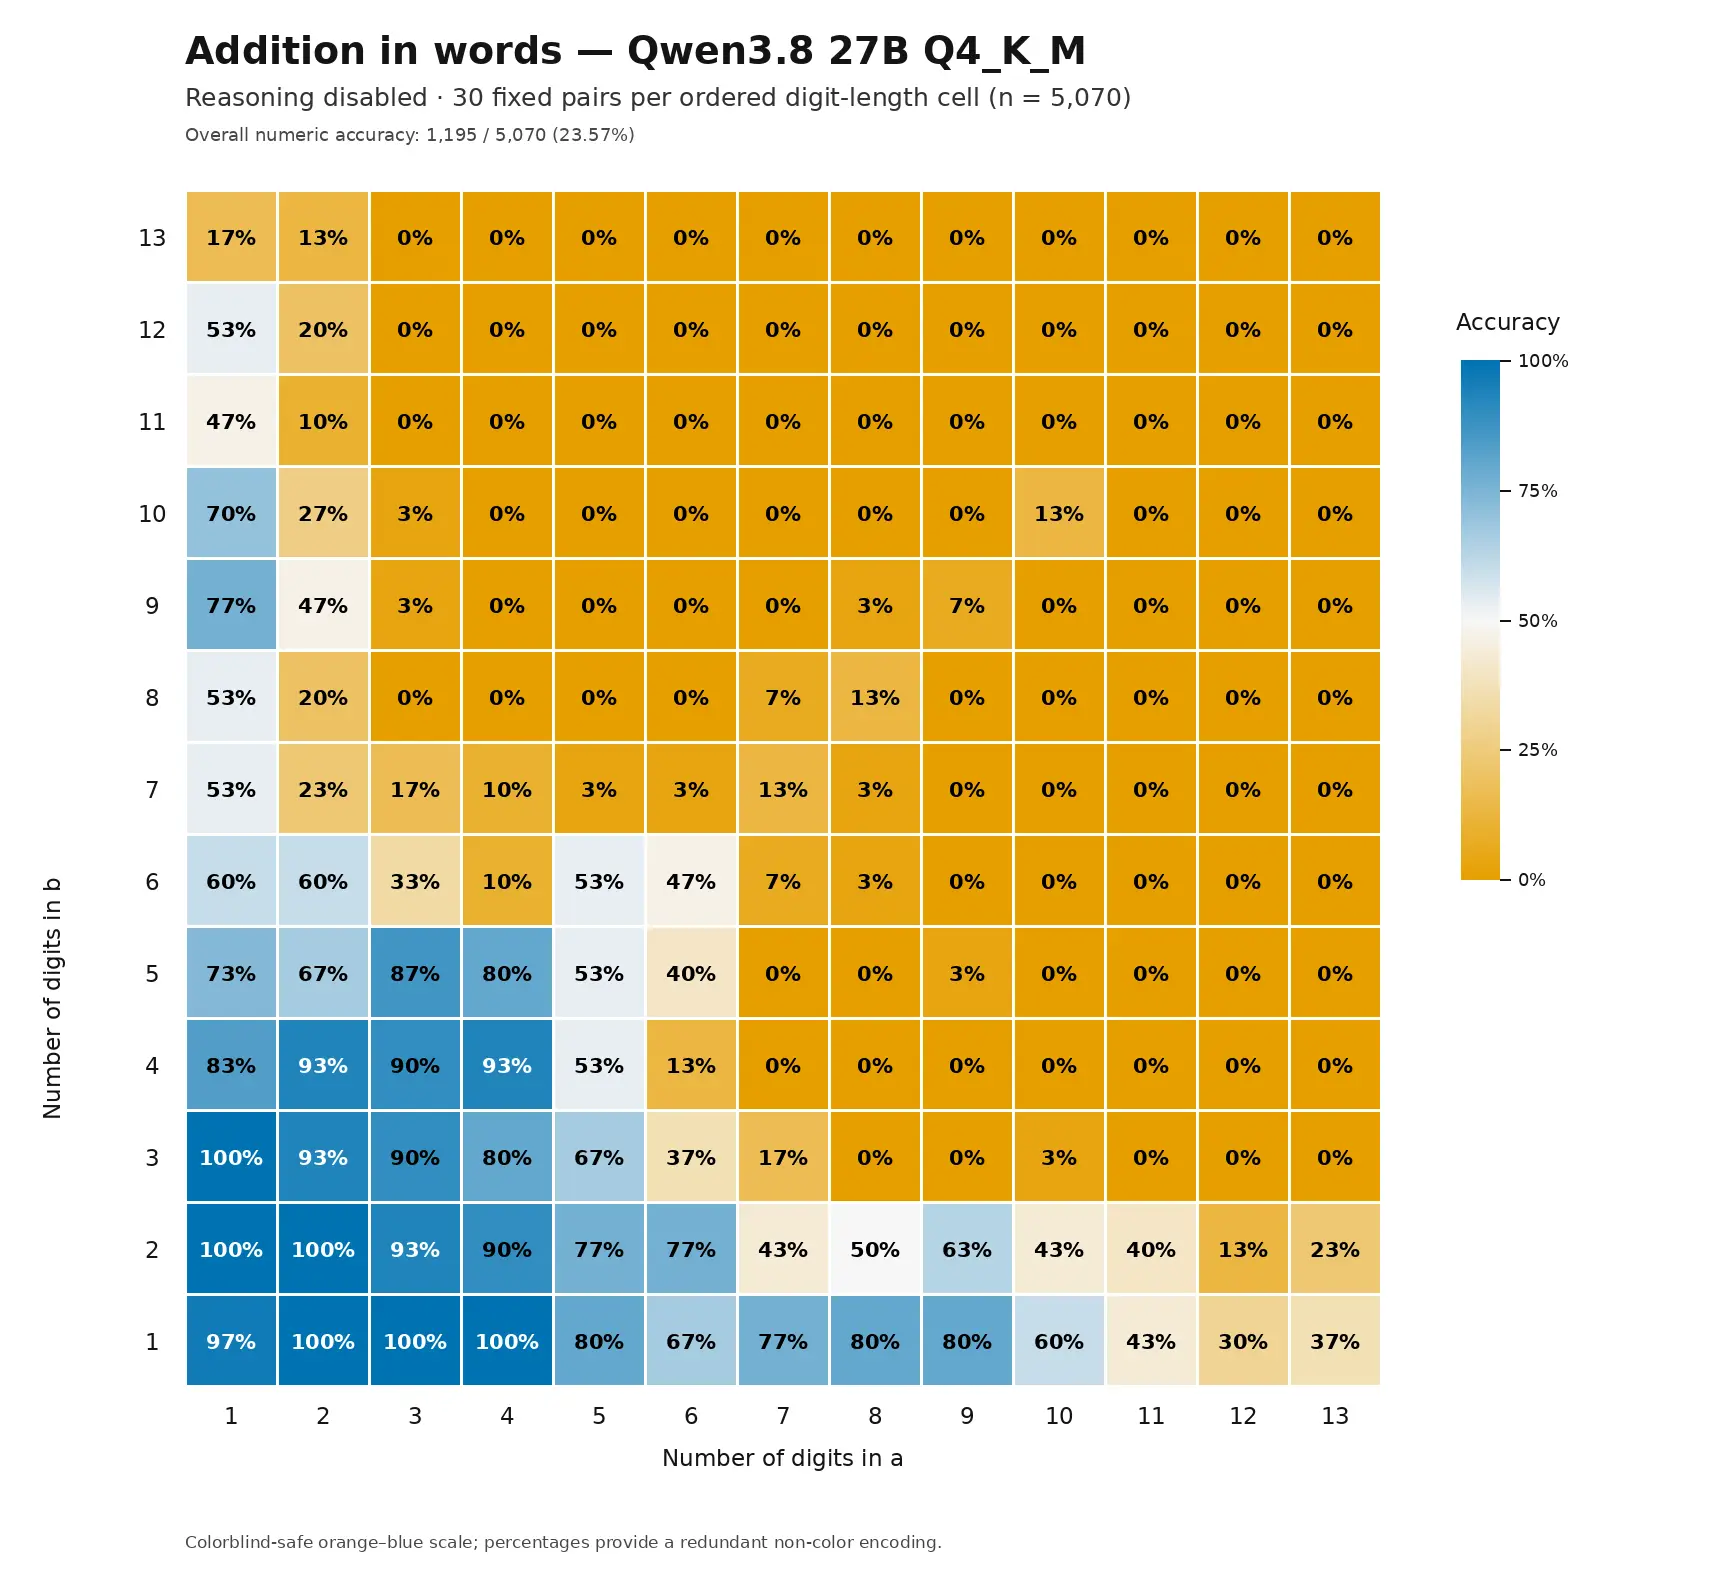
作者重現 Colin Frasier 的實驗,在本地 DGX Spark 硬體上測試 Qwen3.8-27B 模型對超大數字的加法能力。結果顯示啟用推理後,模型在 169 次嘗試中正確率極高,並能展示詳細的進位計算過程。
整理史丹佛 CS329A 課程,深入解析 ReAct、RLEF 與 Constitutional AI 三種讓 AI Agent 從回饋中自我改善的機制。
探討 AI 生成程式碼速度過快導致人工審查無效的困境,提出從「實作審查」轉向「結果審查」的策略。透過爆炸半徑分級管理、要求視覺與執行證明、以及引入對抗性 Agent 審查機制,建立自動化防護網,讓工程師專注於驗證商業意圖與架構邊界,而非糾…
梁琛奇在訪談中分享其從字節跳動到創立動念引線的創業歷程,探討如何用 AI 創造娛樂體驗而非僅限於生產力。他認為推理成本下降與模態進化是關鍵,並提出漫畫形式因壓縮資訊量更易在 AI 時代獲得使用者接受,旨在探索讓大眾主動創作的未來娛樂形態。
Diogo Almeida 與 Swyx 探討 TypeSafe AI 推出的 Jev 系統,強調以「系統一」模型取代依賴人類評分最佳化(RLHF)的傳統大型語言模型。
探討如何在推理階段透過增加計算量來提升大型語言模型效能,涵蓋並行取樣、驗證機制及架構搜尋等技術。觀眾可學習如何利用測試時計算超越現有模型,並掌握相關Scaling Law與實務架構設計。
章節探討如何評估 AI 代理在長時程任務中的表現,並介紹 METR 時間軸與 GDPval 經濟價值評估方法。內容涵蓋軟體工程、學術研究及專業領域任務的實測資料,分析模型能力增長趨勢與失敗模式。
介紹評估 AI 代理在 cybersecurity 領域能力的通用模式與四大核心原素,並深入解析 Cybench、CVE-Bench、CyberGym、ExploitGym 與 SCONE-Bench 等 benchmarks 的設計細節…
介紹 Thinking Machines 推出的互動模型,它能像電話一樣即時聽見並回應使用者,同時處理視覺與背景搜尋。內容拆解官方演示與技術原理,探討模型如何具備時間感知與流暢對話,並回顧創辦人 Mira Murati 從 OpenAI…
介紹 2026 年主流文字轉語音模型的評估結果與實際表現。透過特定資料集測試,比較 Gemini、GPT-4o、ElevenLabs 等模型在處理符號、語調及專業術語時的優劣,並示範各模型的具體操作與限制。
※ 摘要僅根據標題與說明
Eric Mar 在訪談中澄清 Moderna 內部並未使用自主代理(Agent),而是專注於建立高可靠性的工作流。他強調在受規管環境中,應優先處理權限對映與資料安全,並建議先用簡單工具或傳統機器學習解決問題,最後才考慮 LLM。
探討 AI Agent 產品開發在生產環境中面臨的技術挑戰,指出 95% 的產品會因工程架構問題失敗。內容涵蓋從 Armin Ronacher 的實戰心得到模型能力金字塔的分析,強調「有主見」的產品設計與上下文工程的重要性。
介紹上下文工程(Context Engineering)的概念,說明其與提示工程(Prompt Engineering)的異同,並探討如何透過最佳化輸入讓語言模型獲得預期輸出。
李宏毅教授概述語音語言模型的發展歷程,解釋其如何透過語音 token 進行訓練與生成,並探討處理多義輸出、同時聽說等挑戰。課程涵蓋從預訓練到微調的策略,以及相關工具與評估方法,讓讀者了解語音 AI 的技術架構與應用現況。
介紹 NVIDIA 團隊提出的 STORM 架構,利用 Mamba 層進行時間建模與 token 壓縮,解決長影片處理效率低與冗餘多的問題。看完能了解如何在不犧牲精度的情況下,將視覺 token 減少八倍並提升推理速度。
※ 摘要僅根據標題與說明
李宏毅教授深入解析生成式 AI 的後訓練(Post-Training)與遺忘問題,說明如何為通用模型注入特定技能。課程探討了避免模型在學習新任務時遺忘原有能力的策略,並介紹了過濾難產生 Token 的技術。
※ 摘要僅根據標題與說明
OpenAI 第九天開發者日發布 o1 API 正式版、WebRTC 語音支援及偏好微調功能,並推出 Go 與 Java 開發套件。開發者可透過這些更新以更低成本與更簡易方式構建應用。
※ 摘要僅根據標題與說明
OpenAI 公佈 o1 模型正式版本,支援多模態輸入與網路瀏覽,並推出 ChatGPT Pro 訂閱制。使用者可無限訪問 o1 及 o1 Pro 模式,解決複雜問題。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
由李宏毅講授,深入解析生成式 AI 如何產生圖片與影片,涵蓋從視覺語言模型到 Sora 背後的原理。內容說明如何利用深度學習自動提取特徵,並透過多階段生成策略提升畫質與幀數,同時探討影像生成在 VTuber 與影像修復等領域的應用。
李宏毅透過影片推測 GPT-4o 語音模式背後的技術架構,分析其如何透過情緒辨識、混合編碼器及多頻道處理實現自然互動。觀眾可了解當前語音模型與 GPT-4o 的差異,並掌握未來語音 AI 發展的可能方向。
深入探討大型語言模型面臨的欺騙風險,區分「越獄」與「提示注入」兩種攻擊手法。透過實際範例與最新研究,說明如何繞過模型防禦機制,並提醒使用者注意潛在的隱私洩漏與安全隱患。
依人氣
介紹 Miguel González Fernández 與 Corby Rosset 提出的 Universal Verifier,解決傳統 LLM 評審在電腦操作任務中誤判率高的問題。
※ 摘要僅根據標題與說明
探討如何在推理階段透過增加計算量來提升大型語言模型效能,涵蓋並行取樣、驗證機制及架構搜尋等技術。觀眾可學習如何利用測試時計算超越現有模型,並掌握相關Scaling Law與實務架構設計。
介紹評估 AI 代理在 cybersecurity 領域能力的通用模式與四大核心原素,並深入解析 Cybench、CVE-Bench、CyberGym、ExploitGym 與 SCONE-Bench 等 benchmarks 的設計細節…
作者重現 Colin Frasier 的實驗,在本地 DGX Spark 硬體上測試 Qwen3.8-27B 模型對超大數字的加法能力。結果顯示啟用推理後,模型在 169 次嘗試中正確率極高,並能展示詳細的進位計算過程。
介紹上下文工程(Context Engineering)的概念,說明其與提示工程(Prompt Engineering)的異同,並探討如何透過最佳化輸入讓語言模型獲得預期輸出。
章節探討如何評估 AI 代理在長時程任務中的表現,並介紹 METR 時間軸與 GDPval 經濟價值評估方法。內容涵蓋軟體工程、學術研究及專業領域任務的實測資料,分析模型能力增長趨勢與失敗模式。
探討 AI Agent 產品開發在生產環境中面臨的技術挑戰,指出 95% 的產品會因工程架構問題失敗。內容涵蓋從 Armin Ronacher 的實戰心得到模型能力金字塔的分析,強調「有主見」的產品設計與上下文工程的重要性。
梁琛奇在訪談中分享其從字節跳動到創立動念引線的創業歷程,探討如何用 AI 創造娛樂體驗而非僅限於生產力。他認為推理成本下降與模態進化是關鍵,並提出漫畫形式因壓縮資訊量更易在 AI 時代獲得使用者接受,旨在探索讓大眾主動創作的未來娛樂形態。
Diogo Almeida 與 Swyx 探討 TypeSafe AI 推出的 Jev 系統,強調以「系統一」模型取代依賴人類評分最佳化(RLHF)的傳統大型語言模型。
Eric Mar 在訪談中澄清 Moderna 內部並未使用自主代理(Agent),而是專注於建立高可靠性的工作流。他強調在受規管環境中,應優先處理權限對映與資料安全,並建議先用簡單工具或傳統機器學習解決問題,最後才考慮 LLM。