1影片高階中文
[LLM Architect] 12 Kimi K3 架构初步,张量计算视角,KDA,MLA,Latent MoE,MoonViT 与残差注意力
從張量計算視角解析 Kimi K3 架構,涵蓋 KDA、MLA、Latent MoE 與 MoonViT 等關鍵技術。觀眾可了解大型語言模型內部運作原理與最佳化策略。
4.1 萬次觀看
※ 摘要僅根據標題與說明
Bilibili ・ 華語圈 ・ 簡體中文 ・ A 級 ・ 8.7 萬 訂閱 ・ 19 筆內容 ・ 最近更新 2026/10/07
硬核的 LLM 架構與訓練/推論基礎設施:模型架構推測、KV cache、多卡訓練、量化、算力密度,直接寫程式碼講
依人氣
從張量計算視角解析 Kimi K3 架構,涵蓋 KDA、MLA、Latent MoE 與 MoonViT 等關鍵技術。觀眾可了解大型語言模型內部運作原理與最佳化策略。
※ 摘要僅根據標題與說明
介紹 A100 SXM GPU 計算節點的必要基礎配置,涵蓋 SXM、PCIe 與 HGX 架構,並演示 CPU 與 GPU 及記憶體頻寬測試方法。觀眾可學習如何設定與驗證高階訓練環境。
※ 摘要僅根據標題與說明
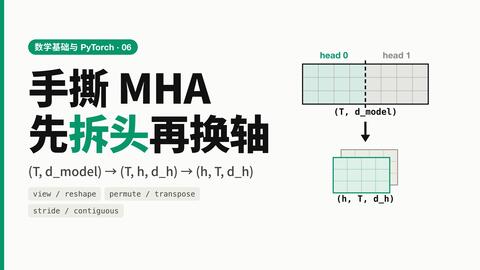
由五道口納什講解高維張量的 reshape 與 permute 操作,並手動實現 MHA 核心邏輯。觀眾可透過影片掌握 PyTorch 中張量形狀處理的細節與原理。
※ 摘要僅根據標題與說明
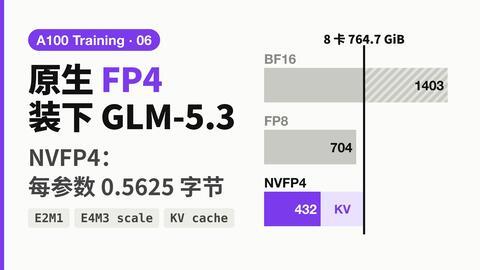
介紹如何使用 NVFP4、E2M1 量化與 KV cache 技術,在 8 卡 RTX Pro 6000 上執行 GLM-5.3 模型。觀眾可學習如何最佳化硬體資源以在有限算力下部署大型語言模型。
※ 摘要僅根據標題與說明
比較 Apple M5 Pro/Max 晶片與 Nvidia GPU 的記憶體頻寬、統一記憶體與 Tensor Core 等融合架構特性。觀眾可了解 Apple 晶片在 AI 運算上的優勢與差異。
※ 摘要僅根據標題與說明
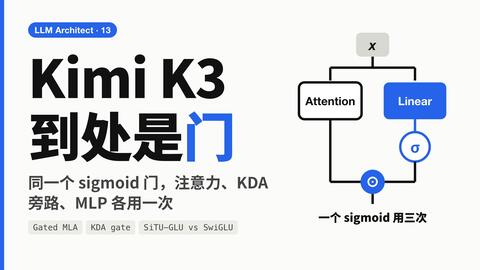
解析 Kimi K3 模型中的門控機制、門控注意力及 MoE 中的激活函數應用。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
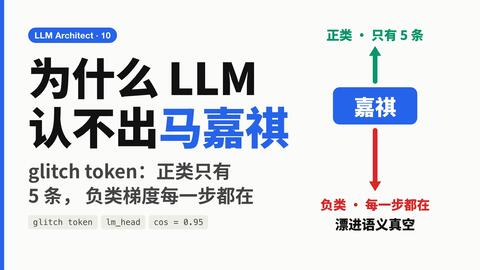
深入解析大型語言模型無法理解特定輸出(如馬嘉祺)的技術原因,涵蓋 Glitch Token、詞嵌入漂移、SFT 與 RL 等機制。觀眾可從 gradient 視角理解模型故障原理。
※ 摘要僅根據標題與說明
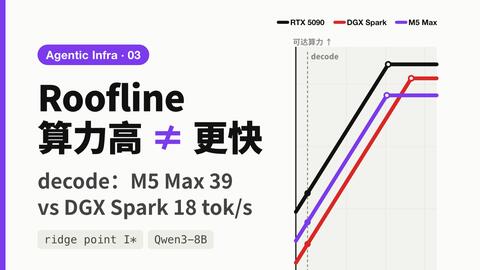
探討算力密度與 Roofline model,比較 5090、M5 max 與 DGX Spark 的效能,並分析 Qwen3-8B 的算力與記憶體存取特性。觀眾可透過影片了解不同硬體在生成式 AI 架構下的實際表現與選型考量。
※ 摘要僅根據標題與說明
五道口納什串講 Kimi K2.5 論文,介紹原生多模態與 Agent Swarm 技術。
※ 摘要僅根據標題與說明
依發布時間
介紹如何使用 NVFP4、E2M1 量化與 KV cache 技術,在 8 卡 RTX Pro 6000 上執行 GLM-5.3 模型。觀眾可學習如何最佳化硬體資源以在有限算力下部署大型語言模型。
※ 摘要僅根據標題與說明
探討算力密度與 Roofline model,比較 5090、M5 max 與 DGX Spark 的效能,並分析 Qwen3-8B 的算力與記憶體存取特性。觀眾可透過影片了解不同硬體在生成式 AI 架構下的實際表現與選型考量。
※ 摘要僅根據標題與說明
由五道口納什講解高維張量的 reshape 與 permute 操作,並手動實現 MHA 核心邏輯。觀眾可透過影片掌握 PyTorch 中張量形狀處理的細節與原理。
※ 摘要僅根據標題與說明
解析 Kimi K3 模型中的門控機制、門控注意力及 MoE 中的激活函數應用。
※ 摘要僅根據標題與說明
從張量計算視角解析 Kimi K3 架構,涵蓋 KDA、MLA、Latent MoE 與 MoonViT 等關鍵技術。觀眾可了解大型語言模型內部運作原理與最佳化策略。
※ 摘要僅根據標題與說明
示範如何在使用 A100 訓練大型語言模型時,透過 Docker 容器進行斷點除錯與原始碼細讀。觀眾能學習到使用 Ray 框架進行分散式除錯的具體方法與技術細節。
※ 摘要僅根據標題與說明
介紹 A100 SXM GPU 計算節點的必要基礎配置,涵蓋 SXM、PCIe 與 HGX 架構,並演示 CPU 與 GPU 及記憶體頻寬測試方法。觀眾可學習如何設定與驗證高階訓練環境。
※ 摘要僅根據標題與說明
深入探討 GPT Pro 的通用工具設計,涵蓋搜尋、CLI 與沙盒系統硬體等技術細節。觀眾可學習如何構建具備搜尋與命令列能力的 AI 系統,並了解相關開發環境與限制。
※ 摘要僅根據標題與說明
回顧策略梯度、分數函式技巧、蒙特卡洛取樣與重要性取樣,並結合 PyTorch 最佳化與實際範例。觀眾可理解強化學習中的核心演算法原理與實作方法。
※ 摘要僅根據標題與說明
介紹 MacOS 在 Coding Agent 時代的實用 CLI 工具配置與心流體驗。
※ 摘要僅根據標題與說明
深入解析大型語言模型無法理解特定輸出(如馬嘉祺)的技術原因,涵蓋 Glitch Token、詞嵌入漂移、SFT 與 RL 等機制。觀眾可從 gradient 視角理解模型故障原理。
※ 摘要僅根據標題與說明
介紹 GPT Image 2 的多圖一致性、智慧搜尋與思考生成功能,並提供相關程式碼範例。觀眾可學習如何應用最新 AI 影像與代理技術。
※ 摘要僅根據標題與說明
介紹 Codex 中 Plan Mode 的運作機制,涵蓋計畫建立、狀態更新與重新規劃(replan)的動態過程。觀眾可透過影片理解現代代理系統中計畫管理的核心邏輯。
※ 摘要僅根據標題與說明
介紹 Codex 模型中的上下文壓縮技術與任務交接機制,並演示如何破解 compact 介面提示詞。觀眾可學習現代代理系統中最佳化上下文處理與指令設計的方法。
※ 摘要僅根據標題與說明
深入解析大型語言模型架構中的 prefill 與 decode 階段,涵蓋 KV-Cache、並行與序列機制及 GEMM-GEMV 運算。觀眾能理解 LLM 推理的核心流程與效能最佳化原理。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
介紹 Codex 模型在現代代理中的初步應用,涵蓋系統提示詞注入、會話歷史管理與上下文工程技術。觀眾可學習如何最佳化提示詞與管理上下文以提升 AI 代理效能。
※ 摘要僅根據標題與說明
比較 Apple M5 Pro/Max 晶片與 Nvidia GPU 的記憶體頻寬、統一記憶體與 Tensor Core 等融合架構特性。觀眾可了解 Apple 晶片在 AI 運算上的優勢與差異。
※ 摘要僅根據標題與說明
五道口納什串講 Kimi K2.5 論文,介紹原生多模態與 Agent Swarm 技術。
※ 摘要僅根據標題與說明