讀原文(在新分頁開啟原站)連到 Eugene Yan(部落格)
摘要
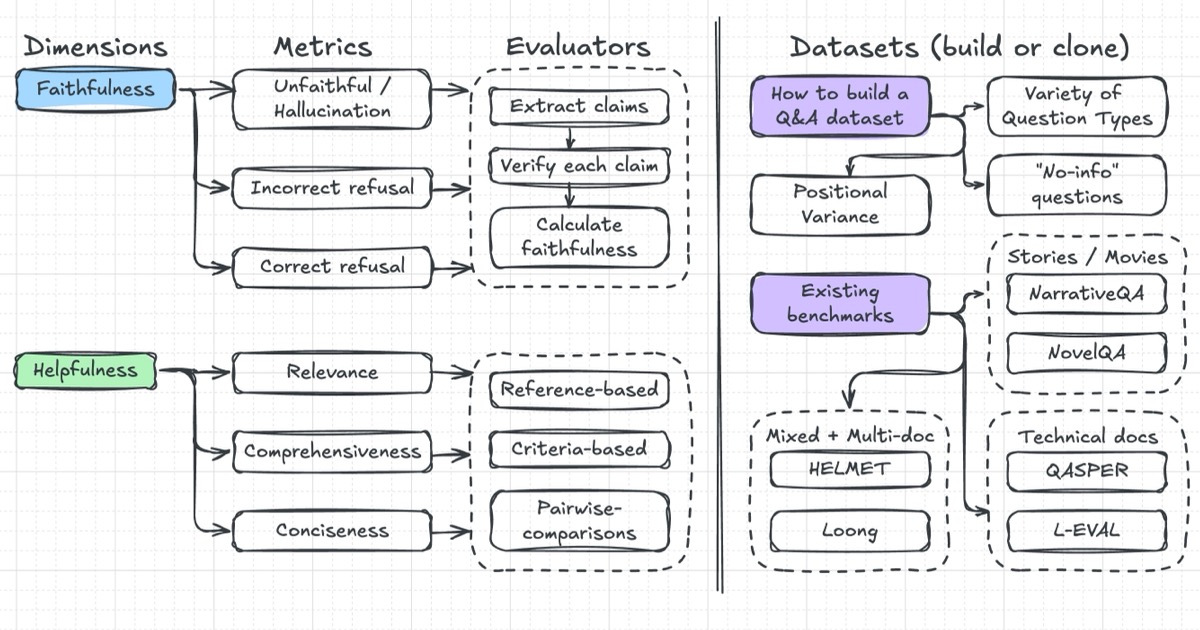
探討如何評估長上下文下的問答系統。作者指出,隨著文件變大,資訊過載、位置偏差、多跳推理及幻覺等問題會顯著增加。文章介紹了評估指標、如何建立評估資料集的方法,並回顧了多個文件型別(如小說、技術文獻)的測試基準,強調需同時考量忠實度與幫助性。
This article explores how to evaluate question-and-answer systems in long contexts. It highlights challenges like information overload and positional variance, and reviews benchmarks for narrative and technical texts. The paper discusses metrics for faithfulness and helpfulness, and outlines methods…
重點
- 評估長文件問答系統需克服資訊過載、位置偏差及多跳推理等挑戰。
- 建立評估資料集時,應混合使用事實 recall、定義、摘要及推理類問題以測試不同能力。
- 忠實度與幫助性是兩個關鍵維度,系統需同時滿足基於原文的準確與對使用者的實用性。
提到的工具與公司
- NarrativeQA
- NovelQA
- QASPER
- QAFactEval
- BAMBOO
- ELI5
- RefChecker
- LFED
適合誰看
資料分析師、技術寫作者、專案經理或需要處理長文件 Q&A 系統開發的工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.17
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- How to Build an Open-Domain Question Answering System?文章 ・ Lilian Weng(部落格)
- Understanding the 4 Main Approaches to LLM Evaluation (From Scratch)文章 ・ Sebastian Raschka(部落格)
- 【生成式AI時代下的機器學習(2025)】第九講:你這麽認這個評分系統幹什麽啊?談談有關大型語言模型評估的幾件事影片 ・ Hung-yi Lee ・ 24 分鐘(在新分頁開啟原站)
- AI Evals: Everything You Need to Know文章 ・ Hamel Husain(部落格)
- Task-Specific LLM Evals that Do & Don't Work文章 ・ Eugene Yan(部落格)
- Evaluating the Effectiveness of LLM-Evaluators (aka LLM-as-Judge)文章 ・ Eugene Yan(部落格)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)