文章高階EN
Evaluating the Effectiveness of LLM-Evaluators (aka LLM-as-Judge)
讀原文(在新分頁開啟原站)連到 Eugene Yan(部落格)
摘要
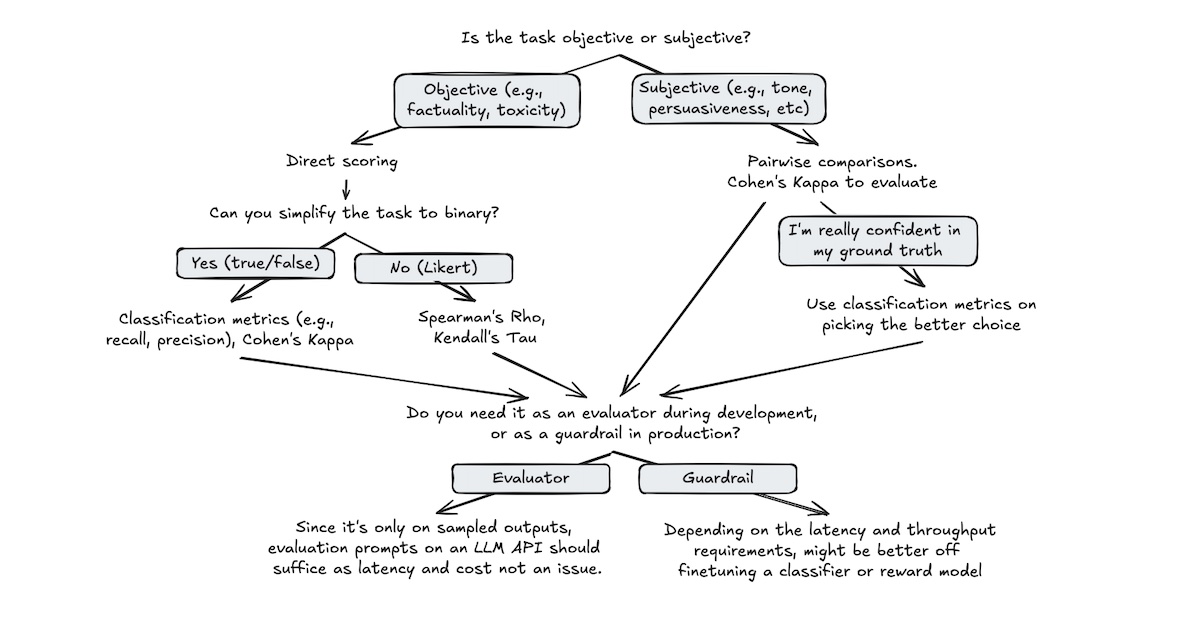
探討了 LLM 作為裁判器(LLM-as-Judge)的效能,涵蓋了應用場景、評估技術、模型對齊及訓練方法。作者分析了直接評分、成對比較與參考評估三種方法,並討論了分類指標與相關係數指標的適用性。文章總結了多篇關於有害內容審查、摘要質量評估、事實一致性檢查及使用者中心化約束的例項研究,並指出 LLM 裁判器在速度、成本與準確性上的優勢,同時提醒使用者注意基線選擇與指標選擇的重要性。
This paper reviews the effectiveness of LLM-evaluators (LLM-as-Judge), covering use cases, techniques, alignment, and training methods. It analyzes direct scoring, pairwise comparison, and reference-based evaluation, discussing classification and correlation metrics. The article summarizes empirical…
重點
- 直接評分適合客觀評估,成對比較更適用於主觀評分。
- 分類指標易於應用,相關係數指標需謹慎選擇。
- 多篇例項研究展示了 LLM 裁判器在有害內容與摘要評估中的效能。
提到的工具與公司
- GUI
適合誰看
工程師、產品經理或對 LLM 評估技術感興趣的開發者。
摘要依據
- 講者
- Eugene Yan
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.05
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Using LLM-as-a-Judge For Evaluation: A Complete Guide文章 ・ Hamel Husain(部落格)
- Understanding the 4 Main Approaches to LLM Evaluation (From Scratch)文章 ・ Sebastian Raschka(部落格)
- Weights & Biases LLM-Evaluator Hackathon - Hackathon Judge文章 ・ Eugene Yan(部落格)
- Task-Specific LLM Evals that Do & Don't Work文章 ・ Eugene Yan(部落格)
- 【生成式AI導論 2024】第12講:淺談檢定大型語言模型能力的各種方式影片 ・ Hung-yi Lee ・ 46 分鐘(在新分頁開啟原站)
- What We've Learned From A Year of Building with LLMs文章 ・ Hamel Husain(部落格)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)