讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
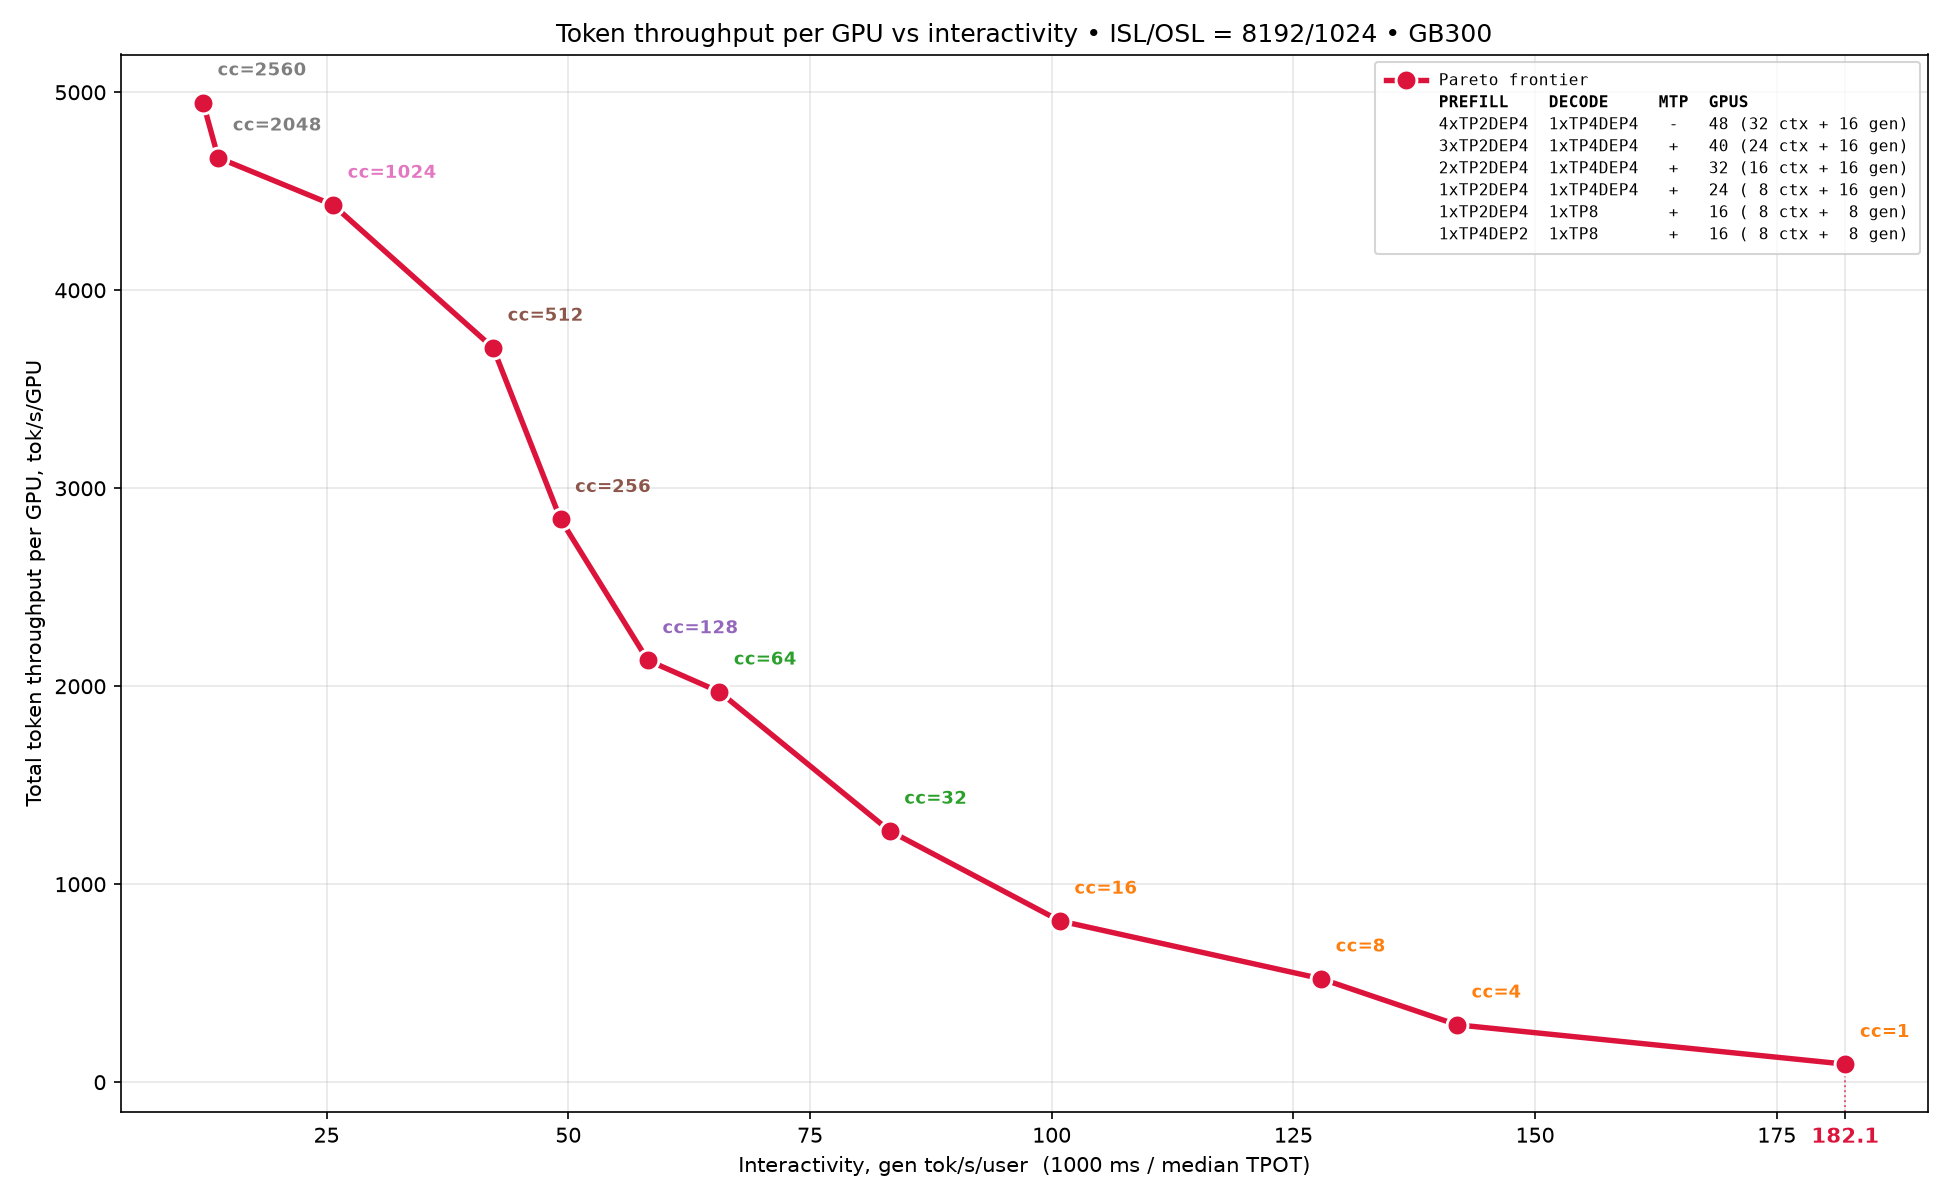
介紹如何在 GB300 NVL72 叢集上,使用 vLLM 對 Qwen3.8-2.4T 模型進行 PD 服務最佳化,達成每秒 5000 總 token 吞吐與 180 生成 token 使用者互動。文章詳解從 KV Cache 估算、CUDA Graphs 記憶體規劃到並行配置決策的完整除錯流程,並提供可重現的 srt-slurm 指令碼。
This blog post details optimizing PD serving for Qwen3.8-2.4T on vLLM using GB300 NVL72, achieving 5K throughput and 180 interactivity with reproducible tuning recipes.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 在 GB300 NVL72 叢集上對 Qwen3.8-2.4T 模型進行 PD 服務效能測試。
- 詳細拆解從 KV Cache 估算到 CUDA Graphs 記憶體規劃的最佳化步驟。
- 提供可重現的 srt-slurm 指令碼與完整 Pareto 曲線資料。
提到的工具與公司
- vLLM
- Qwen3.8-2.4T
- GB300 NVL72
- AIPerf
- Dynamo
- CUDA graphs
- NVLink72
適合誰看
負責大模型推理服務架構設計、效能調優或需要部署 Qwen3.8 系列模型的工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.93
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- vLLM Reaches 25K Total TPS/GPU on Qwen3.5文章 ・ vLLM Blog
- Qwen3.8-27B & How to Serve it Fast影片 ・ Sam Witteveen ・ 18 分鐘
- Day 0 Support for Qwen3.8-2.4T-A95B on vLLM文章 ・ vLLM Blog
- 8G 显存竟能跑 125B 大模型!内存硬抗 Qwen3.8-Flash-Next,N卡、A卡都能用!本地部署实测 | 零度解说影片 ・ 零度解说 ・ 10 分鐘
- This Small AI Will Change Everything影片 ・ Two Minute Papers ・ 3 分鐘
- Optimize, deploy, and benchmark an open-source LLM with vLLM影片 ・ DeepLearningAI ・ 2 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)