讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
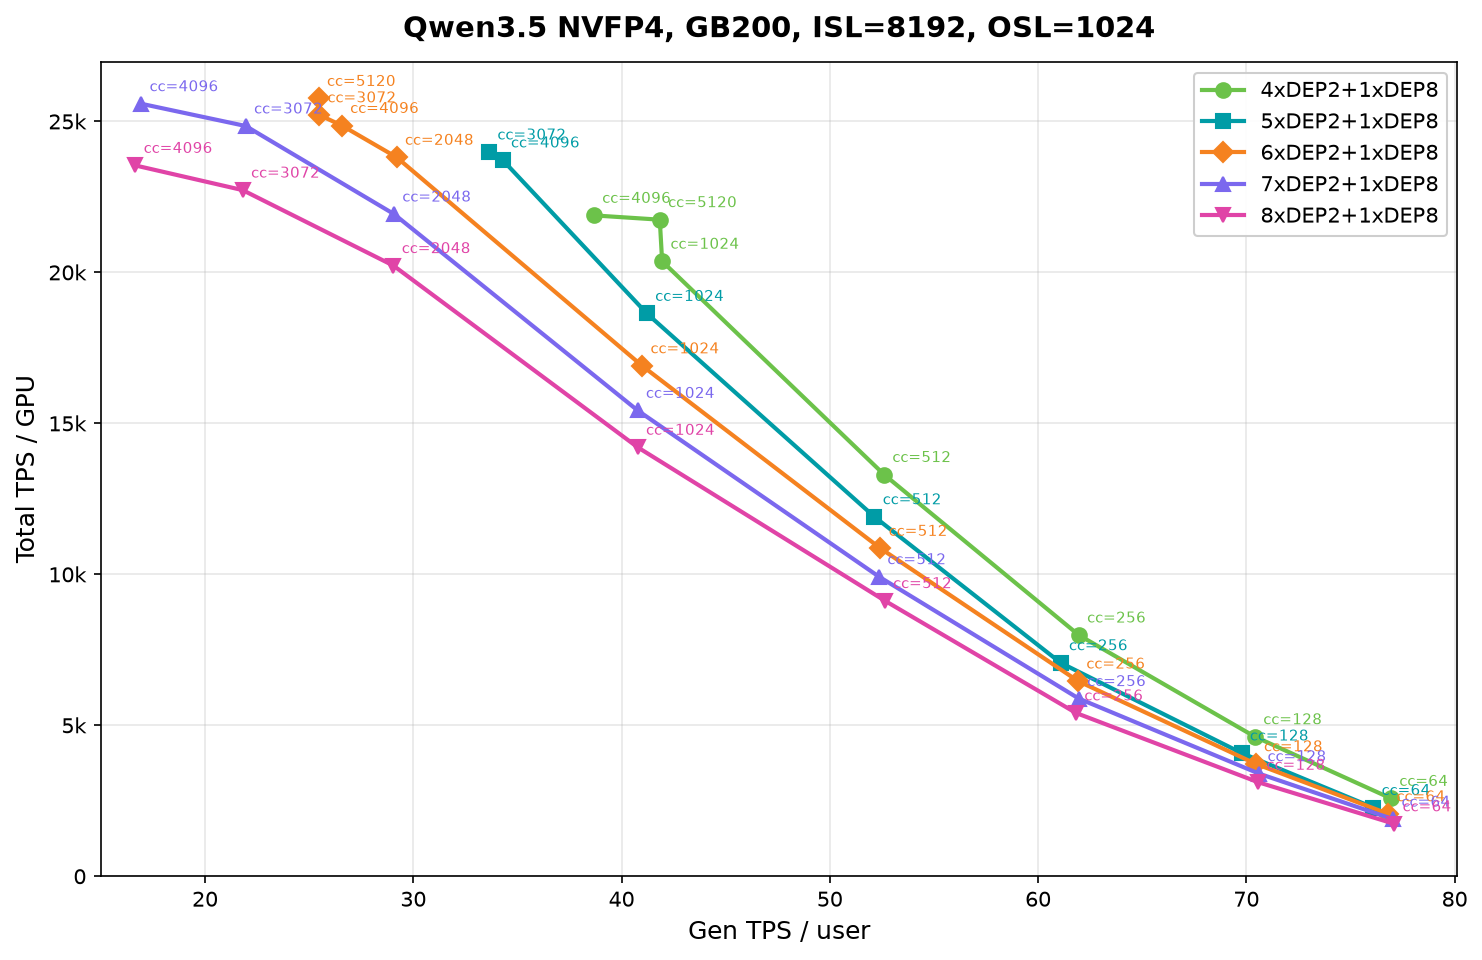
vLLM 團隊分享在 GB200 NVL72 系統上,利用 Blackwell GDN 核、混合快取轉移與無競態非同步排程等最佳化,讓 Qwen3.5-397B 模型達到每 GPU 每秒 25,000 字元的服務效能。文章詳述了針對混合注意力架構的具體實作細節、最佳實踐設定與複現步驟。
vLLM demonstrates achieving 25K TPS/GPU on Qwen3.5 using Blackwell optimizations, hybrid cache transfer, and fixed async scheduling on GB200 systems.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- vLLM 在 GB200 系統上將 Qwen3.5 模型每 GPU 效能提升至 25,000 TPS。
- 透過 Blackwell GDN 核最佳化與混合快取轉移解決異構模型服務挑戰。
- 提供包含非同步排程修復與最佳參數設定的完整複現食譜。
提到的工具與公司
- vLLM
- Qwen3.5-397B-A17B-NVFP4
- GB200 NVL72
- Blackwell GDN kernels
- HMA
- NIXL
- Dynamo
適合誰看
正在開發或最佳化大模型推理服務、熟悉 vLLM 與 NVIDIA 硬體架構的開發者。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.78
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- PD Serving of Qwen3.8-2.4T文章 ・ vLLM Blog
- Day 0 Support for Qwen3.8-2.4T-A95B on vLLM文章 ・ vLLM Blog
- What exactly happens when you press send: Journey from Chat to a GPU影片 ・ Vizuara
- 8G 显存竟能跑 125B 大模型!内存硬抗 Qwen3.8-Flash-Next,N卡、A卡都能用!本地部署实测 | 零度解说影片 ・ 零度解说 ・ 10 分鐘
- Qwen3.8-27B & How to Serve it Fast影片 ・ Sam Witteveen ・ 18 分鐘
- [Agentic Infra] 03 算力密度与Roofline model,对比 5090/M5 max/DGX spark,Qwen3-8B 算力与访存影片 ・ 五道口纳什 ・ 29 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)