看影片(在新分頁開啟原站)連到 Bilibili・五道口纳什
摘要
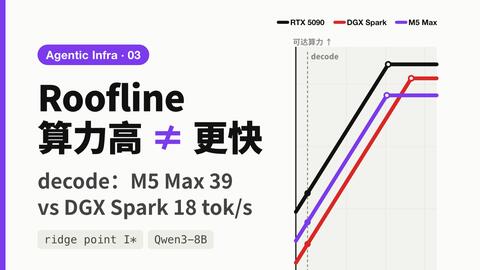
探討算力密度與 Roofline model,比較 5090、M5 max 與 DGX Spark 的效能,並分析 Qwen3-8B 的算力與記憶體存取特性。觀眾可透過影片了解不同硬體在生成式 AI 架構下的實際表現與選型考量。
Video compares GPU performance and memory access characteristics of different models for Qwen3-8B.
這筆內容還沒有取得字幕或內文,這段摘要只根據標題與說明欄產生,可能不夠準確;實際內容請以原站為準。
提到的工具與公司
- M5 Max
- DGX Spark
- Qwen3-8B
適合誰看
適合具備基礎機器學習知識、正在評估或最佳化 AI 訓練與推論硬體配置的開發者與工程師。
摘要依據
- 講者
- 五道口納什
- 依據
- 標題與說明欄(還沒有取得字幕或內文)
為什麼排在這裡
- 人氣
- 0.39
- 新鮮
- 0.89
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Running models on 32GB, Muse 30B, Qwen 3.8, New Agentic Benchmarks, Toolbox Updates / Discord影片 ・ Donato Capitella
- Day 0 Support for Qwen3.8-2.4T-A95B on vLLM文章 ・ vLLM Blog
- The Only Guide You Need for Local AI Hardware影片 ・ Tech With Tim ・ 19 分鐘
- vLLM Reaches 25K Total TPS/GPU on Qwen3.5文章 ・ vLLM Blog
- 8G 显存竟能跑 125B 大模型!内存硬抗 Qwen3.8-Flash-Next,N卡、A卡都能用!本地部署实测 | 零度解说影片 ・ 零度解说 ・ 10 分鐘
- [硬件扫盲] 苹果 M5 pro/max 芯片,对比 Nvidia GPU,内存带宽,统一内存,tensor core,融合架构影片 ・ 五道口纳什 ・ 23 分鐘
摘要由 AI 根據標題與說明欄產生(還沒有取得原文),可能有誤;完整內容請看原站。看影片(在新分頁開啟原站)