【劉永信專欄】Perplexity Portable Computer 登陸 Windows!一張顯卡就能跑 AI,代價是什麼?
Perplexity 推出 Portable Computer,讓具備 24GB 視訊記憶體的 Windows 電腦能本地執行 AI 助理,無需雲端連線。
22 筆內容提到
最近 7 天 4 筆↑2(比前一期多 2 筆)(再前 7 天 2 筆)
也寫作:NVIDIA DGX Spark
這一頁列的是「提到 DGX Spark」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「DGX Spark」。
依發布時間
Perplexity 推出 Portable Computer,讓具備 24GB 視訊記憶體的 Windows 電腦能本地執行 AI 助理,無需雲端連線。
解析企業導入 AI Agent 時,如何根據資料機密、延遲與成本考量,在雲端、地端或雲地協同間做選擇。文章以麗台 NVIDIA RTX PRO AI 工作站為例,說明地端部署如何保護專利與 SOP,並透過多 GPU 擴充與 AIDMS 系…
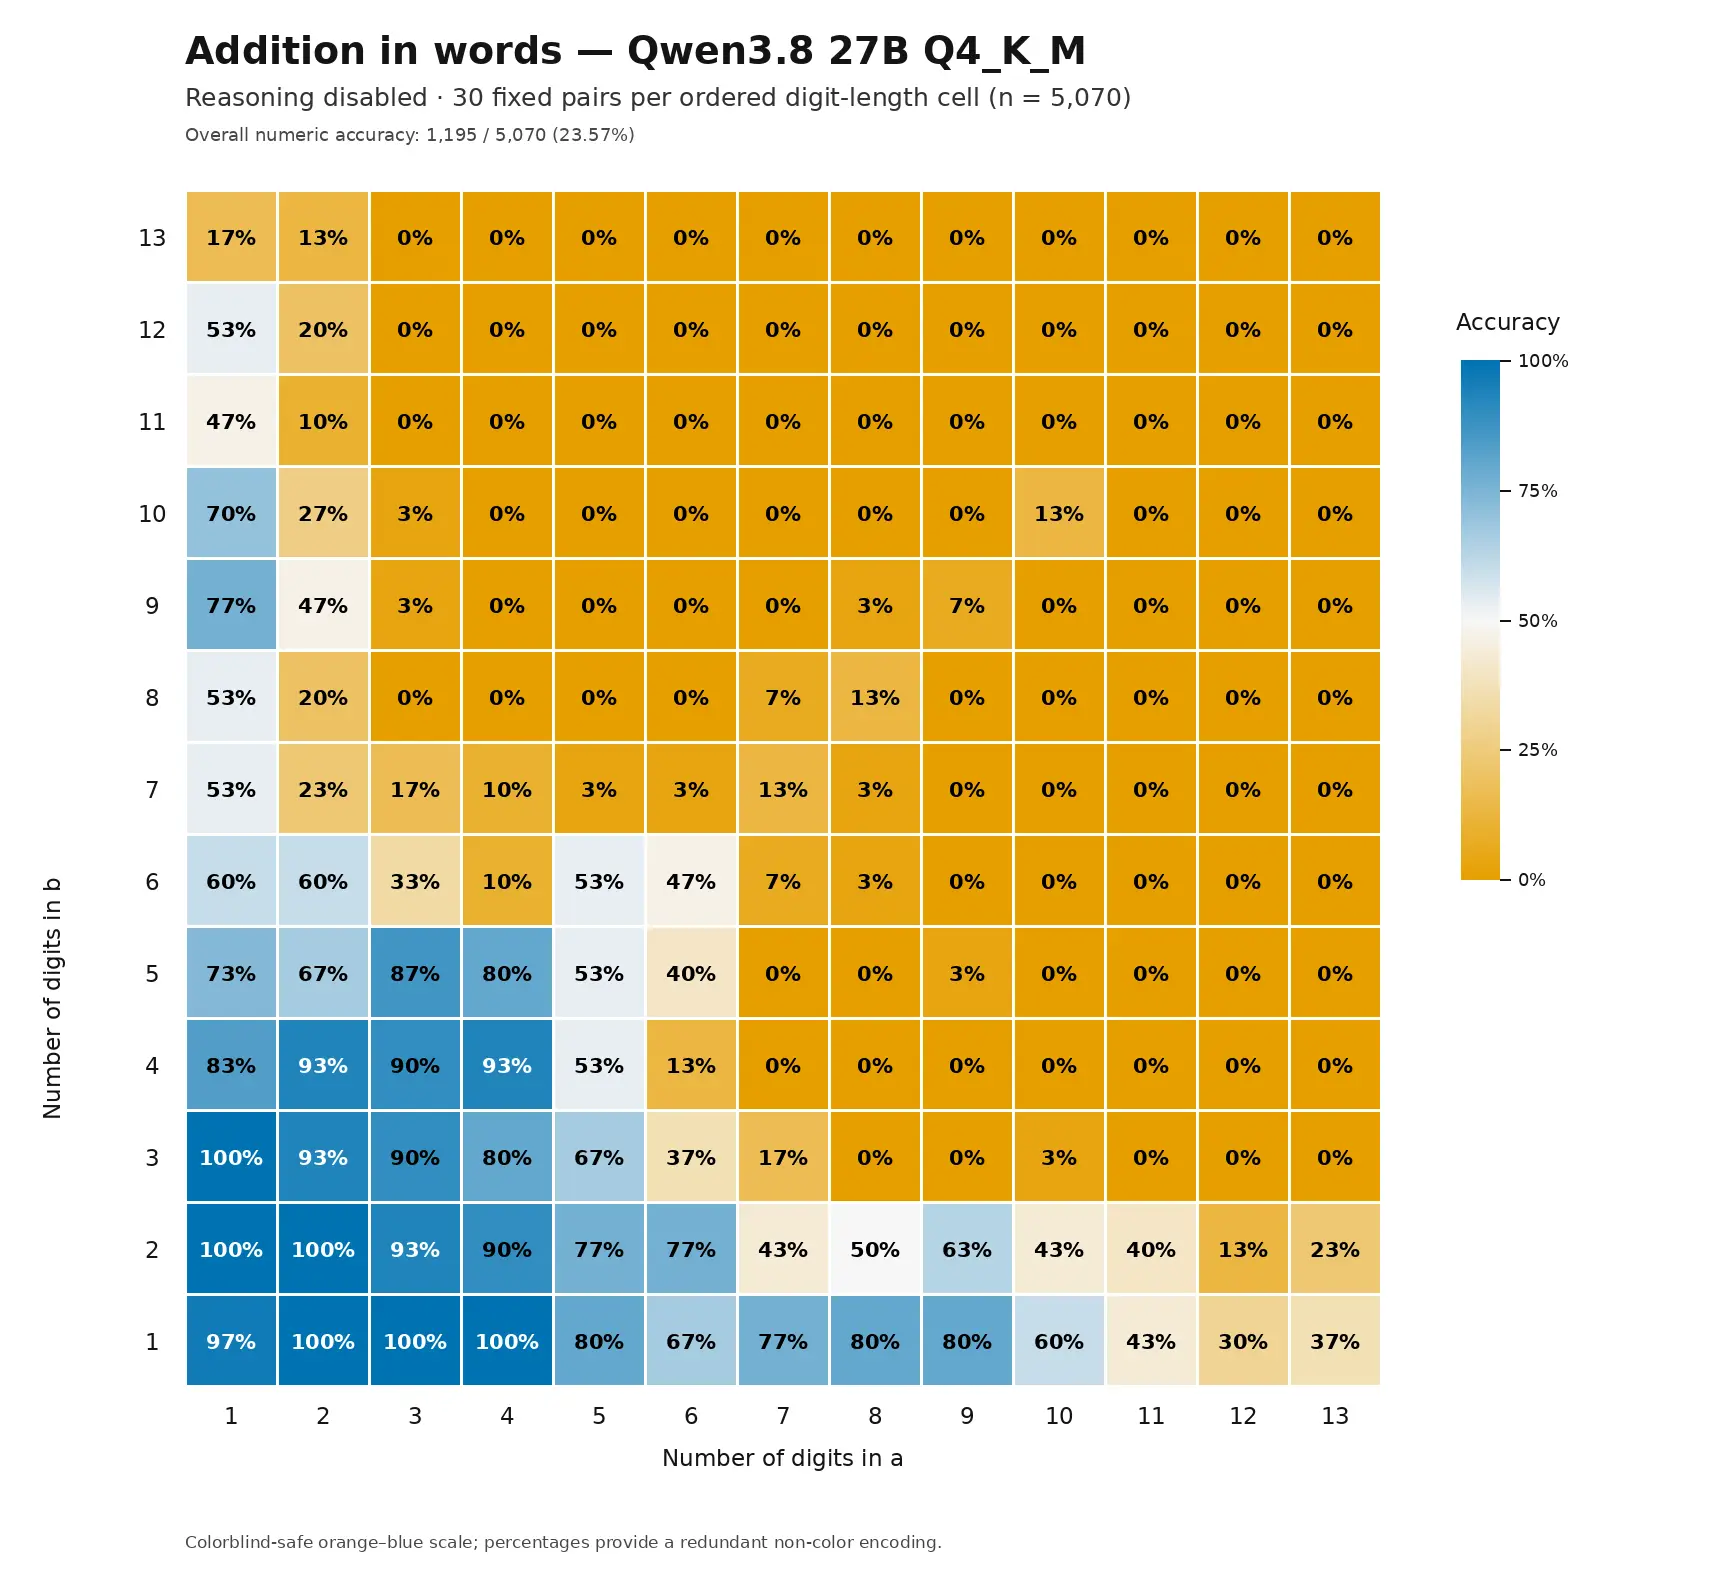
作者重現 Colin Frasier 的實驗,在本地 DGX Spark 硬體上測試 Qwen3.8-27B 模型對超大數字的加法能力。結果顯示啟用推理後,模型在 169 次嘗試中正確率極高,並能展示詳細的進位計算過程。
介紹 Meta 與華盛頓大學提出的 Context Language Models,取代傳統壓縮對話的方式,讓 AI 代理像編輯檔案般自行簡化舊輸出並保留關鍵資訊。透過本地測試驗證此方法如何避免總結導致資訊遺失,並探討字首快取等潛在問題。
※ 摘要僅根據標題與說明
展示 Nemotron 3.5 Lightning 模型在 DGX Spark 與 Station 上的本地執行實作,說明為何本地 AI 從有趣變為實用。
※ 摘要僅根據標題與說明
介紹斯坦福與 NVIDIA 研發的 CLM 系統一模型,透過對比學習將情境與行動嵌入單一空間以快速決策。影片拆解其訓練方式與在 DGX Spark 上的效能測試,說明其作為初篩工具的定位。
※ 摘要僅根據標題與說明
介紹 NVIDIA 推出的 Nemotron 3 Diarization 模型,用於處理批處理與即時語音分詞任務。透過實作示範,展示該模型如何精準識別誰說了什麼,並支援轉寫為文字或字幕格式。
※ 摘要僅根據標題與說明
探討 AI 是否必須依賴雲端,分析資料中心成本壓力與 NVIDIA 重押本地 AI 的策略。透過分享個人工作流程,說明為何越來越多 AI 任務可能回到個人電腦執行。
※ 摘要僅根據標題與說明
Ming-Yu Liu 介紹 NVIDIA Cosmos 3 如何整合視覺、語言與動作,透過單一模型模擬真實世界並訓練機器人政策。觀眾可學習如何利用神經模擬器進行政策驗證,加速開發速度並提升安全性。
※ 摘要僅根據標題與說明
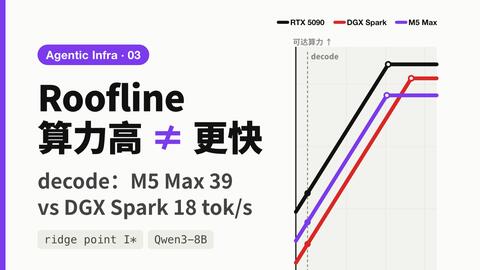
探討算力密度與 Roofline model,比較 5090、M5 max 與 DGX Spark 的效能,並分析 Qwen3-8B 的算力與記憶體存取特性。觀眾可透過影片了解不同硬體在生成式 AI 架構下的實際表現與選型考量。
※ 摘要僅根據標題與說明
介紹 Perplexity 與 NVIDIA 合作推出的本地化代理 AI 平台,可在 NVIDIA DGX Spark 上執行 Qwen 等模型。示範如何完全離線分析敏感檔案並診斷產品漏斗,無需雲端計費。
※ 摘要僅根據標題與說明
Matthew Berman 分享 Anthropic 最新發布的 Mythos 與 Fable 5.1 模型,展示其驚人的能力與應用場景。影片透過實際操作示範,讓觀眾了解這些模型如何處理複雜任務。
※ 摘要僅根據標題與說明
探討 OpenAI 新晶片 Jalapeno 的推論效能、蘋果 M6 與 M5 Ultra 晶片在 AI 個人電腦上的應用,以及 Meta 與美國檢察官達成和解的細節。觀眾可了解最新 AI 硬體趨勢、晶片效能比較及社群網路監管動態。
示範在 DGX Spark 伺服器上執行 Qwen 3.8 27B 模型,並結合 Agent Harness 與安全沙箱進行實機測試。觀眾可學習地端 AI 部署細節、模型量化方法與資安邊界設定。
※ 摘要僅根據標題與說明
Ray Fernando 透過 AMA 形式介紹本地 AI 工具,涵蓋 LocalStudio.ai、Herder.dev 與 Atomic Agent Runtime。
※ 摘要僅根據標題與說明
Alex Finn 分享他如何運用多台 Mac Studio、DGX Spark 與自組 RTX 5090 電腦,透過 OpenClaw 與 Hermes 建立全天候運作的本地 AI 軟體工廠。
探討 Olares 如何將 Kubernetes 與 HAMi 整合,打造端側 AI 工作站,解決單一機器上多工並行時的 GPU 資源衝突問題。
分享 DwarfStar 4 快速流行的原因,指出其結合大模型與 2/8 bit 量化技術,讓 96GB 記憶體即可執行。文章展望未來將支援更多領域專化模型與分散式推理,強調本地 AI 體驗的重要性。
深入解析 DeepSeek 最新提出的 mHC 架構,探討其如何最佳化殘差連線以解決深度模型訓練中的訊號衰減問題。內容涵蓋從殘差連線的歷史演進、Hyper-Connections 的技術突破,到 mHC 的實驗結果與潛在影響,幫助讀者理解…
依人氣
Matthew Berman 分享 Anthropic 最新發布的 Mythos 與 Fable 5.1 模型,展示其驚人的能力與應用場景。影片透過實際操作示範,讓觀眾了解這些模型如何處理複雜任務。
※ 摘要僅根據標題與說明
※ 摘要僅根據標題與說明
介紹斯坦福與 NVIDIA 研發的 CLM 系統一模型,透過對比學習將情境與行動嵌入單一空間以快速決策。影片拆解其訓練方式與在 DGX Spark 上的效能測試,說明其作為初篩工具的定位。
※ 摘要僅根據標題與說明
介紹 NVIDIA 推出的 Nemotron 3 Diarization 模型,用於處理批處理與即時語音分詞任務。透過實作示範,展示該模型如何精準識別誰說了什麼,並支援轉寫為文字或字幕格式。
※ 摘要僅根據標題與說明
探討 Olares 如何將 Kubernetes 與 HAMi 整合,打造端側 AI 工作站,解決單一機器上多工並行時的 GPU 資源衝突問題。
作者重現 Colin Frasier 的實驗,在本地 DGX Spark 硬體上測試 Qwen3.8-27B 模型對超大數字的加法能力。結果顯示啟用推理後,模型在 169 次嘗試中正確率極高,並能展示詳細的進位計算過程。
分享 DwarfStar 4 快速流行的原因,指出其結合大模型與 2/8 bit 量化技術,讓 96GB 記憶體即可執行。文章展望未來將支援更多領域專化模型與分散式推理,強調本地 AI 體驗的重要性。
介紹 Meta 與華盛頓大學提出的 Context Language Models,取代傳統壓縮對話的方式,讓 AI 代理像編輯檔案般自行簡化舊輸出並保留關鍵資訊。透過本地測試驗證此方法如何避免總結導致資訊遺失,並探討字首快取等潛在問題。
※ 摘要僅根據標題與說明
展示 Nemotron 3.5 Lightning 模型在 DGX Spark 與 Station 上的本地執行實作,說明為何本地 AI 從有趣變為實用。
※ 摘要僅根據標題與說明