看影片(在新分頁開啟原站)連到 Bilibili・五道口纳什
摘要
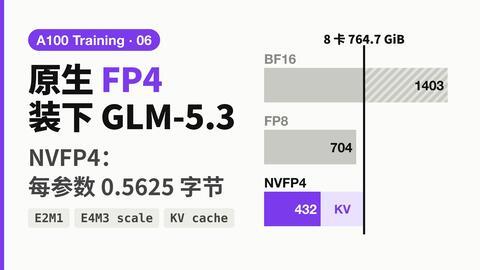
介紹如何使用 NVFP4、E2M1 量化與 KV cache 技術,在 8 卡 RTX Pro 6000 上執行 GLM-5.3 模型。觀眾可學習如何最佳化硬體資源以在有限算力下部署大型語言模型。
This video demonstrates running GLM-5.3 on 8 RTX Pro 6000 cards using NVFP4, E2M1, and KV cache optimizations.
這筆內容還沒有取得字幕或內文,這段摘要只根據標題與說明欄產生,可能不夠準確;實際內容請以原站為準。
提到的工具與公司
- GLM-5.3
- RTX Pro 6000
- NVFP4
- E2M1
適合誰看
適合具備程式基礎且正在進行大模型部署或量化實作的開發者。
摘要依據
- 講者
- 五道口納什
- 依據
- 標題與說明欄(還沒有取得字幕或內文)
為什麼排在這裡
- 人氣
- 0.44
- 新鮮
- 0.99
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Product Updates: RTX Pro 6000 Blackwell, Command K, Sandbox FS API and more文章 ・ Modal Blog
- From Day 0 to Production SLAs: Serving GLM-5.2 on 24 NVIDIA B300 GPUs with vLLM文章 ・ vLLM Blog
- I Plugged RTX Pro 6000 Into a Strix Halo... Didn’t Expect This影片 ・ Alex Ziskind ・ 14 分鐘
- GLM 5.3 Optimizations, Part 1: Hybrid HiSparse Offloading in vLLM文章 ・ vLLM Blog
- Stanford CS336 Language Modeling from Scratch | Spring 2026 | Guest Lecture: Dan Fu影片 ・ Stanford Online ・ 1 小時 12 分
- How AI Models Scale Beyond a Single GPU Across LLM Workloads影片 ・ IBM Technology ・ 9 分鐘
摘要由 AI 根據標題與說明欄產生(還沒有取得原文),可能有誤;完整內容請看原站。看影片(在新分頁開啟原站)