讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
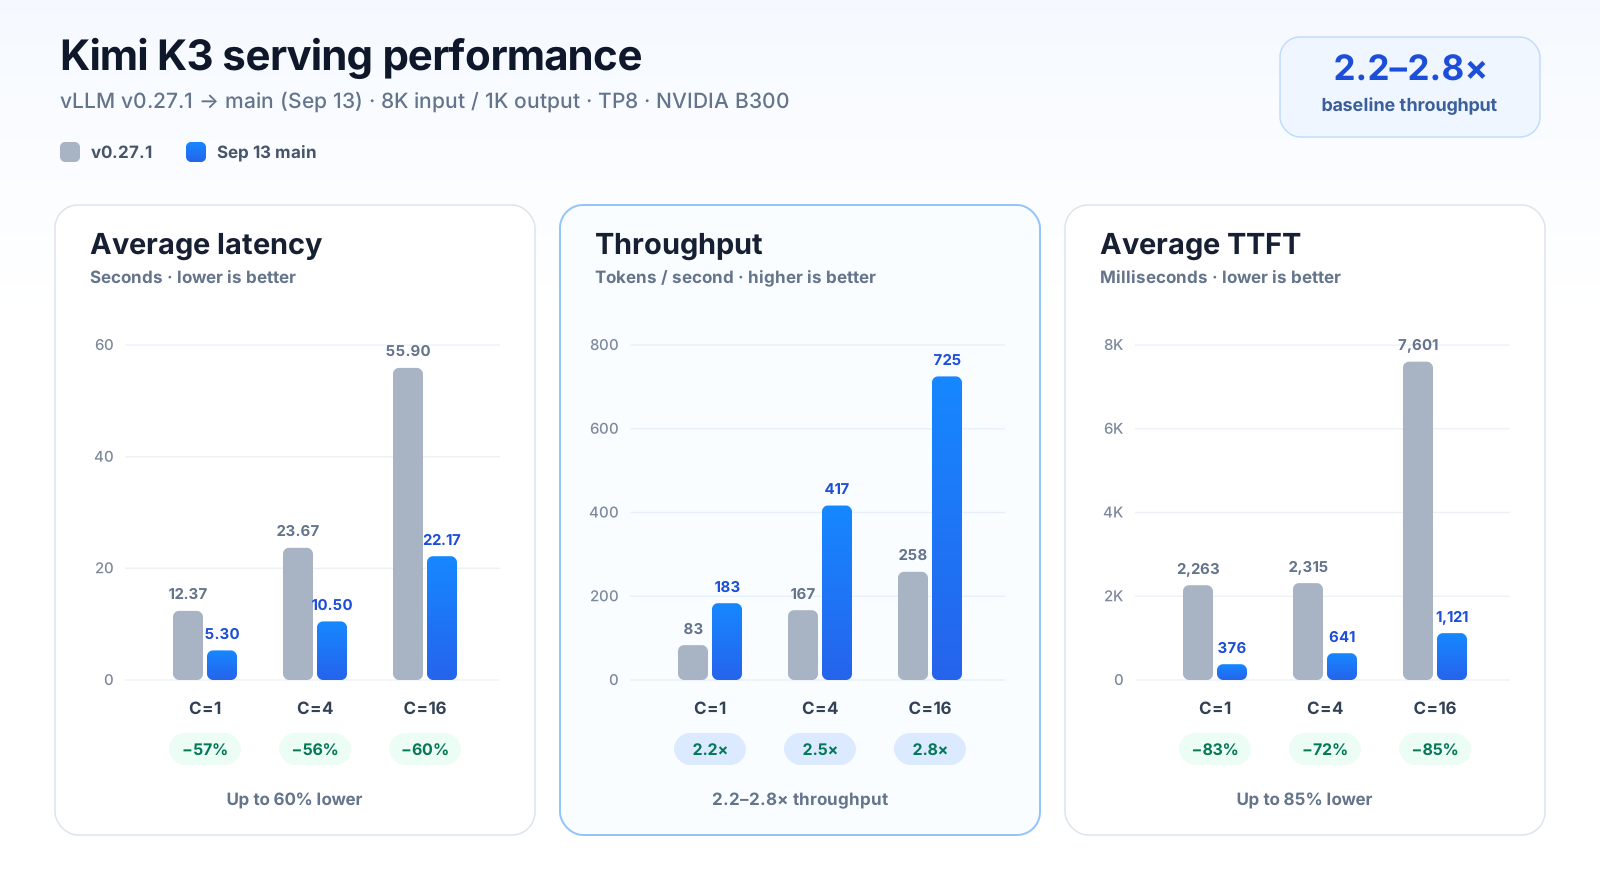
介紹 Kimi K3 在 vLLM 中的效能最佳化,透過排程、KDA 字首快取、零複製批次與延遲化計算等技術,將吞吐量提升 2.8 倍。讀者可了解如何解決 Mamba 架構的瓶頸並提升推理效率。
Details performance optimizations in vLLM for Kimi K3, achieving 2.8x throughput via scheduling, caching, and parallelism techniques.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 透過動態排程預算與零複製批次最佳化,大幅降低延遲並提升吞吐量。
- 引入 ReplaySSM 與字首快取檢查點,減少重複計算與狀態寫入。
- 利用解耦與上下文並行技術,顯著擴大快取容量並加速長上下文處理。
提到的工具與公司
適合誰看
正在開發或最佳化大型語言模型推理系統、熟悉 vLLM 與 Mamba 架構的開發者。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.90
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)