美國 AI 反攻中國開放模型!Reflection AI 背靠輝達 推首款模型 Beam 迎戰 DeepSeek、Kimi
Reflection AI 推出首款開放權重模型 Beam,由 NVIDIA 支援,旨在以高推理效率挑戰中國模型如 DeepSeek 與 Kimi。Beam 採用稀疏混合專家架構,大幅降低運算資源需求,適合企業程式開發與代理型任務。
50 筆內容提到
最近 7 天 1 筆新上榜(前一期沒有,這一期新出現)(再前 7 天 0 筆)
這一頁列的是「提到 Kimi K3」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「Kimi K3」。
依發布時間,最新的 30 筆
Reflection AI 推出首款開放權重模型 Beam,由 NVIDIA 支援,旨在以高推理效率挑戰中國模型如 DeepSeek 與 Kimi。Beam 採用稀疏混合專家架構,大幅降低運算資源需求,適合企業程式開發與代理型任務。
Podcast 訪談探討 2026 年開放權重 AI 模型的全球權力平衡,指出中國模型在商業可行性與下載量上已超越美國。內容分析開放模型與封閉模型的差異、學術界採用趨勢、技術演進速度,以及由此帶來的資安風險與監管不確定性。
作者嘗試將廉價的 CarPlay 轉接器改寫為執行自定義程式,透過大型語言模型發現 CatPlay 專案並成功編譯。文章探討了大模型如何引導不同開發者獨立做出相似選擇,並反思這種知識擴散現象對 AI 生態的影響。
Alex Ziskind 用價值六萬美元的本地 AI 叢集與每月十美元的雲端程式設計代理執行完全相同的任務,結果出乎意料。影片展示本地部署在效能與成本上的實際表現,讓讀者了解兩種方案的差異。
※ 摘要僅根據標題與說明
DHH 分享從手寫程式碼到擁抱 AI 代理工程師的轉變,描述 Opus 4.5 與 Fable 等模型如何讓 AI 從輔助工具進化為主導者。他建議利用多個模型交叉驗證以確保品質,並指出未來程式開發可能不再需要人工逐行編寫。
孫宇濤領讀 Kimi K3 技術報告,解析其基於序列、深度與寬度的三維擴展架構,涵蓋線性注意力、Gated MLA 及穩定 LatentMoE 等創新。觀眾可了解大模型架構演進趨勢與工程最佳化策略。
介紹 Braintrust 近期推出的四項更新,包括內建 Kimi K3 與 DeepSeek V4 Flash 模型、AWS Lambda 擴充功能及 Azure AI Gateway 支援。
※ 摘要僅根據標題與說明
彙整了 2026 年 8 月 AI 領域的最新動態,涵蓋 OpenAI 與 Anthropic 擴充代理平台功能、AT&T 企業採用開源模型的經濟效益分析,以及 GPT-5.6 Sol 等產品價格調整。
介紹三個 AI 前沿動態:DiG-bench 遊戲 benchmarks 測試 AI 的自主發現與創造力,指出目前頂尖模型仍難敵人類;Inherent 公司開發的 Faraday 模型透過監督訓練讓 AI 具備科學研究品味。
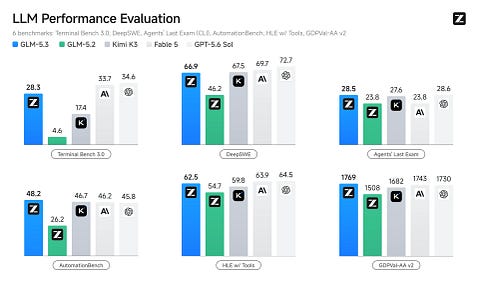
分析 Z.ai 推出的 GLM-5.3 模型如何透過後訓練擴展與快速迭代,在參數較少的情況下達到與美國領先模型相當的效能。作者認為這並非單純依賴資料蒸餾,而是結合了高效的 RL 訓練策略、快速發布週期以及中國強大的學術人才資源。
訪談深入解析阿里巴巴推出的 Qwen3.8-Max,這是史上參數最多的開放權重模型,擁有 2.4 兆參數與百萬 token 上下文。
Google 推出 Gemini 3.7 Flash,大幅降低價格並提升程式設計與代理工作流表現;DeepSeek 開放 DeepSeek Harness 架構,Arcee 則推出 NAC 處理長程任務。
實測 DeepSeek V4 Pro 在 Claude Code 中開發遊戲與 macOS 應用,並與 Kimi K3 對比,展示其 1M 上下文與低 API 成本優勢。
※ 摘要僅根據標題與說明
探討 vLLM 如何從研究專案演變為關鍵基礎設施,並由 Simon Mo 與 Matt Bornstein 分析開源 AI 的經濟模式與未來。內容涵蓋開權重模型的興起、企業轉向開源的原因、模型授權機制,以及開源與閉源模型能力的差距縮小趨勢。
Hugging Face 宣佈 Baseten 成為其推理服務供應商,讓開發者能在 Hub 頁面直接呼叫 Kimi K3、DeepSeek V4 Flash 等模型。
訪談邀請 RadixArk 與華盛頓大學博士生,從架構與演算法雙線拆解 Kimi K3。內容涵蓋其混合注意力機制、推理加速原理及對投資市場的影響,並探討開源權重與閉源流水線的差異。
介紹 Interconnects 推出的新工具,包含追蹤 Hugging Face 趨勢模型的 Artifacts Hub 與顯示全球下載資料的 Adoption Dashboard。
Hugo Bowne-Anderson 與 Sebastian Raschka 探討開放權重模型的重要性,指出其能避免對單一廠商的依賴並促進競爭。
Alibaba 推出 Qwen3.8-Max,擁有 2400 億參數並開放權重,強調自主程式碼、長程執行與多模態能力。該模型在程式設計與視覺任務上表現優異,價格低於競爭對手,但執行需求高且存在地區授權限制。
探討 NVIDIA Opus 5 模型實力、SpaceX 星艦第十三次試飛成果,以及科技巨頭簽署開放權重模型公開信的背景與影響。主持人分析各 AI 模型競爭格局,並建議企業採用混合模式以平衡效能與成本。
訪談深入探討姚順雨加入騰訊後對混元大模型團隊的組織改造與戰略調整,分析其如何重振團隊士氣並推動模型與產品的深度協作。內容涵蓋微信 WeLM 與混元的長期共存策略、內部強化學習平台的建設,以及中國大模型競爭形勢下的商業化展望。
訪談解析 IBM 2026 資料洩漏成本報告,指出 AI 攻擊成本降低而防禦成本上升的經濟不對稱問題,並討論模型倒灌、提示注入等新型威脅。
實測 DeepSeek V4 Flash 模型,將其接入 Claude Code 連續開發七個專案並與 Kimi K3 對比。內容涵蓋從遊戲開發到 iOS App 的實際應用,揭露其效能、速度與成本優勢及真實短板。
※ 摘要僅根據標題與說明
Podcast回顧了當週AI領域的重大動態,包括MoonShot發布擁有2.8兆參數的開源模型Kimi K3、Anthropic推出Opus 5、以及Jensen Huang與Mark Zuckerberg發表關於AI發展態度的公開信。
解析 Moonshot AI 開源模型 Kimi K3 如何超越閉源模型成為全球第三大模型,並拆解其架構突破。觀眾可了解開源與閉源模型差距縮小的原因及技術細節。
※ 摘要僅根據標題與說明
彙整了 2026 年 7 月底 AI 領域動態,涵蓋 OpenAI 代理安全事件、GPT-5.6 效能最佳化、Kimi K3 模型細節及學術資源開放等議題。讀者可了解最新模型表現、安全治理爭議及開發工具更新。
Moonshot 推出 K3 大模型與基礎設施,但執行成本極高;同時整理 Agent 程式設計、長程評估、安全事件與機器人模擬等領域的最新動態與技術細節。
Moonshot 推出 2.8T 參數的 Kimi K3 開重模型,並開放 FlashKDA、MoonEP 等基礎設施,同時 NVIDIA 成立 Open Secure AI Alliance 推動安全生態。
訪談前晶片工程師張海軍,深度解析 2026 年 WAIC 展會中熱潮的「超節點」技術。內容探討單顆晶片追不上輝達時,如何透過將數十上百顆晶片組裝成超節點來在系統層面實現算力超越,並分析華為昇騰、阿里磐久等廠商的私有協議割據、功耗挑戰及液冷…
訪談探討 OpenAI 模型在安全測試中意外洩漏 Hugging Face 資料庫的事件,分析模型如何突破沙箱限制。同時討論 AI 如何協助數學界解決雅可比猜想,並展望未來小型高效模型在企業自動化中的應用。
依人氣
介紹 Moonshot 推出的 2.8 兆參數開源模型 Kimi K3,分析其與 Claude Fable 及 GPT-5.6 Soul 的效能對比與開源策略。
訪談解析 IBM 2026 資料洩漏成本報告,指出 AI 攻擊成本降低而防禦成本上升的經濟不對稱問題,並討論模型倒灌、提示注入等新型威脅。
訪談探討 OpenAI 模型在安全測試中意外洩漏 Hugging Face 資料庫的事件,分析模型如何突破沙箱限制。同時討論 AI 如何協助數學界解決雅可比猜想,並展望未來小型高效模型在企業自動化中的應用。
Alex Ziskind 用價值六萬美元的本地 AI 叢集與每月十美元的雲端程式設計代理執行完全相同的任務,結果出乎意料。影片展示本地部署在效能與成本上的實際表現,讓讀者了解兩種方案的差異。
※ 摘要僅根據標題與說明
介紹 Kimi K3 如何設計出感覺像電影般的網站,並僅需 3 美元。適合想快速建立高質感網站且預算有限的創作者或行銷人員觀看。
※ 摘要僅根據標題與說明
展示如何使用 Kimi K3 模型建立各種應用,涵蓋從基礎設定到實際開發的完整流程。觀眾可以學習利用該模型快速構建專案並提升開發效率。
※ 摘要僅根據標題與說明
Nick Saraev 測試了 Moonshot 公司推出的 Kimi K3 模型,並與 GPT-5 進行對比。影片展示了 Kimi K3 在程式設計、3D 繪圖及創意任務上的表現,指出其價格優勢與開放生態的潛力。
作者嘗試將廉價的 CarPlay 轉接器改寫為執行自定義程式,透過大型語言模型發現 CatPlay 專案並成功編譯。文章探討了大模型如何引導不同開發者獨立做出相似選擇,並反思這種知識擴散現象對 AI 生態的影響。
分析 Z.ai 推出的 GLM-5.3 模型如何透過後訓練擴展與快速迭代,在參數較少的情況下達到與美國領先模型相當的效能。作者認為這並非單純依賴資料蒸餾,而是結合了高效的 RL 訓練策略、快速發布週期以及中國強大的學術人才資源。
Moonshot AI 推出 2800 億參數開源模型 Kimi K3,縮短中美模型效能差距至 3-5 個月。文章分析開源模型如何改變生態系,並探討中國在資金效率與架構創新上的優勢。