讀原文(在新分頁開啟原站)連到 Eugene Yan(部落格)
摘要
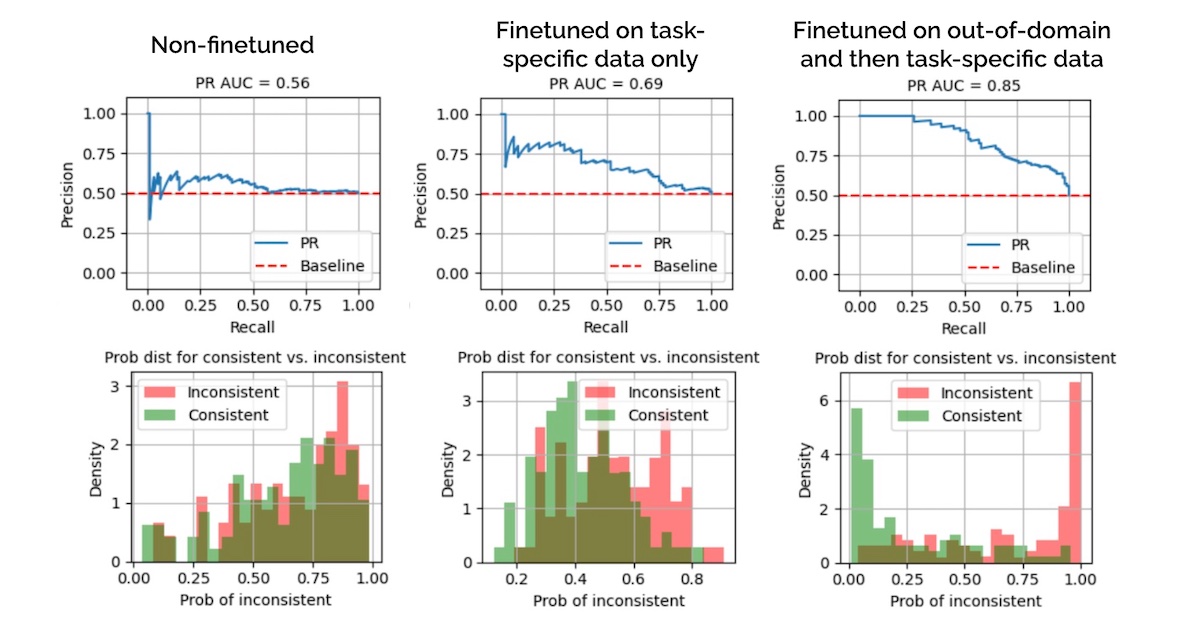
探討如何利用外域資料(如維基百科摘要)進行預訓練,來提升對新聞摘要中事實不一致(即謠言)的檢測能力。作者發現,即使預訓練階段在相關領域(維基百科)上只進行了少量訓練,也能顯著改善後續在特定任務(FIB)上的表現,從而減少需要收集大量標註資料的負擔。
This article explores using out-of-domain data, such as Wikipedia summaries, for pre-training to enhance factual inconsistency detection in news summaries. The author finds that even a small amount of pre-training on related data significantly improves performance on downstream tasks, reducing the '
重點
- 使用外域資料(如維基百科)進行預訓練,可顯著提升事實不一致檢測的準確率。
- 透過預訓練模型,即使僅在少量外域資料上訓練,也能有效改善後續任務的表現。
- 利用自然語言推理(NLI)任務,將摘要與源文比較以識別矛盾內容。
提到的工具與公司
- BART
- QLoRA
- NLI
- FIB
- USB
- XSUM
適合誰看
研究大語言模型(LLM)評估、自然語言處理(NLP)及機器學習的開發者。
摘要依據
- 講者
- Eugene Yan
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.02
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Extrinsic Hallucinations in LLMs文章 ・ Lilian Weng(部落格)
- Learning with not Enough Data Part 3: Data Generation文章 ・ Lilian Weng(部落格)
- How to Generate and Use Synthetic Data for Finetuning文章 ・ Eugene Yan(部落格)
- Few-Shot Learning (3/3):Pretraining + Fine Tuning影片 ・ Shusen Wang ・ 19 分鐘(在新分頁開啟原站)
- Privacy Backdoors: Stealing Data with Corrupted Pretrained Models (Paper Explained)影片 ・ Yannic Kilcher ・ 1 小時 4 分(在新分頁開啟原站)
- You Are Being Told Contradictory Things About AI影片 ・ AI Explained ・ 20 分鐘(在新分頁開啟原站)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)