文章高階EN
Exploring Claude/GPT Knowledge Cutoffs & Pre-training Timelines
讀原文(在新分頁開啟原站)連到 Shrivu Shankar(Shrivu's Substack)
摘要
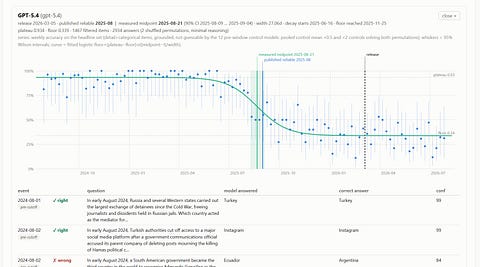
透過設計特定問題測試大型語言模型,推估其預訓練時間點、知識截止日與訓練資料組成。讀者可了解如何分析模型行為來窺探其訓練過程,並掌握不同模型版本間知識與身份的差異。
This article analyzes how to probe large language models to estimate their training timelines and knowledge cutoffs.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 透過設計特定問題測試大型語言模型,推估其預訓練時間點。
- 分析模型回答日期與身份問題,窺探其訓練資料來源。
- 比較不同模型版本,了解知識截止日與訓練策略差異。
適合誰看
對機器學習原理、大模型訓練機制或 AI 技術分析有興趣的研究者與開發者。
摘要依據
- 講者
- Shrivu Shankar
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.79
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Build an LLM from Scratch 7: Instruction Finetuning影片 ・ Sebastian Raschka ・ 1 小時 46 分
- Going In Deep On Data | YC Paper Club影片 ・ Y Combinator ・ 53 分鐘
- Notes on Midtraining文章 ・ Deep (Learning) Focus(Cameron R. Wolfe)
- 【生成式AI導論 2024】第6講:大型語言模型修練史 — 第一階段: 自我學習,累積實力 (熟悉機器學習的同學從 15:00 開始看起即可)影片 ・ Hung-yi Lee ・ 34 分鐘
- How are large language models trained?影片 ・ Google for Developers ・ 10 分鐘
- AI 原生思维——像训练大模型一样训练自己文章 ・ 寶玉
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)