1文章進階EN
How I Use Every Claude Code Feature
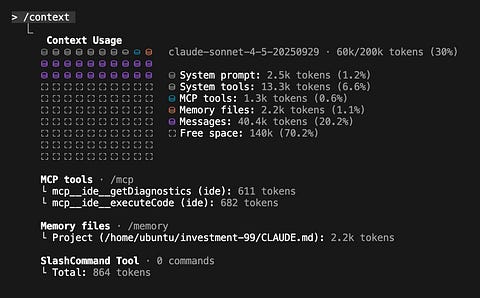
分享個人使用 Claude Code 的實戰經驗,涵蓋從 CLAUDE.md 設定、自訂指令到 GitHub Actions 的完整工作流。讀者可學習如何建立高效能 AI 程式設計環境、最佳化提示詞策略以及利用 SDK 進行大規模自動化。
部落格 ・ 國際 ・ 英文 ・ A 級 ・ 13 筆內容 ・ 最近更新 2026/09/08
把 Claude Code 每個功能怎麼用、agent 安全、harness 設計寫成可照做的長文;產量不高但每篇都是實戰
依人氣
分享個人使用 Claude Code 的實戰經驗,涵蓋從 CLAUDE.md 設定、自訂指令到 GitHub Actions 的完整工作流。讀者可學習如何建立高效能 AI 程式設計環境、最佳化提示詞策略以及利用 SDK 進行大規模自動化。
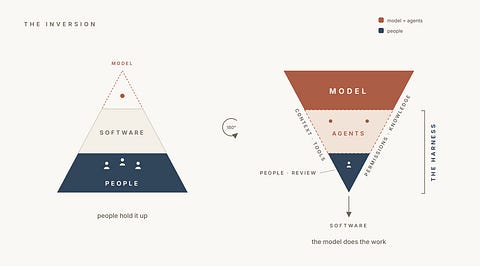
提出 SaaS 企業將轉變為以 AI 模型為核心的「Harness( harness )」,透過編排代理自動執行開發、產品與銷售任務。作者認為公司應掌握頂層編排邏輯,將人類置於關鍵判斷點,以維持產品品質與競爭優勢。
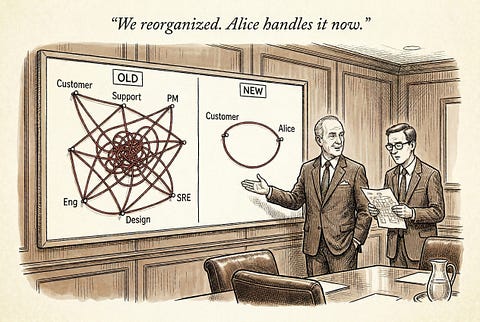
提出「CompanyT」組織架構,主張企業應依問題解決的完整迴圈(loops)而非傳統職能來編排人才。透過 AI 代理處理執行細節,讓每位迴圈負責人能從問題發現到方案部署全權負責,縮短溝通成本並提升 accountability。
探討在 AI 能處理大部分執行任務後,人類如何從「執行者」轉變為「品味提取者」。作者認為品味不再是永久的護城河,而是會衰減的優勢,關鍵在於如何將隱性的判斷轉化為系統可理解的明確規則,以維持競爭力。
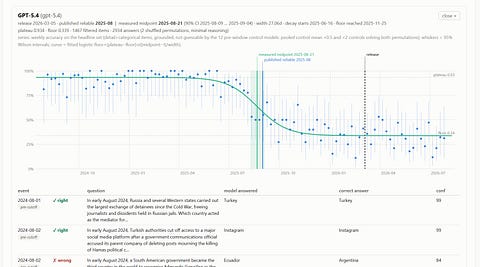
透過設計特定問題測試大型語言模型,推估其預訓練時間點、知識截止日與訓練資料組成。讀者可了解如何分析模型行為來窺探其訓練過程,並掌握不同模型版本間知識與身份的差異。
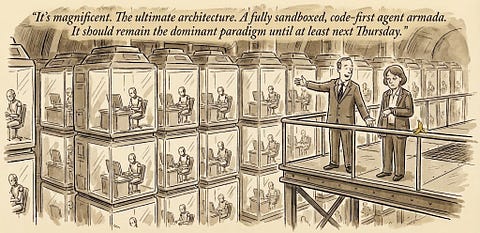
探討 2026 年多代理系統架構的演進,指出核心趨勢是透過程式碼執行沙盒解決非程式化問題,並轉向「情境工程」而非單純提示詞設計。讀者可學習規劃與執行代理的迴圈模式、虛擬機器工具設計原則,以及應對長時程任務的策略。
指出 AI 僅能帶來 10-20% 的產出提升,要達成 10 倍效果需同步改變個人練習與組織設計。作者強調必須「左移」審查、閉合迴圈驗證、建立可重用的技能庫,並重新組織團隊以消除交接瓶頸,否則 AI 只會加速低品質產出。
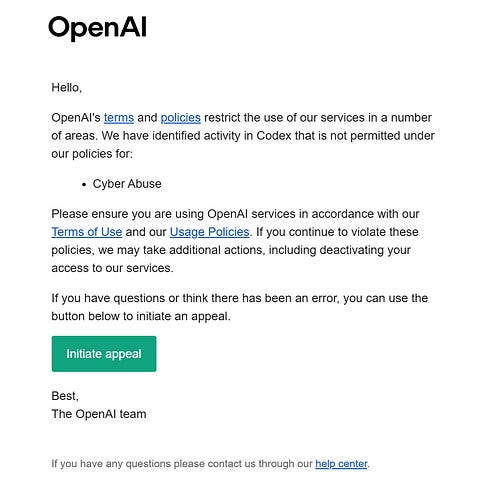
作者讓一百個經過「abliteration」處理的開源 AI 代理嘗試駭入他的線上帳號,結果成功透過軟體漏洞、密碼暴力破解及社會工程學取得部分舊專案或帳號的存取權。文章探討了自主 AI 代理的攻擊能力、成本分析與未來安全風險。
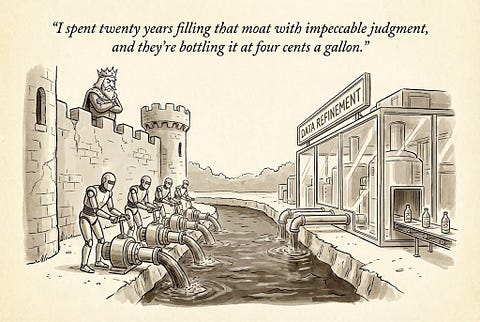
提出軟體開發正從靜態程式碼轉向以「意圖」為核心的動態生成模式,認為未來程式碼只是暫存意圖的快取。文章描述了從傳統 SaaS 到 AI 訓練環境的五個進化階段,探討了代理(Agent)如何取代介面,以及企業資料如何被精煉為模型直覺。
依發布時間
作者讓一百個經過「abliteration」處理的開源 AI 代理嘗試駭入他的線上帳號,結果成功透過軟體漏洞、密碼暴力破解及社會工程學取得部分舊專案或帳號的存取權。文章探討了自主 AI 代理的攻擊能力、成本分析與未來安全風險。
提出 SaaS 企業將轉變為以 AI 模型為核心的「Harness( harness )」,透過編排代理自動執行開發、產品與銷售任務。作者認為公司應掌握頂層編排邏輯,將人類置於關鍵判斷點,以維持產品品質與競爭優勢。
分享 2026 年使用 AI 進行程式設計、寫作、學習與個人助理的實戰經驗,強調將工作左移並使用動態工作流。讀者可學習如何設定高效 AI 工作環境、利用 frontier 模型進行專案開發與知識轉化,並掌握控制成本的方法。
透過設計特定問題測試大型語言模型,推估其預訓練時間點、知識截止日與訓練資料組成。讀者可了解如何分析模型行為來窺探其訓練過程,並掌握不同模型版本間知識與身份的差異。
介紹如何建立以 AI 驅動的「軟體工廠」,讓系統自動處理需求、編寫、測試與部署,僅在關鍵節點由人類介入。讀者可學習如何設計合約、設定測試階層與建立反饋迴路,提升軟體開發效率。
指出 AI 僅能帶來 10-20% 的產出提升,要達成 10 倍效果需同步改變個人練習與組織設計。作者強調必須「左移」審查、閉合迴圈驗證、建立可重用的技能庫,並重新組織團隊以消除交接瓶頸,否則 AI 只會加速低品質產出。
提出「CompanyT」組織架構,主張企業應依問題解決的完整迴圈(loops)而非傳統職能來編排人才。透過 AI 代理處理執行細節,讓每位迴圈負責人能從問題發現到方案部署全權負責,縮短溝通成本並提升 accountability。
探討在 AI 能處理大部分執行任務後,人類如何從「執行者」轉變為「品味提取者」。作者認為品味不再是永久的護城河,而是會衰減的優勢,關鍵在於如何將隱性的判斷轉化為系統可理解的明確規則,以維持競爭力。
探討 2026 年多代理系統架構的演進,指出核心趨勢是透過程式碼執行沙盒解決非程式化問題,並轉向「情境工程」而非單純提示詞設計。讀者可學習規劃與執行代理的迴圈模式、虛擬機器工具設計原則,以及應對長時程任務的策略。
提出軟體開發正從靜態程式碼轉向以「意圖」為核心的動態生成模式,認為未來程式碼只是暫存意圖的快取。文章描述了從傳統 SaaS 到 AI 訓練環境的五個進化階段,探討了代理(Agent)如何取代介面,以及企業資料如何被精煉為模型直覺。
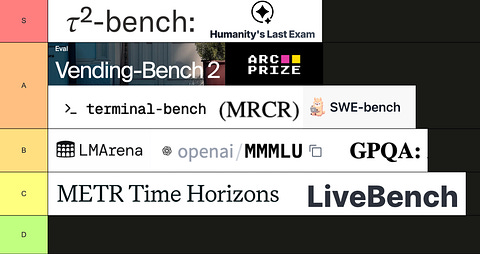
深入解析 AI 評測指標的運作機制與常見誤區,說明模型分數受設定、工具與評分方式影響極大。作者分析多個熱門評測(如 SWE-Bench、LMArena),指出其潛在偏差與侷限,教導讀者如何更客觀地評估模型真實能力。
分享個人使用 Claude Code 的實戰經驗,涵蓋從 CLAUDE.md 設定、自訂指令到 GitHub Actions 的完整工作流。讀者可學習如何建立高效能 AI 程式設計環境、最佳化提示詞策略以及利用 SDK 進行大規模自動化。