讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
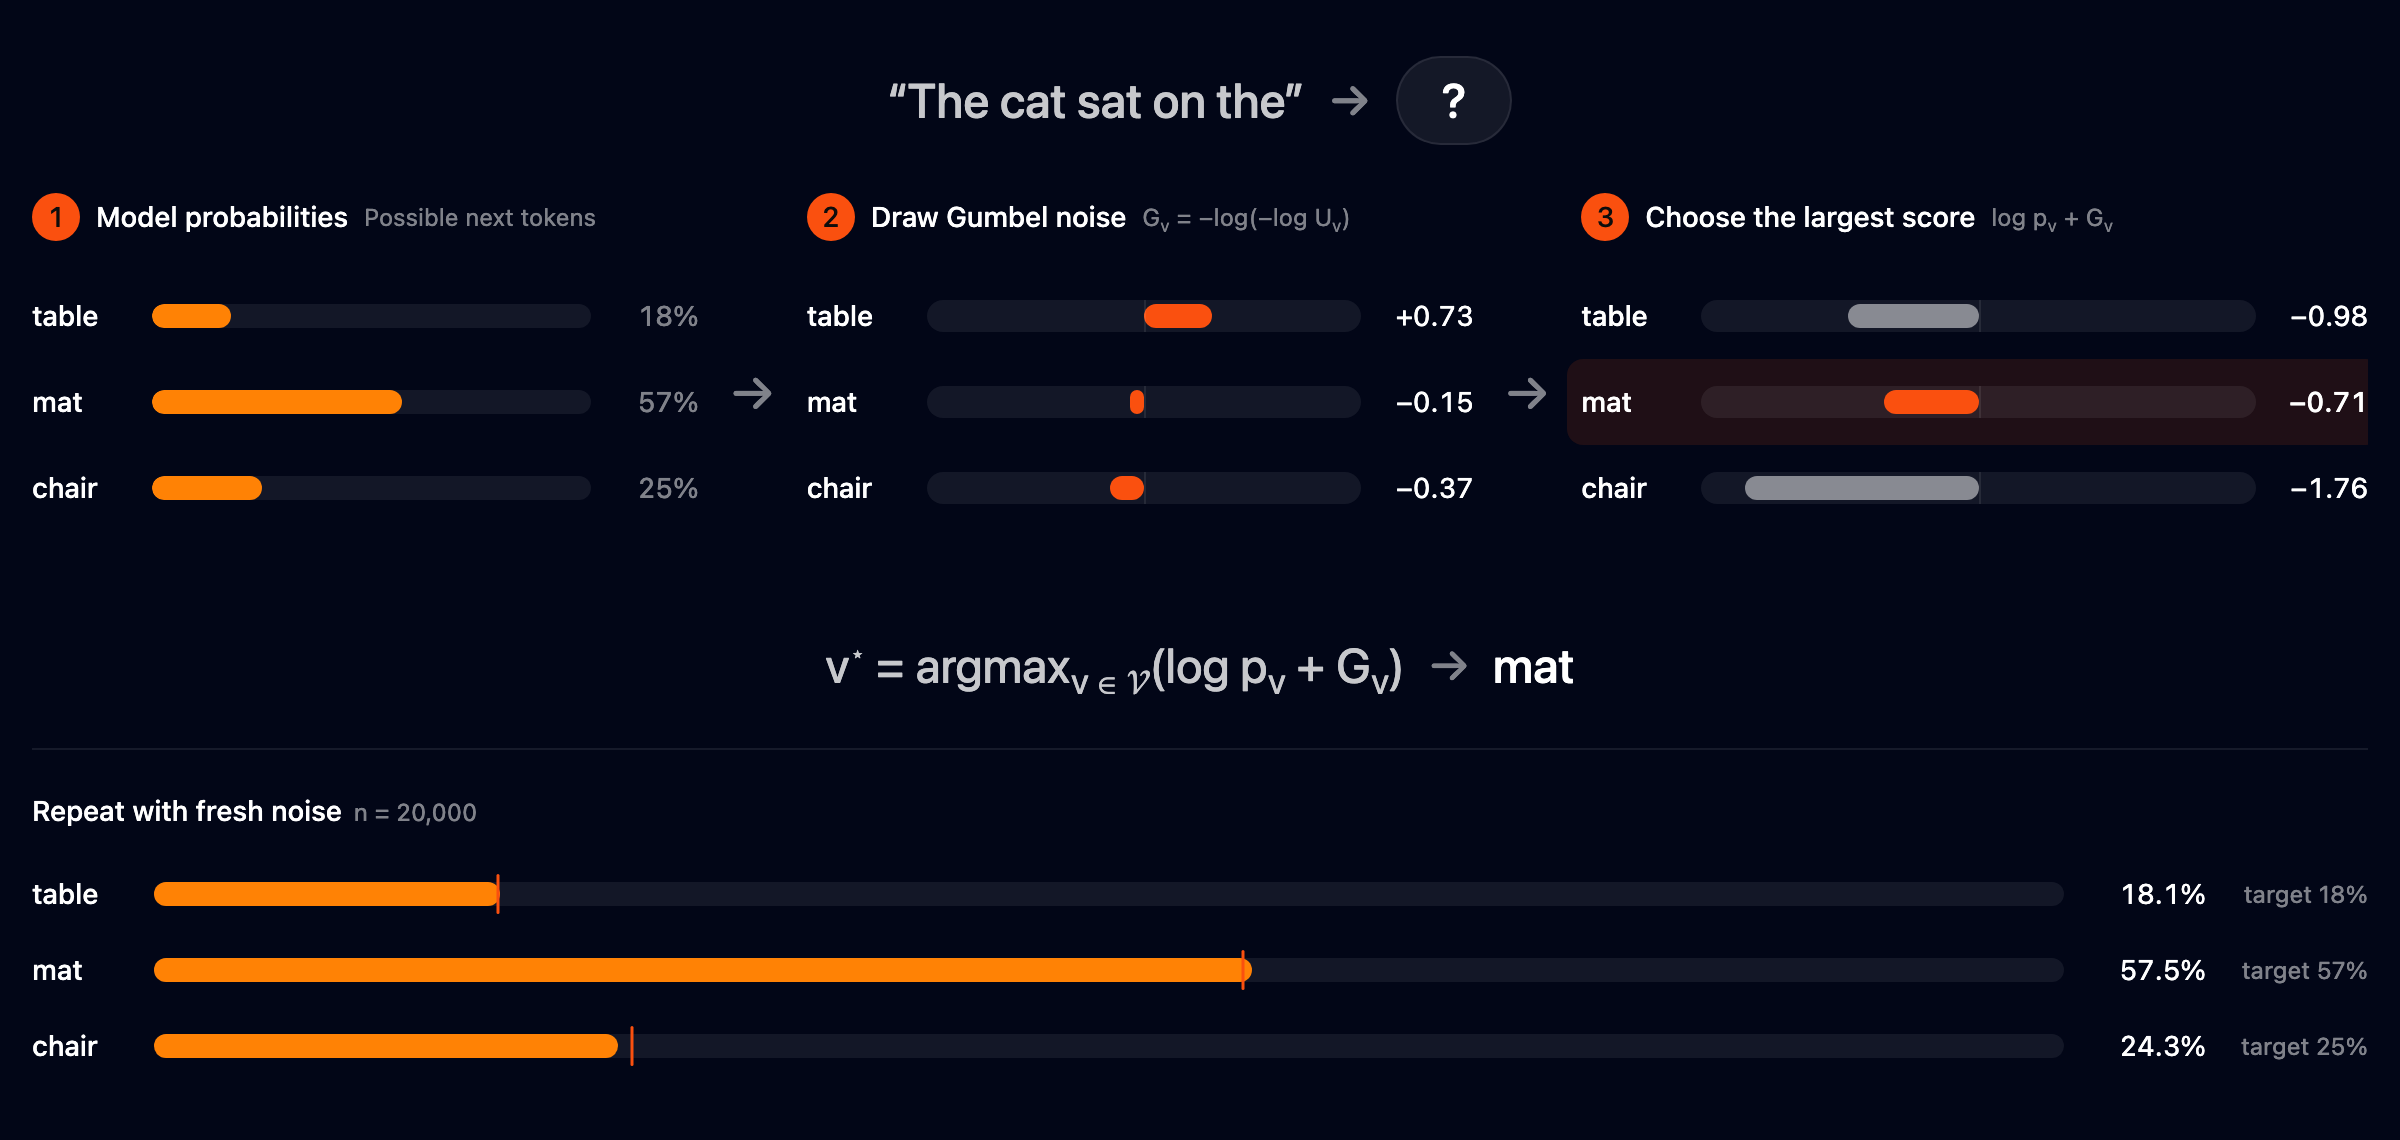
介紹 vLLM 如何透過 Gumbel-max 技巧與高效 GPU 核,在不改變模型輸出分佈的前提下實現文字水印。讀者可了解其原理、檢測機制及與推測解碼的整合方式,並掌握效能影響與挑戰的解決方案。
This article explains how vLLM implements distortion-free text watermarking using the Gumbel-max trick and efficient GPU kernels while supporting speculative decoding and maintaining output diversity.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- vLLM 使用 Gumbel-max 技巧實現無損文字水印。
- 檢測器透過鑰匙與重複上下文驗證水印存在。
- 整合推測解碼與上下文去重以維持效能與多樣性。
提到的工具與公司
- vLLM
- Model Runner v2
- Philox
- PRF
適合誰看
正在開發或最佳化大型語言模型推理引擎、需要保護內容來源的技術人員。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.94
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- How Claude's Text Watermarking Works影片 ・ Sebastian Raschka ・ 48 分鐘
- How Claude Watermarks AI-Generated Text文章 ・ Sebastian Raschka(部落格)
- Exploring Speculative Decoding in vLLM on AMD GPUs文章 ・ vLLM Blog
- Is Speculative Decoding Worth It? Profiling vLLM on NVIDIA Blackwell — Akamai影片 ・ AI Engineer
- 大模型生成文本内容带水印影片 ・ 小工蚁创始人 ・ 7 分鐘
- 【闪客】如何判断文字是不是 AI 生成的?深入模型水印的秘密影片 ・ 飞天闪客 ・ 9 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)