【曲博股市科技EP308】資料中心的未來在於太空:Starcloud公司網站產品大解密
介紹 Starcloud 公司的太空資料中心產品,解析其如何利用軌道設施部署 NVIDIA H100 GPU 以推動人工智慧革命。內容涵蓋從設計原則到星雲系列產品的具體規格與應用前景。
※ 摘要僅根據標題與說明
依發布時間
介紹 Starcloud 公司的太空資料中心產品,解析其如何利用軌道設施部署 NVIDIA H100 GPU 以推動人工智慧革命。內容涵蓋從設計原則到星雲系列產品的具體規格與應用前景。
※ 摘要僅根據標題與說明
Simplismart 透過無程式碼平台讓企業快速部署自訂 AI 模型,專注於最佳化生成式 AI 的推理效能。內容介紹如何利用 NVIDIA GPU、TensorRT-LLM 及 NIM 微服務,針對不同場景(如語音代理、檔案解析)調整延…
探討將整個文庫置入大型語言模型上下文,利用注意力機制進行檢索的「情境檢索」技術。與需重新訓練的參數化檢索不同,此方法能更精確地還原文字,並解決長上下文中的注意力稀釋問題。
追蹤從手機按下傳送鍵到資料中心 GPU 的完整過程,解析大型語言模型如何透過矩陣運算與並行處理完成回答。觀眾能了解 Qwen3-8B 模型在 NVIDIA H100 上的實際運作機制與效能資料。
※ 摘要僅根據標題與說明
拆解 NVIDIA Rubin 晶片內部結構,從電路層級分析其運算核心與記憶體設計,並對比 H100 探討限制 AI 速度的關鍵因素。
※ 摘要僅根據標題與說明
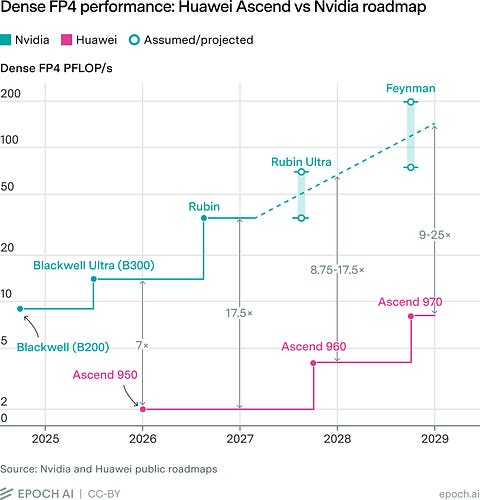
分析華為在 AI 晶片與算力上的發展路徑,指出受出口管制限制,其晶片效能與產量難以在 2030 年前追上輝達。即使達成所有技術目標,華為仍將落後約四年,主要瓶頸在於製程裝置、記憶體供應及軟體生態。
介紹將大型語言模型轉化為只輸出決策的「System One」模型技術,並透過實作 Qwen3-8B 玩 Doom 與 Wikiracing 遊戲,分享設定層級目標與賽局抽樣等實作技巧。
Cliff Weitzman 分享 Speechify 自購 Nvidia GPU 建立資料中心的策略,解釋為何自建比租機更划算且能加速模型訓練。
介紹 LFM2.5-DSpark 技術,透過結合 DFlash 架構與輕量 Markov 頭部,大幅降低大模型推論延遲。文章提供在 H100 GPU 與 M4 Max 裝置上的具體效能資料,並說明如何在 SGLang 與 llama.…
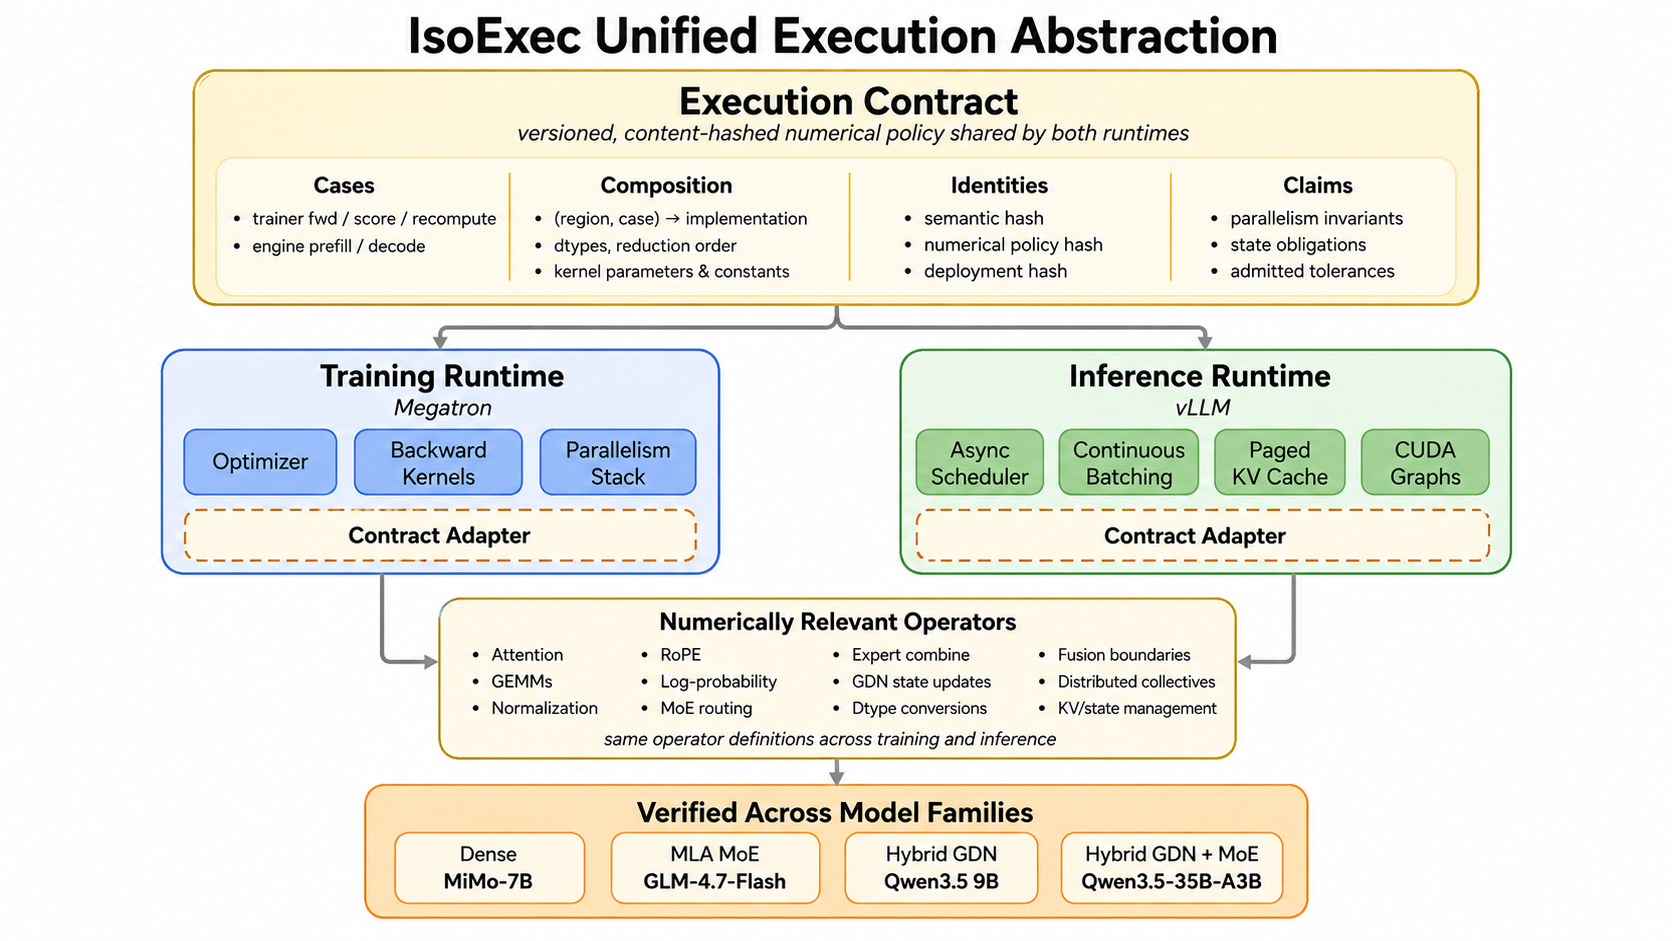
介紹 IsoExec,一種統一執行抽象,用於消除訓練與推論引擎間的浮點數不匹配問題。透過執行合約與位元一致的核心,確保 RL 訓練與推論使用相同策略時結果一致,降低除錯成本並提升系統穩定性。
Starcloud 執行長 Philip Johnston 分享公司如何先預訂 SpaceX 火箭再開發產品,並成功將 Nvidia H100 晶片送入太空執行。
深入探討推論工程如何將訓練好的模型轉化為高效、可靠且具規模的產品。內容涵蓋長問答處理中的 KV 快取路由、預解碼加速、量化最佳化、工具呼叫輸出約束等技術細節,並討論了持續學習與 KV 快取壓縮的未來方向。
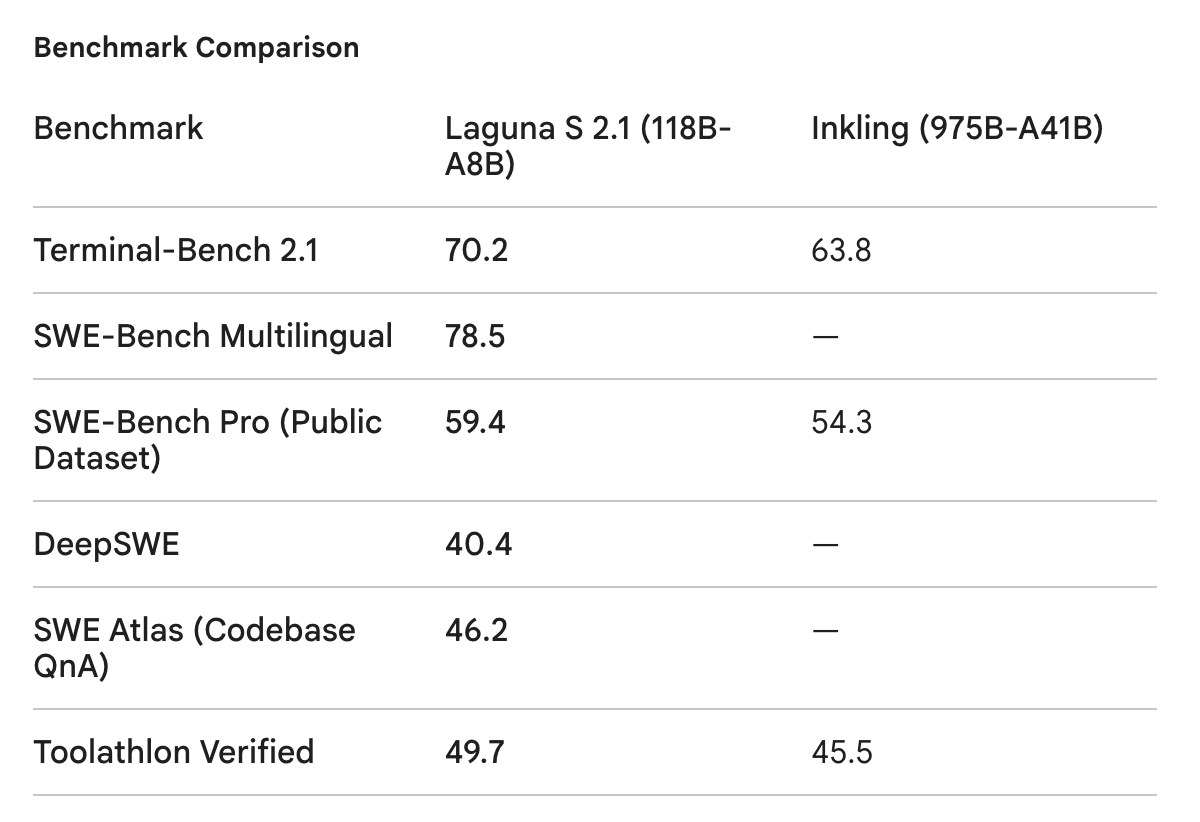
訪談 Eiso Kant 分享 Poolside AI 如何建立 Model Factory,在八週內將模型從預訓練到發布。內容涵蓋其十年研發歷程、為何轉向開放權重、Laguna S 2.1 的效能表現及團隊運作模式。
提出「支出地平線」指標,用於量化 AI 代理在最佳化任務上的能力,並透過 NanoGPT 速度挑戰的資料進行實證分析。文章估算人類最佳化每提升 1% 需約 2,500 美元人力成本,並比較 AI 代理的投入曲線與人類曲線交點。
介紹 Ericsson 與 Mistral 合作開發專為其 ASIC 晶片量身打造的自訂大型語言模型,解決資料稀缺問題並達成高準確度。看完能了解如何將模型導入生產環境以實現自主訓練。
※ 摘要僅根據標題與說明
訪談 Genesis Molecular AI 創辦人 Evan Feinberg 與 CTO Sergey Edunov,探討他們如何透過專注於小分子藥物發現中的蛋白質 - 配體相互作用,利用擴散模型達到亞埃級精度。
訪談 Dhruv Batra 與 Yutori 公司,探討為何多數網頁不會為 AI 代理提供 API,並介紹 Yutori Navigator 如何透過感知畫素與即時編寫 JavaScript 來執行任務。
Dan Fu 演講分享語言模型從訓練到推論的完整流程,重點在於如何將 GPU 轉化為實際的「智慧引擎」。內容涵蓋推論服務架構、最佳化 KV Cache 的策略,以及透過 Mega Kernels 技術減少 GPU 等待時間以提升效率。
Charles Frye 分享在生產環境部署 Transformer 模型的實戰經驗,涵蓋從應用架構到硬體選型的完整流程。內容包含如何最佳化推理效能、選擇適合的 GPU 硬體以及使用工具進行效能分析與除錯,幫助工程師解決大規模推理挑戰。
Modal 與 Anthropic 合作推出整合,讓 Claude Managed Agents 能在自託管的 Modal Sandbox 中執行工具呼叫。
分析 SGLang 在處理多模態模型時,因重複執行 GPU 記憶體共享書寫作業導致效能瓶頸。透過簡單的 Python 字典快取機制替代昂貴的重複呼叫,使吞吐量提升 16% 且延遲降低 10%。
透過 NanoGPT 速度挑戰賽的公開資料,分析 AI 代理在加速 AI 研發方面的實際貢獻與進展。作者分類了人類與 AI 提出的最佳化方案,指出雖然 AI 已參與部分最佳化,但深度創新仍多來自人類,並探討了如何利用此類挑戰作為評估基準。
介紹如何使用 Modal 平台配合 Autoresearch 工具,讓 AI 代理自動彈性調配 GPU 資源進行研究。透過簡單的 API 呼叫,代理能根據任務需求即時啟動或釋放多張 GPU,既避免資源浪費,又大幅提升實驗速度與效率。
Philip Johnston 解釋為何太空資料中心將成為未來十年 AI 運算的主要地點,分析地緣限制與太空能源成本優勢。內容涵蓋熱耗散物理原理、射線防護測試、以及太空運算如何重塑雲端架構與經濟模型。
Dylan Patel 深入剖析 AI 運算擴展的三大瓶頸:邏輯、記憶體與電力,並探討實驗室、超大型雲端廠商與晶圓廠的經濟動態。內容涵蓋 H100 價格走勢、記憶體供需壓力、機器人集中化運算趨勢,以及台灣在地化供應鏈風險。
解析為何傳統大型語言模型推理受記憶體牆限制,並探討 HBM、屋頂線模型及 vLLM 等最佳化技術。觀眾可了解記憶體與運算密集型任務的差異,以及擴散式模型如何改變工作負載。
※ 摘要僅根據標題與說明
探討 Gimlet Labs 如何透過異質運算架構,將 AI 工作負載分散於不同硬體以提升效能與成本效益。講者介紹了將模型拆解、使用 LLM 自動最佳化運算核心等技術,並討論了從邊緣裝置到資料中心的應用挑戰。
由助教王秀軒講解如何利用多張 GPU 訓練大型語言模型,從零開始介紹 DeepSpeed、Flash Attention、Liger Kernel 及量化技術。
依人氣
Starcloud 執行長 Philip Johnston 分享公司如何先預訂 SpaceX 火箭再開發產品,並成功將 Nvidia H100 晶片送入太空執行。
Simplismart 透過無程式碼平台讓企業快速部署自訂 AI 模型,專注於最佳化生成式 AI 的推理效能。內容介紹如何利用 NVIDIA GPU、TensorRT-LLM 及 NIM 微服務,針對不同場景(如語音代理、檔案解析)調整延…
Dylan Patel 深入剖析 AI 運算擴展的三大瓶頸:邏輯、記憶體與電力,並探討實驗室、超大型雲端廠商與晶圓廠的經濟動態。內容涵蓋 H100 價格走勢、記憶體供需壓力、機器人集中化運算趨勢,以及台灣在地化供應鏈風險。
介紹 Starcloud 公司的太空資料中心產品,解析其如何利用軌道設施部署 NVIDIA H100 GPU 以推動人工智慧革命。內容涵蓋從設計原則到星雲系列產品的具體規格與應用前景。
※ 摘要僅根據標題與說明
介紹將大型語言模型轉化為只輸出決策的「System One」模型技術,並透過實作 Qwen3-8B 玩 Doom 與 Wikiracing 遊戲,分享設定層級目標與賽局抽樣等實作技巧。
訪談 Eiso Kant 分享 Poolside AI 如何建立 Model Factory,在八週內將模型從預訓練到發布。內容涵蓋其十年研發歷程、為何轉向開放權重、Laguna S 2.1 的效能表現及團隊運作模式。
訪談 Genesis Molecular AI 創辦人 Evan Feinberg 與 CTO Sergey Edunov,探討他們如何透過專注於小分子藥物發現中的蛋白質 - 配體相互作用,利用擴散模型達到亞埃級精度。
深入探討推論工程如何將訓練好的模型轉化為高效、可靠且具規模的產品。內容涵蓋長問答處理中的 KV 快取路由、預解碼加速、量化最佳化、工具呼叫輸出約束等技術細節,並討論了持續學習與 KV 快取壓縮的未來方向。
Philip Johnston 解釋為何太空資料中心將成為未來十年 AI 運算的主要地點,分析地緣限制與太空能源成本優勢。內容涵蓋熱耗散物理原理、射線防護測試、以及太空運算如何重塑雲端架構與經濟模型。
拆解 NVIDIA Rubin 晶片內部結構,從電路層級分析其運算核心與記憶體設計,並對比 H100 探討限制 AI 速度的關鍵因素。
※ 摘要僅根據標題與說明