文章高階EN
From DeepSeek V3 to V3.2: Architecture, Sparse Attention, and RL Updates
讀原文(在新分頁開啟原站)連到 Sebastian Raschka(部落格)
摘要
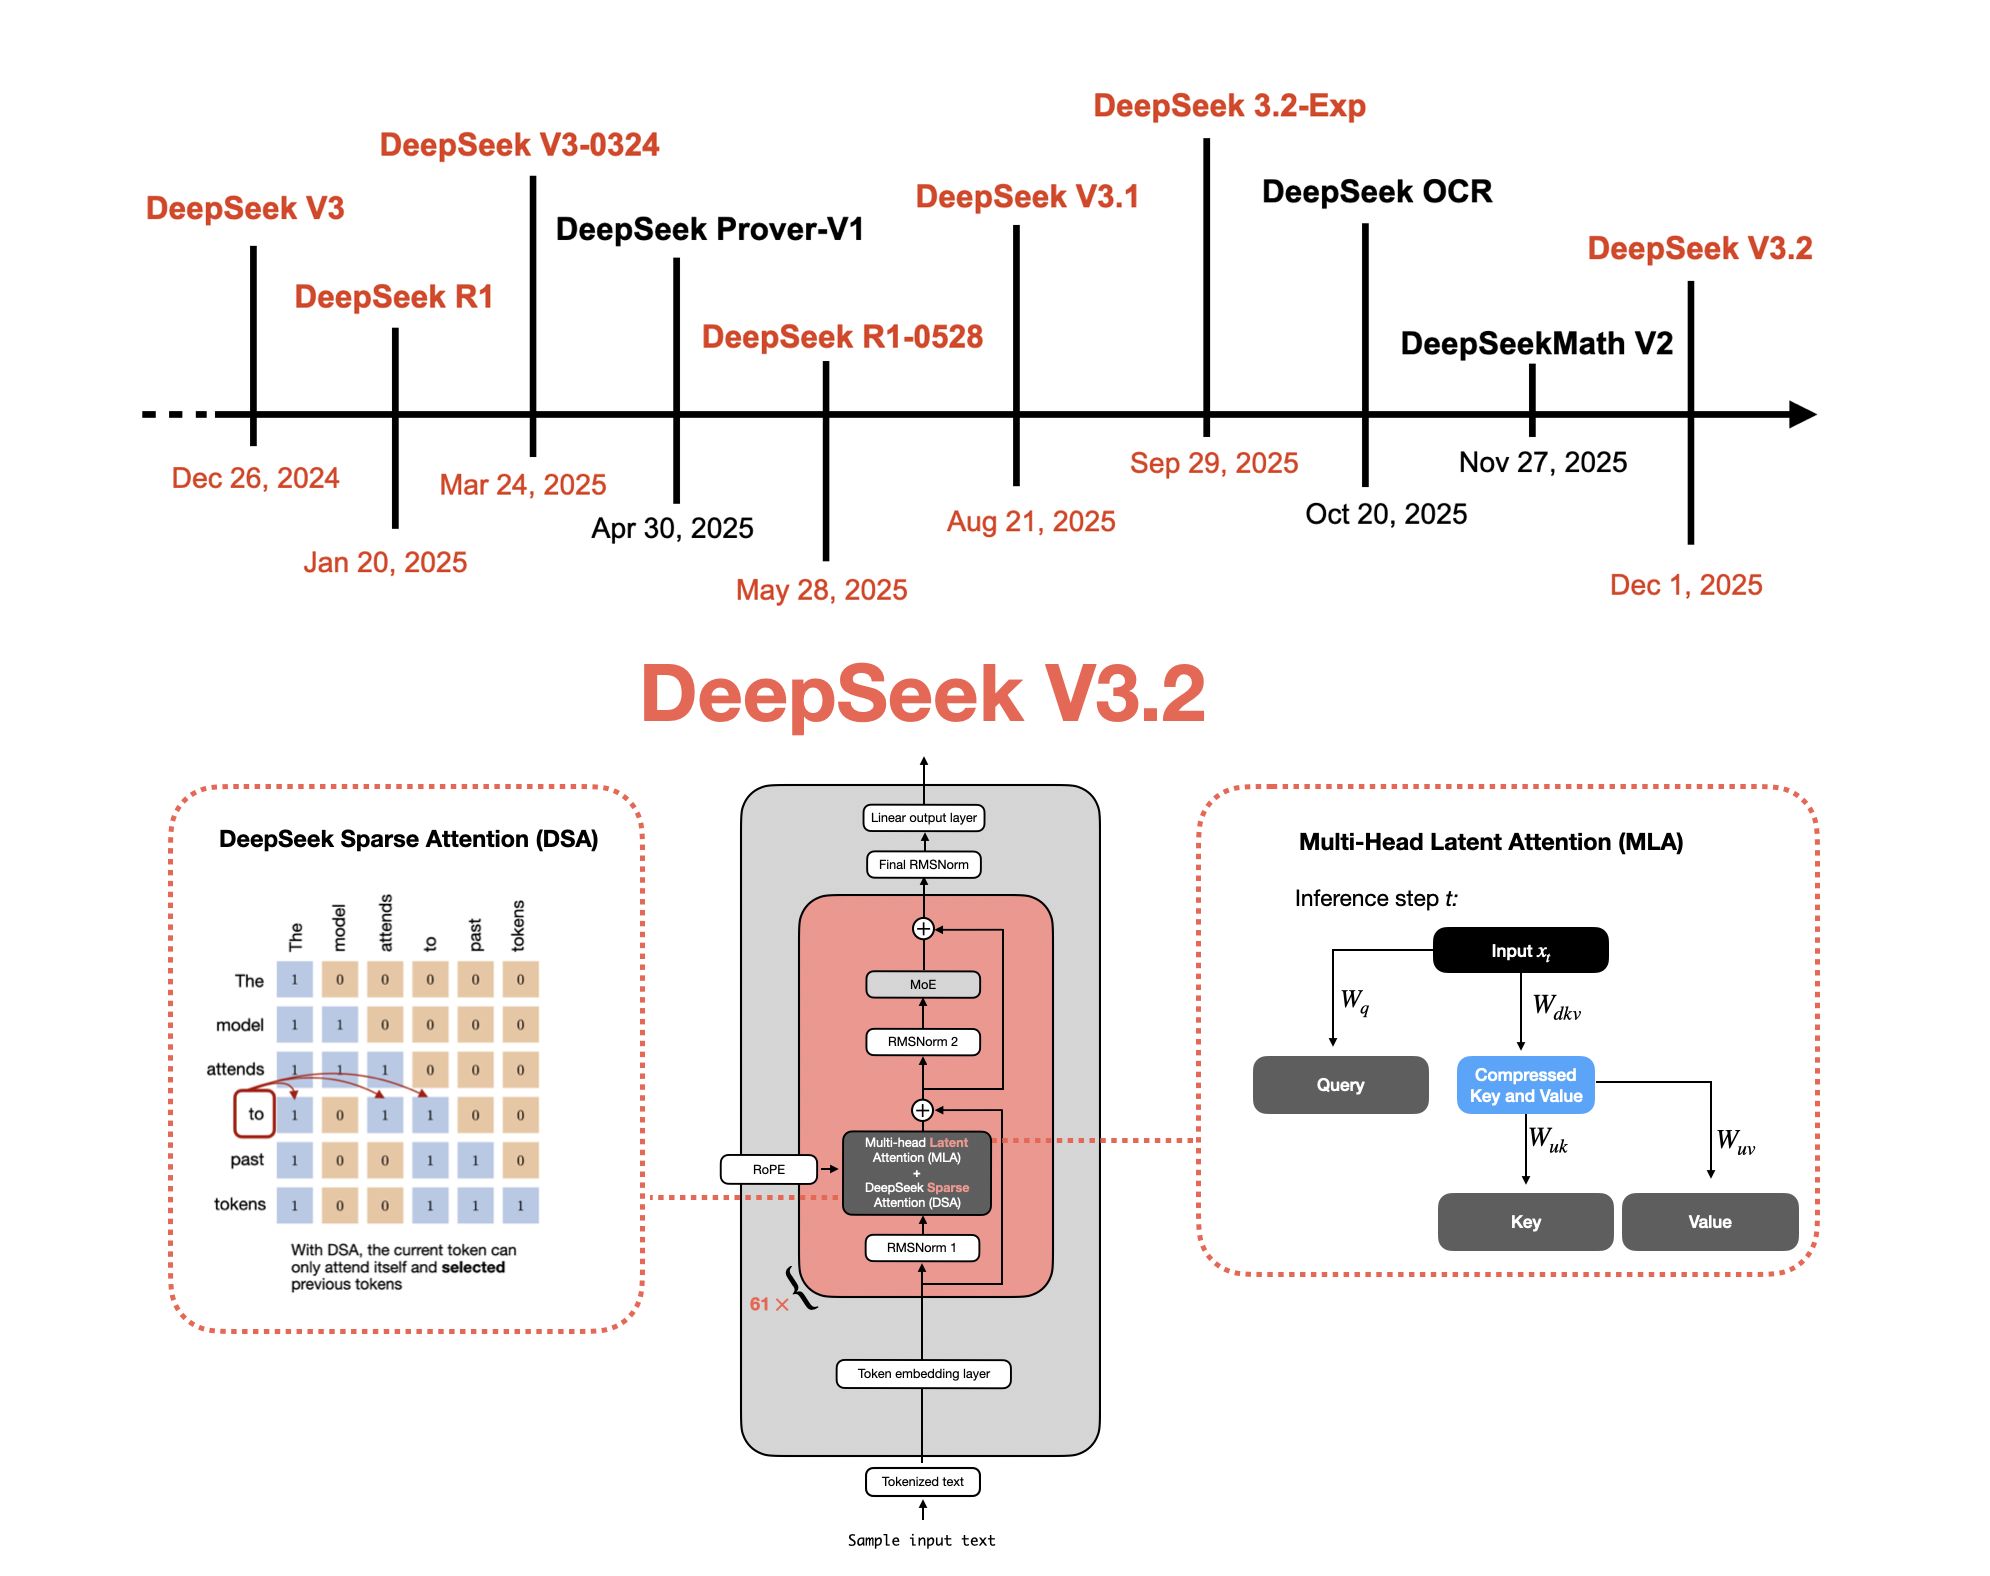
這篇文章詳細介紹了 DeepSeek 的 V3.2 模型,包括其稀疏注意力機制、混合推理架構以及針對數學問題的自驗證訓練方法。作者分析了從 V3 到 V3.2 的演進,並探討了 GRPO 最佳化與自反思技術如何提升模型推理能力。
This article details DeepSeek's V3.2 model, covering its sparse attention mechanism, hybrid reasoning architecture, and self-verification training methods for math tasks. It analyzes the evolution from V3 and explores GRPO optimizations and self-refinement techniques to enhance reasoning performance…
重點
- V3.2 引入稀疏注意力以節省記憶體並提升效率。
- 採用混合推理架構,允許切換推理與對話模式。
- 針對數學問題採用自驗證機制,確保邏輯正確性。
提到的工具與公司
- DeepSeek V3.2
- GRPO
- RLHF
- MoE
適合誰看
對大語言模型架構、稀疏注意力機制及 RLHF 技術感興趣的程式開發者與 AI 研究者。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.31
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- GRPO - Group Relative Policy Optimization - How DeepSeek trains reasoning models影片 ・ Luis Serrano Academy ・ 22 分鐘(在新分頁開啟原站)
- 163: 详解DeepSeekV4:Infra巨鲸、百万上下文走进现实、极致效率优化Podcast ・ 晚点聊 LateTalk ・ 1 小時 34 分(在新分頁開啟原站)
- 94. 逐篇讲解DeepSeek、Kimi、MiniMax注意力机制新论文——“硬件上的暴力美学”Podcast ・ 张小珺Jùn|商业访谈录 ・ 2 小時 36 分(在新分頁開啟原站)
- [GRPO Explained] DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models影片 ・ Yannic Kilcher ・ 1 小時 9 分(在新分頁開啟原站)
- not much happened today文章 ・ AINews(Latent Space/smol.ai)
- 【生成式AI時代下的機器學習(2025)】第七講:DeepSeek-R1 這類大型語言模型是如何進行「深度思考」(Reasoning)的?影片 ・ Hung-yi Lee ・ 1 小時 18 分(在新分頁開啟原站)
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)