Stanford CME295 Transformers & LLMs | Autumn 2026 | Lecture 1 - Transformers(在新分頁開啟原站)
本影片為 Stanford CME295 秋季 2026 年課程的第一講,由 Adjunct Professor Afshine Amidi 與 Shervine Amidi 共同主持。
18.1 萬次觀看
※ 摘要僅根據標題與說明
Transformers ・ 29 筆內容
注意力機制與 Transformer 架構,現代語言模型的基礎。
也叫做:transformer、transformers、注意力機制、attention、self-attention、自注意力、位置編碼
依相關、人氣、新鮮度綜合排序;站長推薦的加成
本影片為 Stanford CME295 秋季 2026 年課程的第一講,由 Adjunct Professor Afshine Amidi 與 Shervine Amidi 共同主持。
※ 摘要僅根據標題與說明
Stanford CS25 課程介紹了從語言模型到原生多模態智慧的演進,內容涵蓋了 Transformer 架構的演變與應用。
※ 摘要僅根據標題與說明
Stanford CS229 春季 2026 課程第 14 課介紹 Transformer 架構與上下文學習,探討如何讓模型在少量資料下快速理解複雜任務。
※ 摘要僅根據標題與說明
Stanford CS25 課程介紹了 Transformer V6 模型如何高效執行,並分享實戰經驗。
※ 摘要僅根據標題與說明
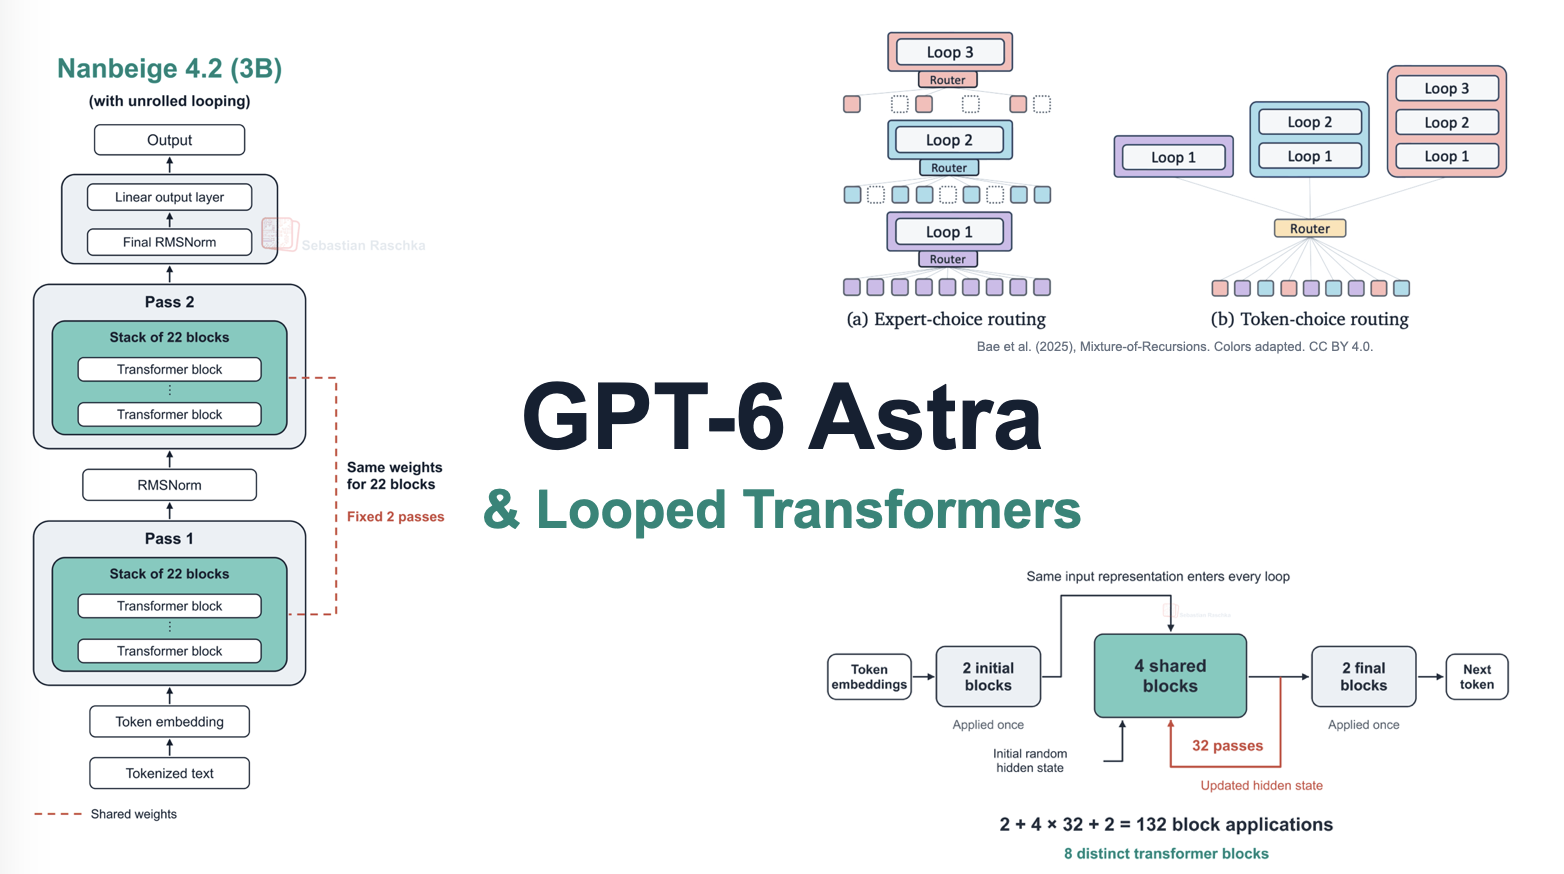
探討了 OpenAI 的 GPT-6 Astra 模型,特別是其優異的電腦使用能力與可能使用的「迴圈轉譯器」架構。文章指出,迴圈轉譯器能在固定計算預算下提升模型效能,並引用最新研究探討迴圈機制如何影響推理過程。
本講探討生成式 AI 時代下,Transformer 模型是否面臨被淘汰的危機。
※ 摘要僅根據標題與說明
探討 Transformer 模型中位置資訊的三種主要方式:絕對位置、相對位置、RoPE,以及為何要移除位置嵌入。
※ 摘要僅根據標題與說明
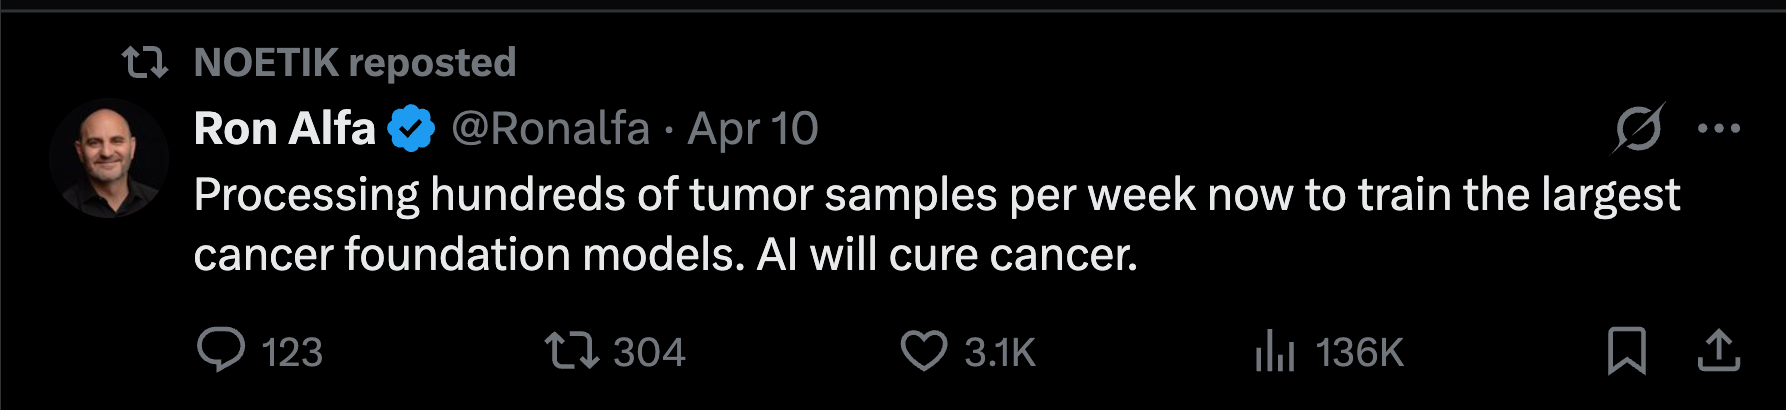
Noetik 的 Ron Alfa 與 Daniel Bear 探討如何利用 AI 解決癌症臨床試驗失敗率高的問題。他們認為透過精準匹配患者與治療方案,可大幅提升成功率。
※ 摘要僅根據標題與說明
依發布時間
本影片為 Stanford CME295 秋季 2026 年課程的第一講,由 Adjunct Professor Afshine Amidi 與 Shervine Amidi 共同主持。
※ 摘要僅根據標題與說明
介紹 OpenAI 提出的 Astra 架構,探討其迴圈深度如何作為大模型第三條 Scaling 法則,並分析其技術原理與潛在影響。
※ 摘要僅根據標題與說明
探討了 OpenAI 的 GPT-6 Astra 模型,特別是其優異的電腦使用能力與可能使用的「迴圈轉譯器」架構。文章指出,迴圈轉譯器能在固定計算預算下提升模型效能,並引用最新研究探討迴圈機制如何影響推理過程。
介紹了 NeoMME,一個雙語雙模態基礎編碼器,採用單一 Transformer 架構處理文字與圖片。它不使用預訓練的視覺塔或因果語言模型,而是從頭訓練,並使用掩碼離散擴散目標。
本集播客由孫宇領讀 Kimi K3 技術報告,該報告提出沿序列、深度與寬度三個維度擴充套件的 MoE 架構。報告指出 K3 透過將注意力機制從 token 切分為值域桶並進行統計,實現了高效擴充套件,同時採用全量訓練以確保訓練穩定性與相容…
介紹如何使用 Sentence Transformers 訓練和微調多向量嵌入模型,以實現類似 ColBERT 的晚互動檢索。
介紹了基於 Sentence Transformers 的「多向量(Late Interaction)」嵌入模型,如 LightOn 的 LateOn 和 mLateOn。
Stanford CS229 春季 2026 課程第 14 課介紹 Transformer 架構與上下文學習,探討如何讓模型在少量資料下快速理解複雜任務。
※ 摘要僅根據標題與說明
探討了 Kimi K3 的發布如何重新定義中國開放權重模型的邊界,並指出其效能已接近前沿水平。文章強調 K3 的優勢不再僅依賴計算資源,而是轉向高效能架構、量化技術以及針對特定任務的資料策展與堆疊策略。
Moonshot AI 推出 Kimi K3,這是一款擁有 2.8 兆引數的頂級開放權重模型,支援多模態輸入與原生多模態輸出。
Stanford CS25 課程介紹了從語言模型到原生多模態智慧的演進,內容涵蓋了 Transformer 架構的演變與應用。
※ 摘要僅根據標題與說明
Stanford CS25 課程介紹了 Transformer V6 模型如何高效執行,並分享實戰經驗。
※ 摘要僅根據標題與說明