讀原文(在新分頁開啟原站)連到 Shrivu Shankar(Shrivu's Substack)
摘要
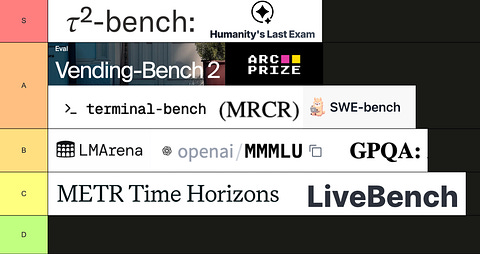
深入解析 AI 評測指標的運作機制與常見誤區,說明模型分數受設定、工具與評分方式影響極大。作者分析多個熱門評測(如 SWE-Bench、LMArena),指出其潛在偏差與侷限,教導讀者如何更客觀地評估模型真實能力。
This article demystifies AI benchmarks by exposing their flaws and offering a practical guide to evaluating models effectively.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 評測分數受設定、工具與評分方式影響,不可直接比較。
- 許多評測存在測試錯誤、資料汙染或忽略實際效能等問題。
- 最可靠的評估方式是自行在實際工作環境中測試模型。
提到的工具與公司
- SWE-Bench
- LMArena
- Tau2-Bench
- ARC-AGI-2
- LiveBench
- RE-Bench
適合誰看
正在評估或選擇 AI 模型以解決實際問題的開發者與技術決策者。
摘要依據
- 講者
- Shrivu Shankar
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.75
- 新鮮
- 0.33
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- No.94 不服跑个分,AI Benchmark 指标如何解读?Podcast ・ Web Worker-AI程序员都爱听 ・ 1 小時 5 分
- AI Evals: Everything You Need to Know文章 ・ Hamel Husain(部落格)
- 【闪客】大模型的分数是咋测出来的?深入拆解 Benchmark 背后的秘密影片 ・ 飞天闪客 ・ 11 分鐘
- Evaluating the Effectiveness of LLM-Evaluators (aka LLM-as-Judge)文章 ・ Eugene Yan(部落格)
- Using LLM-as-a-Judge For Evaluation: A Complete Guide文章 ・ Hamel Husain(部落格)
- 【生成式AI時代下的機器學習(2025)】第九講:你這麽認這個評分系統幹什麽啊?談談有關大型語言模型評估的幾件事影片 ・ Hung-yi Lee ・ 24 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)