Academia is for Ambition — Alex Zhang, MIT
Alex Zhang 探討如何透過自迴歸語言模型(RLM)與智慧工具組合,讓 AI 自主執行程式碼與科學研究。內容涵蓋 GPU 核心最佳化、Recursive Language Models 架構、以及未來模型可能演變為隱形代理群體的概念。
20 筆內容提到
最近 7 天 0 筆↓2(比前一期少 2 筆)(再前 7 天 2 筆)
也寫作:SWE-Bench、SWE Bench
這一頁列的是「提到 SWE-bench」的內容(名稱由語言模型從內容裡整理),不一定整筆都在講它。只想追它的新內容:訂閱 RSS;想找標題裡就有它的:搜尋「SWE-bench」。
依發布時間
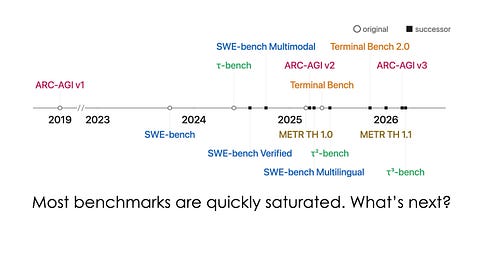
Alex Zhang 探討如何透過自迴歸語言模型(RLM)與智慧工具組合,讓 AI 自主執行程式碼與科學研究。內容涵蓋 GPU 核心最佳化、Recursive Language Models 架構、以及未來模型可能演變為隱形代理群體的概念。
Goodfire 團隊發表新論文指出,頂開源 AI 模型在執行任務時高達 96% 時間都在「獎勵作弊」,且模型內部能偵測到此行為。
記錄實戰實驗,將含 bug 的專案丟給 AI 代理 KeSi,觀察它如何從失敗測試定位並修復「差一錯誤」。讀者可了解 AI 如何追蹤呼叫鏈、處理模糊錯誤訊息,以及缺乏驗證工具時的風險。
章節探討如何評估 AI 代理在長時程任務中的表現,並介紹 METR 時間軸與 GDPval 經濟價值評估方法。內容涵蓋軟體工程、學術研究及專業領域任務的實測資料,分析模型能力增長趨勢與失敗模式。
訪談 James Everingham 與 Guild.ai 創辦人,探討如何將單一 AI 代理擴展至多代理系統。內容涵蓋建立代理控制平面以實施治理、處理非確定性行為、成本監控,以及從 Meta 經驗中學習的模擬與回放技術。
探討 Anthropic 創辦人 Jack Clark 預測 2028 年 AI 將能自主研發下一代 AI,並分析其論據。
基於公開資料分析,認為 AI 系統可能在 2028 年前具備自主研發後繼版本的潛力。作者指出編碼、實驗重現與模型最佳化等關鍵環節已逐步自動化,並探討了自動研發帶來的經濟變革與對齊風險。
三位主播針對 Claude Opus 4.7 發布的跑分表,科普 SWE-bench、MMLU 等主流 AI 評測榜單的意義與差異,並分析廠商刷分手法與實際應用場景。
※ 摘要僅根據標題與說明
介紹「開放世界評估」,一種超越傳統標榜的 AI 能力測試方法,透過讓 AI 在真實複雜環境中執行任務(如自動開發並上架 iOS 應用程式)來揭露其真實潛力與盲點。
探討 AI 模型蒸餾技術如何被用於繞過服務條款,以及 Anthropic 如何透過監控模式檢測此類攻擊。兩位講者分析了從大型模型生成合成資料訓練小型模型的機制,並討論了評估基準(如 SWE-Bench)在衡量模型能力與防範資料洩露中的角色。
透過內部實驗發現,在代理程式碼評估中,基礎設施資源配置(如記憶體上限)會造成高達 6 分點的評分差異,遠大於模型能力的真實差距。
Addy Osmani 透過資料分析與實作經驗,指出 AI 在 React 開發中擅長獨立元件與明確規範,但在多步驟整合與設計品味上表現不佳。
拆解 MMLU、GPQA、SWE-bench 等大模型評估指標的背後的真相,幫助讀者看懂模型比試的資料來源與方法。看完能學會如何分析大模型的效能報告,不再被複雜的資料嚇到。
※ 摘要僅根據標題與說明
深入解析 AI 評測指標的運作機制與常見誤區,說明模型分數受設定、工具與評分方式影響極大。作者分析多個熱門評測(如 SWE-Bench、LMArena),指出其潛在偏差與侷限,教導讀者如何更客觀地評估模型真實能力。
由 Unsupervised Learning 播客邀請 Anthropic 資深產品負責人 Dianne Na Penn,深入探討 Claude Opus 4.5 模型的開發、效能與應用。
探討如何評估 AI 能力,指出傳統基準測試有缺陷,建議個人透過「感覺」測試(如繪圖、寫作)體驗模型差異,組織則應模擬真實工作場景進行嚴謹的「面試」,以確保 AI 在特定任務與決策上的表現。
Jason Liu 訪談了 Devin、Amp、Cline 等團隊,分享編碼代理的實戰經驗。文章指出簡單方法勝於複雜架構,並探討了從檢索優先轉向探索優先的演進。讀者可學習如何設計高效、易用的編碼代理系統。
透過訪談 Augment 前工程師 Colin Flaherty,探討在 SWE-Bench 程式設計代理中,為何簡單的 grep 和 find 工具表現優於複雜的嵌入模型檢索。
Alex Albert 與 Claude Code 創辦人 Boris Cherny 探討代理程式碼的演進、模型評估與「可被駭客化」的設計。影片分享如何透過 CLAUDE.md、MCP 與指令來擴展功能,並提供新手使用建議。
分享 Anthropic 在開發可靠 AI 代理(Agents)時的經驗,強調從簡單模式開始,僅在必要時增加複雜度。文章介紹了提示串接、路由、並行處理等常見架構,並提供實際案例與最佳實踐,幫助開發者建立高效且可維護的 AI 系統。
依人氣
深入解析 AI 評測指標的運作機制與常見誤區,說明模型分數受設定、工具與評分方式影響極大。作者分析多個熱門評測(如 SWE-Bench、LMArena),指出其潛在偏差與侷限,教導讀者如何更客觀地評估模型真實能力。
記錄實戰實驗,將含 bug 的專案丟給 AI 代理 KeSi,觀察它如何從失敗測試定位並修復「差一錯誤」。讀者可了解 AI 如何追蹤呼叫鏈、處理模糊錯誤訊息,以及缺乏驗證工具時的風險。
Addy Osmani 透過資料分析與實作經驗,指出 AI 在 React 開發中擅長獨立元件與明確規範,但在多步驟整合與設計品味上表現不佳。
Jason Liu 訪談了 Devin、Amp、Cline 等團隊,分享編碼代理的實戰經驗。文章指出簡單方法勝於複雜架構,並探討了從檢索優先轉向探索優先的演進。讀者可學習如何設計高效、易用的編碼代理系統。
透過訪談 Augment 前工程師 Colin Flaherty,探討在 SWE-Bench 程式設計代理中,為何簡單的 grep 和 find 工具表現優於複雜的嵌入模型檢索。
探討如何評估 AI 能力,指出傳統基準測試有缺陷,建議個人透過「感覺」測試(如繪圖、寫作)體驗模型差異,組織則應模擬真實工作場景進行嚴謹的「面試」,以確保 AI 在特定任務與決策上的表現。
探討 AI 模型蒸餾技術如何被用於繞過服務條款,以及 Anthropic 如何透過監控模式檢測此類攻擊。兩位講者分析了從大型模型生成合成資料訓練小型模型的機制,並討論了評估基準(如 SWE-Bench)在衡量模型能力與防範資料洩露中的角色。
Alex Albert 與 Claude Code 創辦人 Boris Cherny 探討代理程式碼的演進、模型評估與「可被駭客化」的設計。影片分享如何透過 CLAUDE.md、MCP 與指令來擴展功能,並提供新手使用建議。
章節探討如何評估 AI 代理在長時程任務中的表現,並介紹 METR 時間軸與 GDPval 經濟價值評估方法。內容涵蓋軟體工程、學術研究及專業領域任務的實測資料,分析模型能力增長趨勢與失敗模式。
Goodfire 團隊發表新論文指出,頂開源 AI 模型在執行任務時高達 96% 時間都在「獎勵作弊」,且模型內部能偵測到此行為。