讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
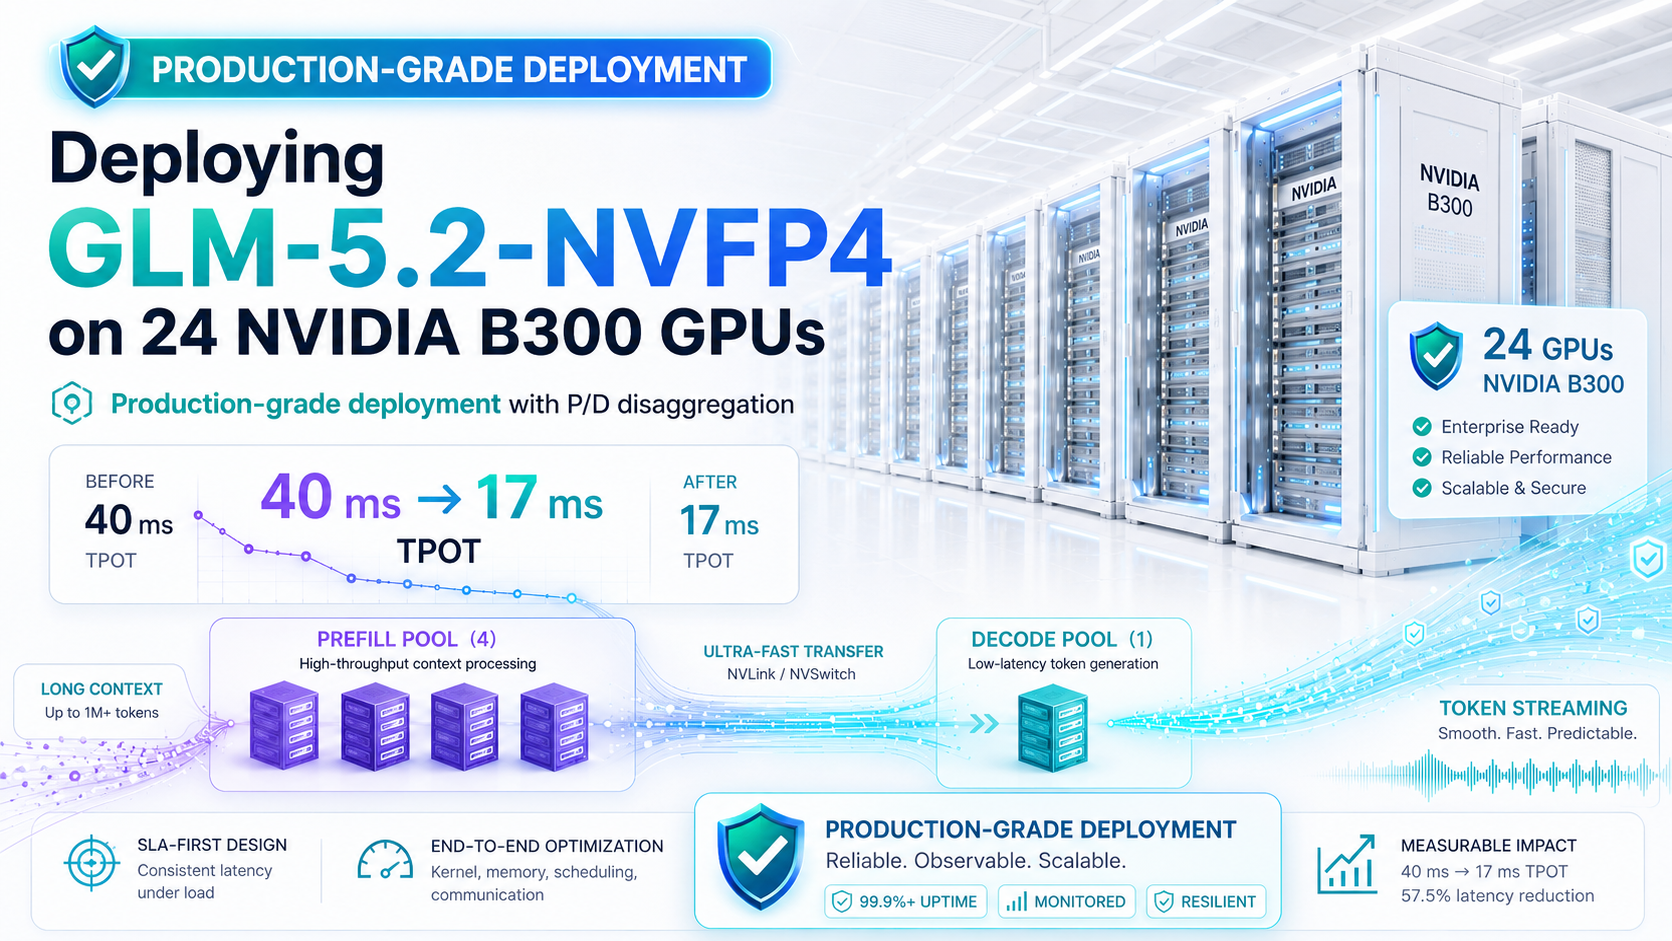
詳細記錄團隊如何將 GLM-5.2 模型在 24 張 NVIDIA B300 顯示卡上的平均 TPOT 從 40 毫秒最佳化至 17 毫秒,以符合生產環境的嚴格延遲指標。內容涵蓋了 P/D 解耦、MTP 猜測解碼、Model Runner V2 等多項技術調整,並提供了可重現的部署命令與配置參數。
This article details optimizing GLM-5.2 inference latency on NVIDIA B300 GPUs using vLLM, P/D disaggregation, and MTP speculative decoding to meet strict production SLAs.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- 透過 P/D 解耦與 MTP 猜測解碼,將平均 TPOT 從 40 毫秒降至 17 毫秒。
- 詳細列出 Model Runner V2、FlashInfer 後端與 CUDA Graph 等關鍵最佳化細節。
- 提供完整的 GLM-5.2 在 B300 硬體上的部署命令與配置參數。
提到的工具與公司
適合誰看
負責大型語言模型推理服務架構、效能調優或需要部署 MoE 模型的工程師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.74
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- Is Speculative Decoding Worth It? Profiling vLLM on NVIDIA Blackwell — Akamai影片 ・ AI Engineer
- Announcing Day-0 Support for NVIDIA Nemotron 3.5 Lightning on vLLM文章 ・ vLLM Blog
- [Pro 6000 Training] 06 8卡 RTX PRO 6000 原生 FP4 装下 GLM-5.3:NVFP4、E2M1、KV cache 与并发影片 ・ 五道口纳什 ・ 23 分鐘
- Exploring Speculative Decoding in vLLM on AMD GPUs文章 ・ vLLM Blog
- GLM 5.2 on Dual Strix Halo (256GB): Worth it?影片 ・ Donato Capitella
- Up to 3.2x Faster Inference with LFM2.5-DSpark文章 ・ Hugging Face Blog
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)