讀原文(在新分頁開啟原站)連到 vLLM Blog
摘要
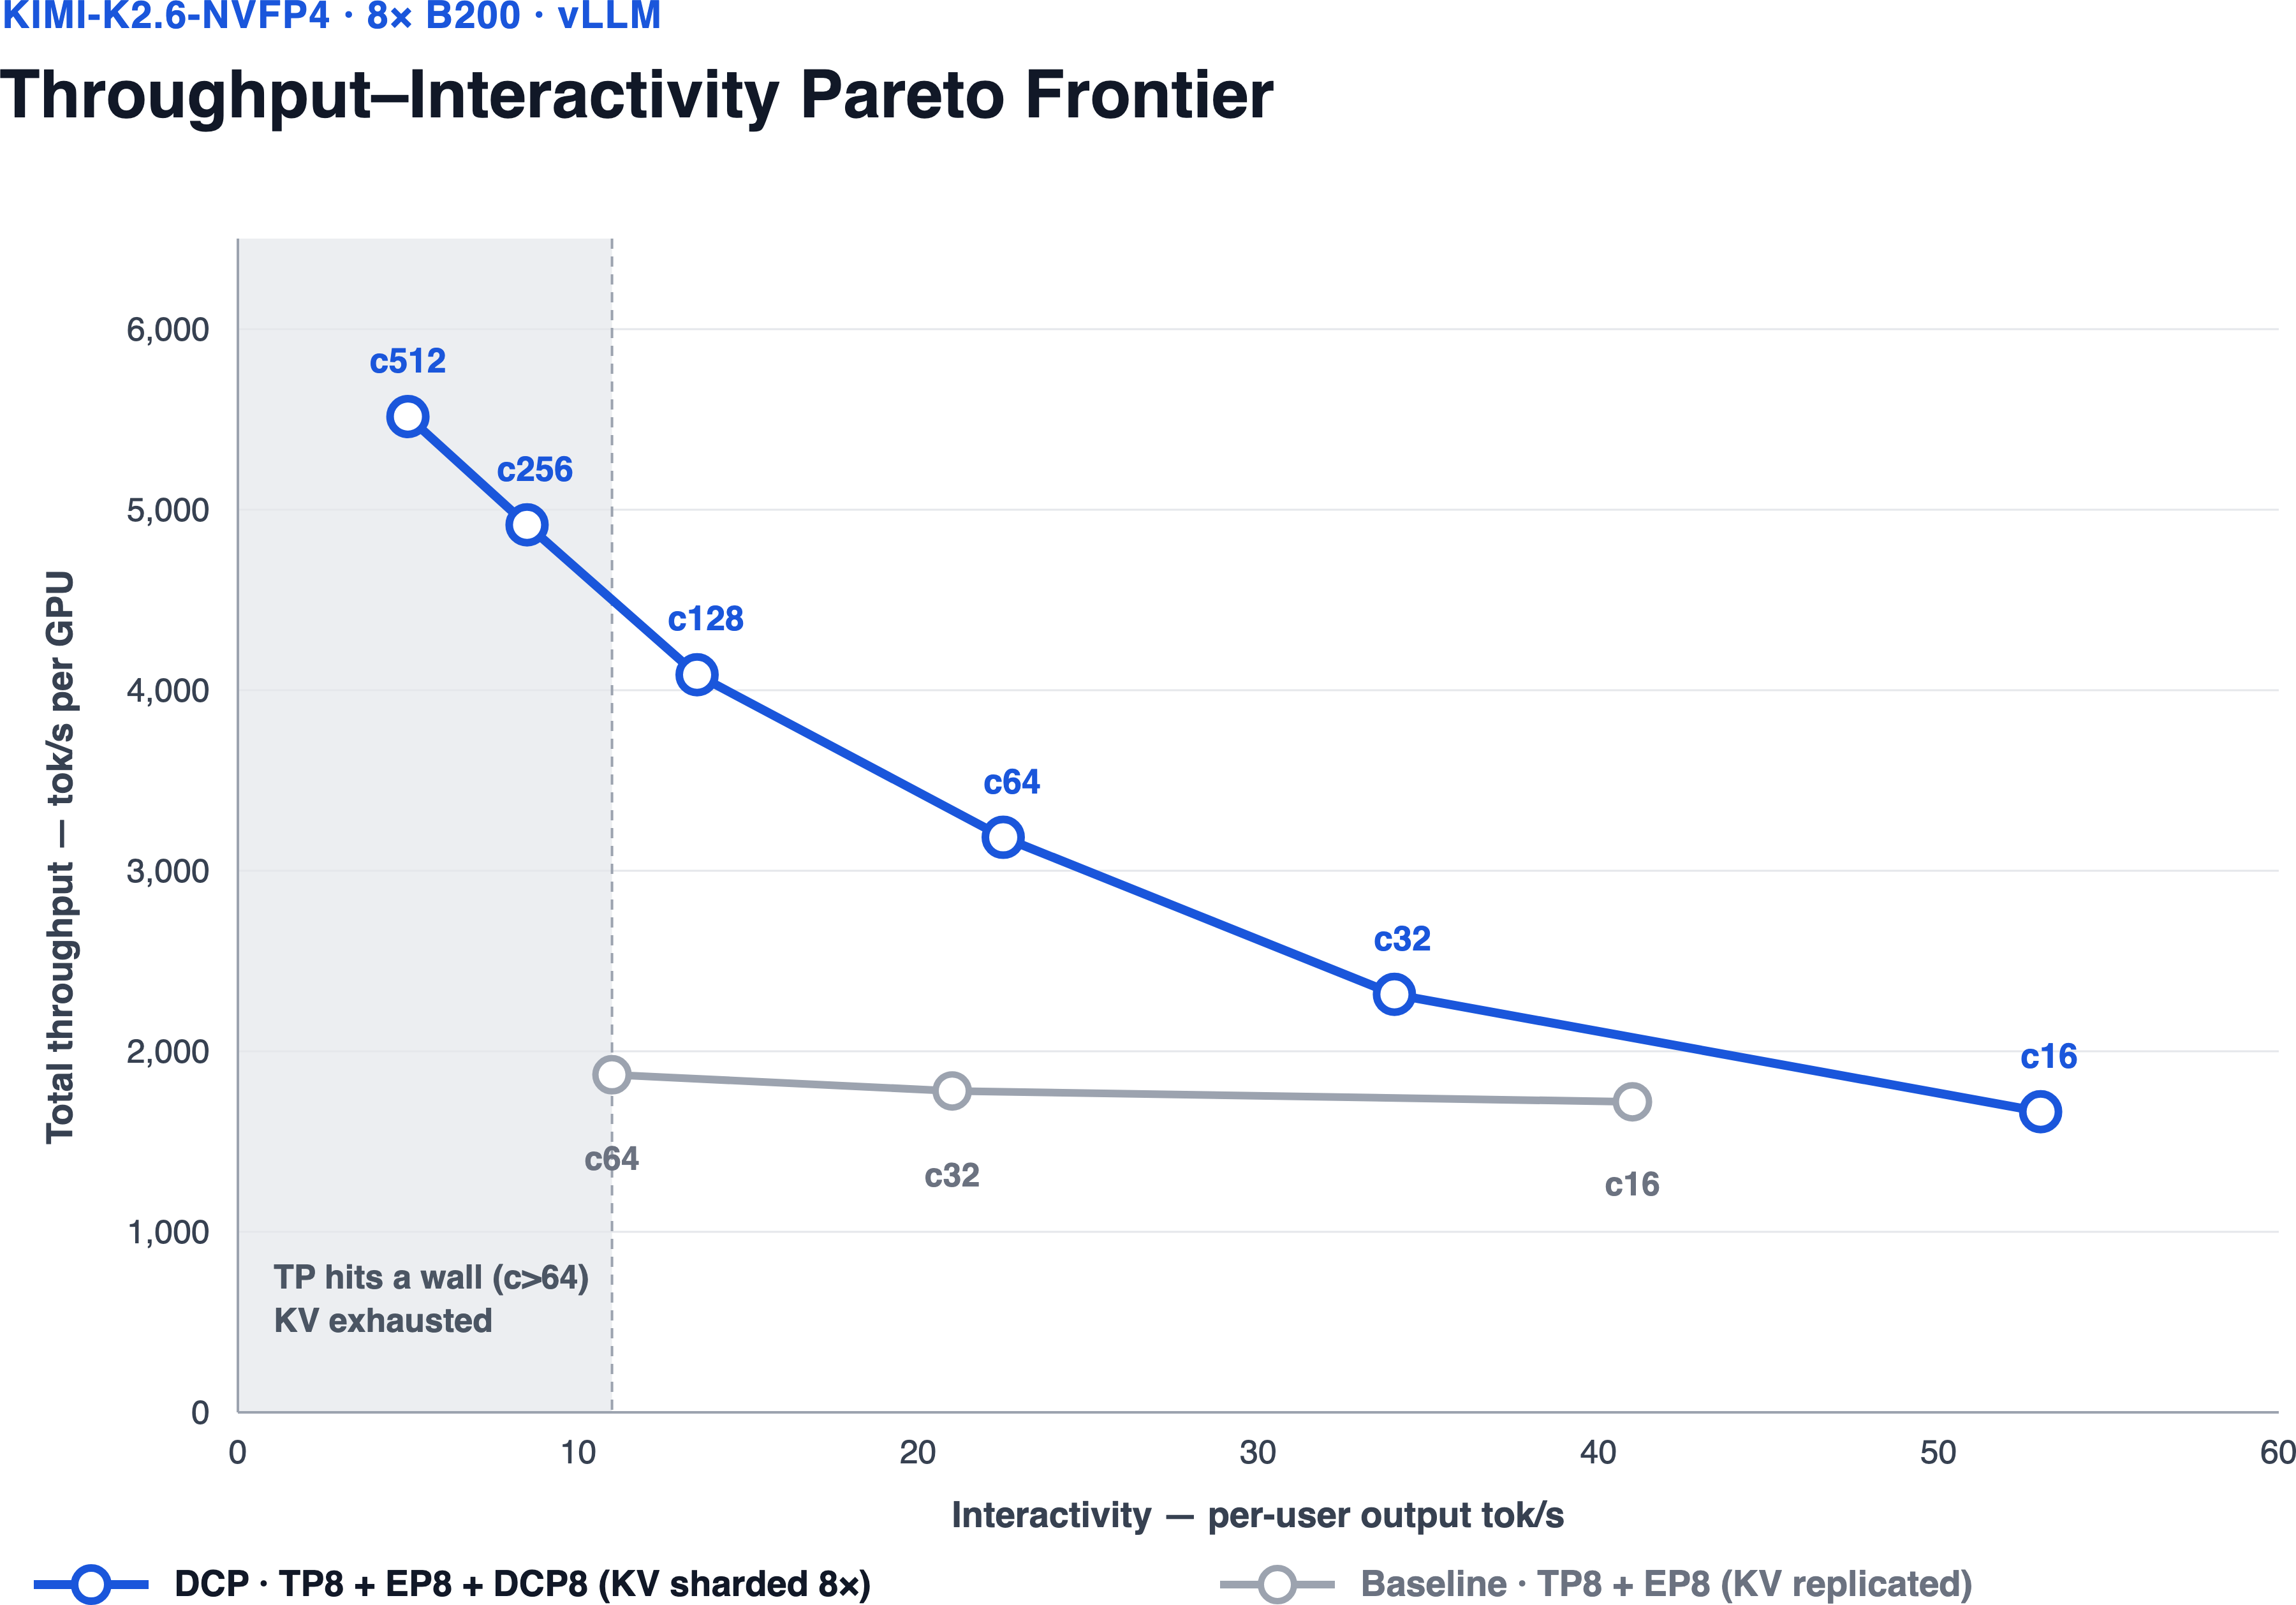
vLLM 推出 Decode Context Parallelism (DCP),透過將 KV Cache 按序列維度分片,解決長上下文推理時記憶體不足的問題。相比傳統張量並行,DCP 能大幅提升高併發下的吞吐量,支援如 Kimi K2.6 等模型處理百萬級 token 的長上下文任務。
vLLM introduces Decode Context Parallelism to enable high-throughput long-context inference by sharding KV cache across GPUs.
摘要、重點與章節標題由語言模型整理,細節(誰說的、數字、先後)可能有誤;要引用請以原始內容為準。
重點
- DCP 將 KV Cache 按序列分片,解決長上下文推理記憶體上限問題。
- 相比傳統張量並行,DCP 在高併發下能維持更高吞吐量。
- 支援 MLA 與 GQA 模型,透過簡單通訊模式實現高效能。
提到的工具與公司
- vLLM
- NVIDIA B200
- Kimi K2.6
- NVFP4
- DeepSeek-V2
- Qwen3-235B
適合誰看
正在開發或部署需要處理長上下文、高併發 AI 代理應用或大規模模型推理的工程師與架構師。
摘要依據
- 依據
- 文章全文
為什麼排在這裡
- 人氣
- 0.50
- 新鮮
- 0.78
在主題頁與搜尋結果裡,名次由相關、人氣、新鮮三個分數決定;這一頁沒有搜尋的關鍵字,所以沒有相關分數。排序怎麼算
相關內容
- [LLM Architect] 09 深入理解和对比 prefill与decode | kv-cache | 并行-串行 | GEMM-GEMV | 算力-带宽影片 ・ 五道口纳什 ・ 34 分鐘
- How AI Models Scale Beyond a Single GPU Across LLM Workloads影片 ・ IBM Technology ・ 9 分鐘
- Kimi K3 Performance Optimizations in vLLM: The Road to 2.8× Throughput文章 ・ vLLM Blog
- Tiered KV Cache Offloading in vLLM文章 ・ vLLM Blog
- 理解 KV Cache 与 Prompt Caching:LLM 推理加速的核心机制文章 ・ chaofa用代码打点酱油(袁朝发)
- Jongryool Kim - Disaggregated LLM Serving with Shared Memory KV Cache at Rack Scale影片 ・ Berkeley RDI ・ 5 分鐘
摘要由 AI 根據原文產生,可能有誤;完整內容請看原站。讀原文(在新分頁開啟原站)